統計グラフ 61 種 · 12 カテゴリ · 100% Python
社会データサイエンスを、
美しく Python で。
実際の社会科学データにもとづき、答える問いごとに整理した Python の統計グラフ集です。モデルの予測精度とその理由を示す機械学習、地図と空間的自己相関を扱う空間データを、分布、グループ比較、回帰、生存分析と並べて収録し、すべての図に推定値、信頼区間、検定、効果量といった根拠となる統計量を示します。
多くの Python 教材は、まずコードを教え、問いは後回しにします。このギャラリーはその逆です。もともとは社会科学を学ぶ学生のために作られましたが、自分の分野をよく知り、答えるべき問いを持つすべての人に役立ちます。これらのグループに差はあるか、2 つの変数は連動しているか、モデルはなぜこう予測したのか。問いから出発し、それに答えるグラフを見つけ、示された統計量を読み取り、必要なコードだけを持ち帰ってください。
検索に一致するグラフはありません。「回帰」「調査」「信頼区間」や R の関数名で試してください。
機械学習
モデルは新しいデータをどれだけうまく予測できるのか、そしてなぜか。交差検証による評価、学習曲線、モデルに依存しない説明を、それぞれの不確実性とともに示します。

指標付き混同行列
1996 年にドールに投票した人をロジスティック回帰がどれだけ当てられるか。件数と行ごとの割合を示す交差検証の混同行列に、主要指標のブートストラップ区間を添えます。
yardstick::conf_mat() + autoplot()
適合率–再現率曲線
既婚女性のうち誰が婚外関係を申告するかを予測する 2 つの分類器の、交差検証による適合率–再現率曲線と、平均適合率、無技能のベースライン。
yardstick::pr_curve() + autoplot()
学習曲線
既婚女性のうち誰が婚外関係を申告するかを予測する 2 つのモデルについて、訓練データを増やしたときの訓練正解率と交差検証正解率を示します。
caret::learning_curve_dat() + ggplot()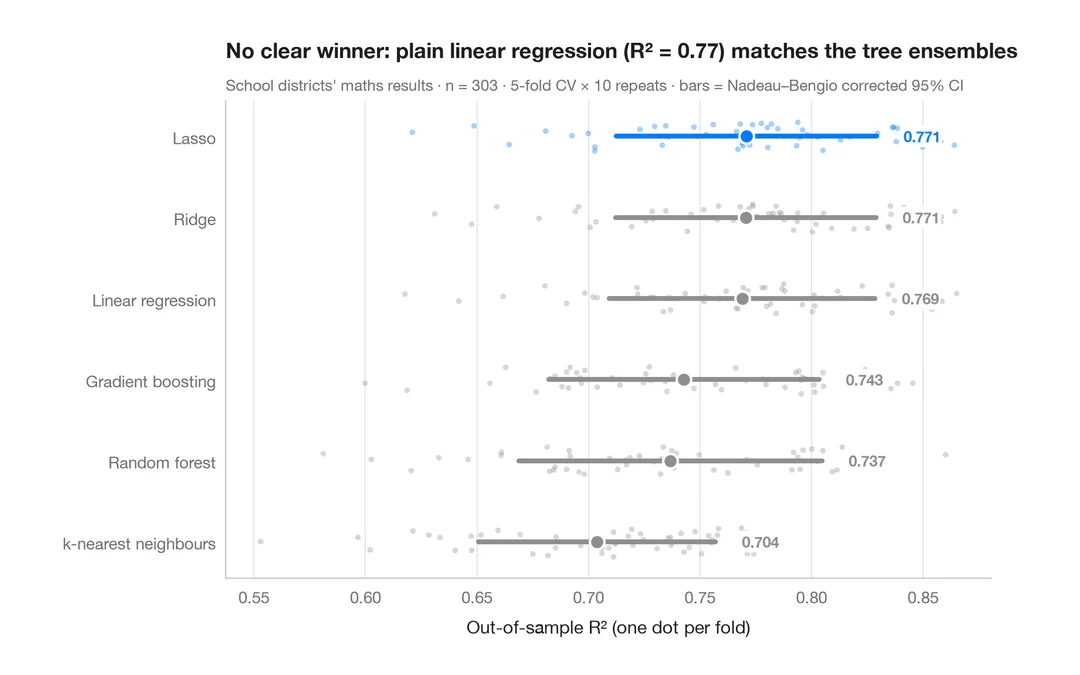
交差検証によるモデル比較
カリフォルニア州の学区の数学の成績を予測する 6 つのモデルの分割ごとの R² を、平均値と補正済み 95% 区間とともに示します。
caret::resamples() + bwplot() / tune::autoplot()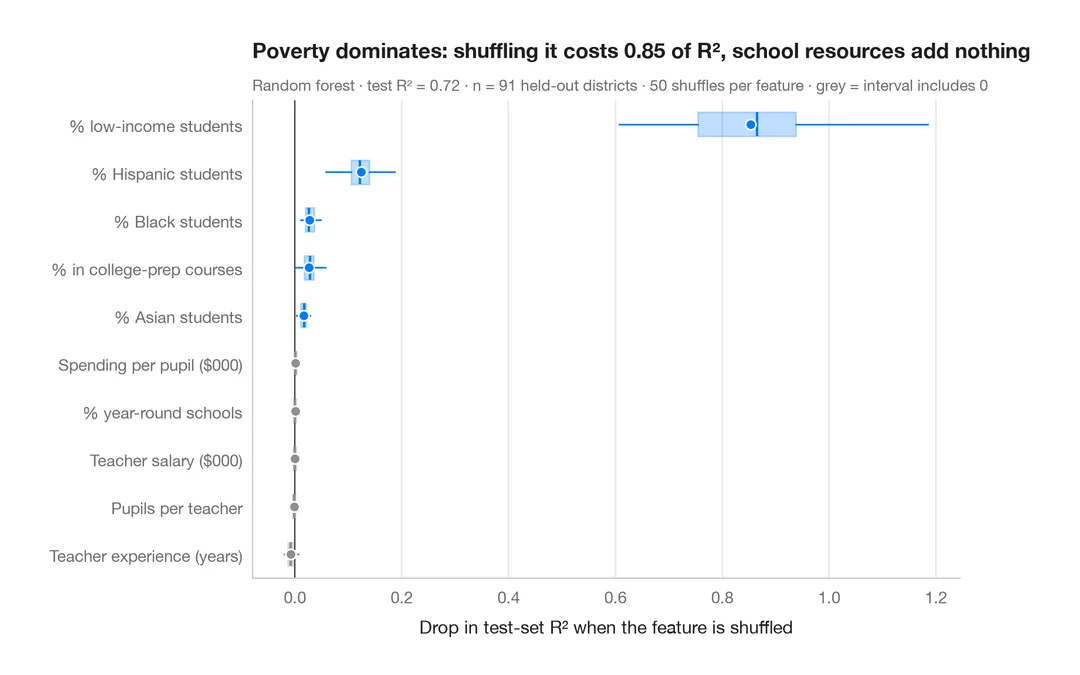
置換重要度
ランダムフォレストが数学の成績を予測する際に頼る学区の特性。各特性をシャッフルしたときのテスト R² の低下で示します。
vip::vip(method = "permute")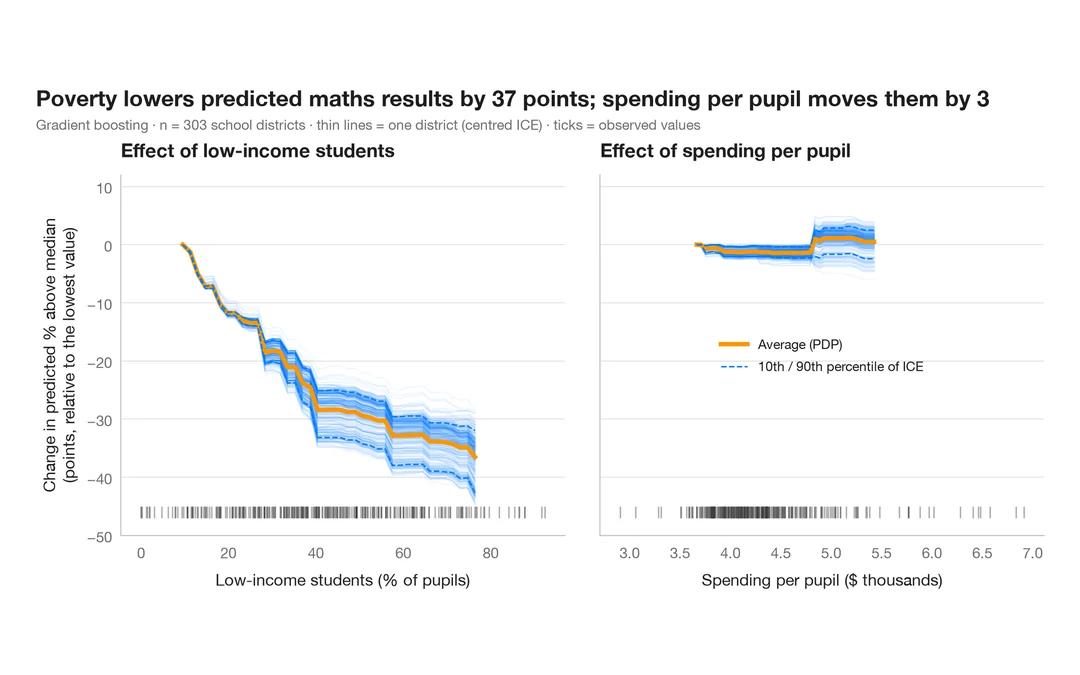
ICE 曲線付き部分依存プロット
予測される数学の成績が貧困と生徒 1 人あたり支出によってどう変わるか。平均(PDP)を学区ごとの曲線(ICE)に重ねて示します。
pdp::partial(ice = TRUE) + autoplot() / iml::FeatureEffect応用:SHAP による説明
シャープレイ値は、各予測を特徴量ごとの加法的な寄与に分解します。全体として、特徴量ごとに、そして個々のケースについて。
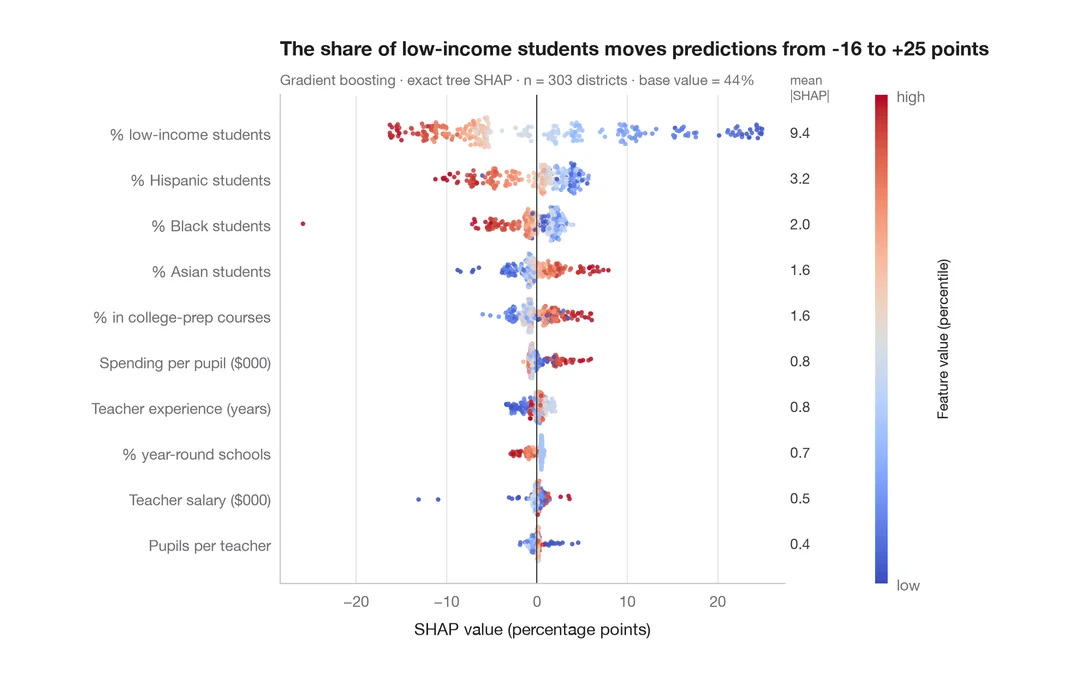
SHAP サマリー(ビースウォーム)
全学区・全特性の SHAP 値を特性の値で色分けし、平均 |SHAP| による重要度を添えます。
shapviz::sv_importance(kind = "beeswarm")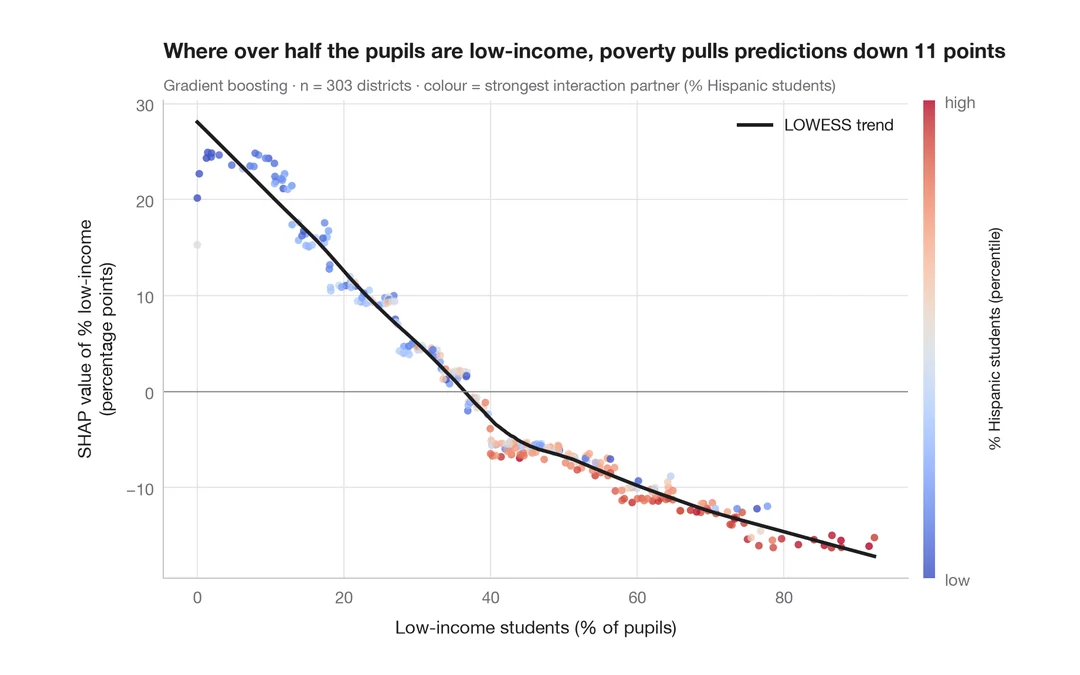
SHAP 依存プロット
低所得世帯の生徒の割合が各学区の予測される数学の成績にどう効くかを、最も強い交互作用の相手で色分けし、平滑化した傾向線を添えて示します。
shapviz::sv_dependence()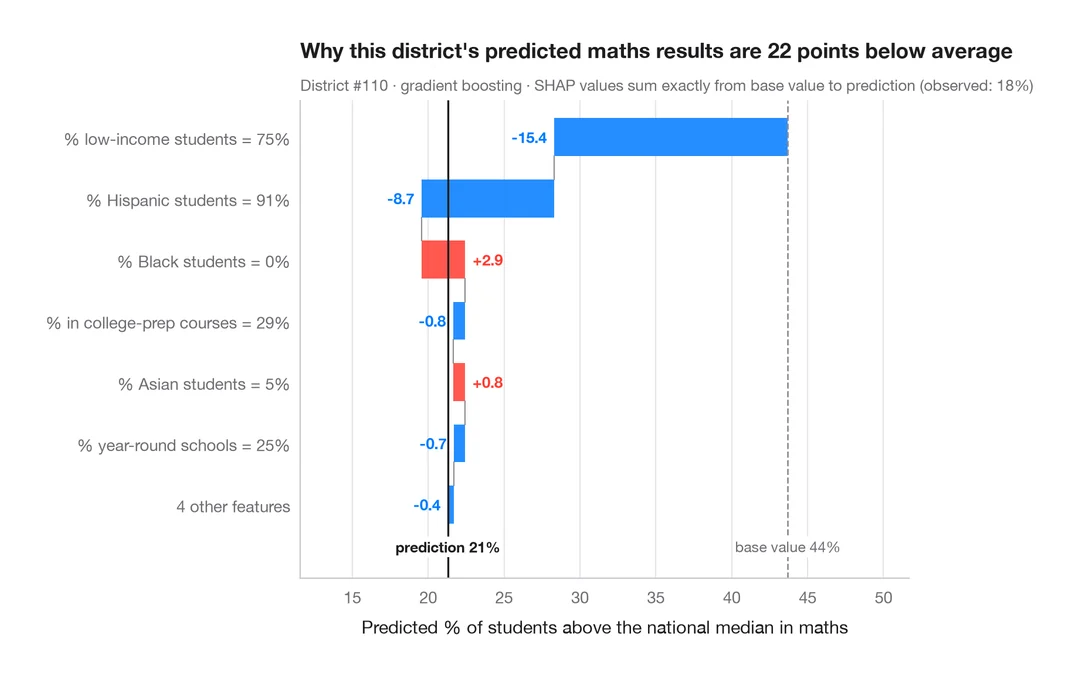
1 件の予測に対する SHAP ウォーターフォール
苦戦している 1 つの学区について、各特性が予測される数学の成績を平均からモデルの出力までどう動かすかを示します。
shapviz::sv_waterfall()空間データ
近隣の値が高いところでは、その値も高いのか。空間重み、大域的・局所的な空間自己相関、そしてクラスターの広がりを、1830 年代のゲリーのフランスで示します。
空間重み付きコロプレス図
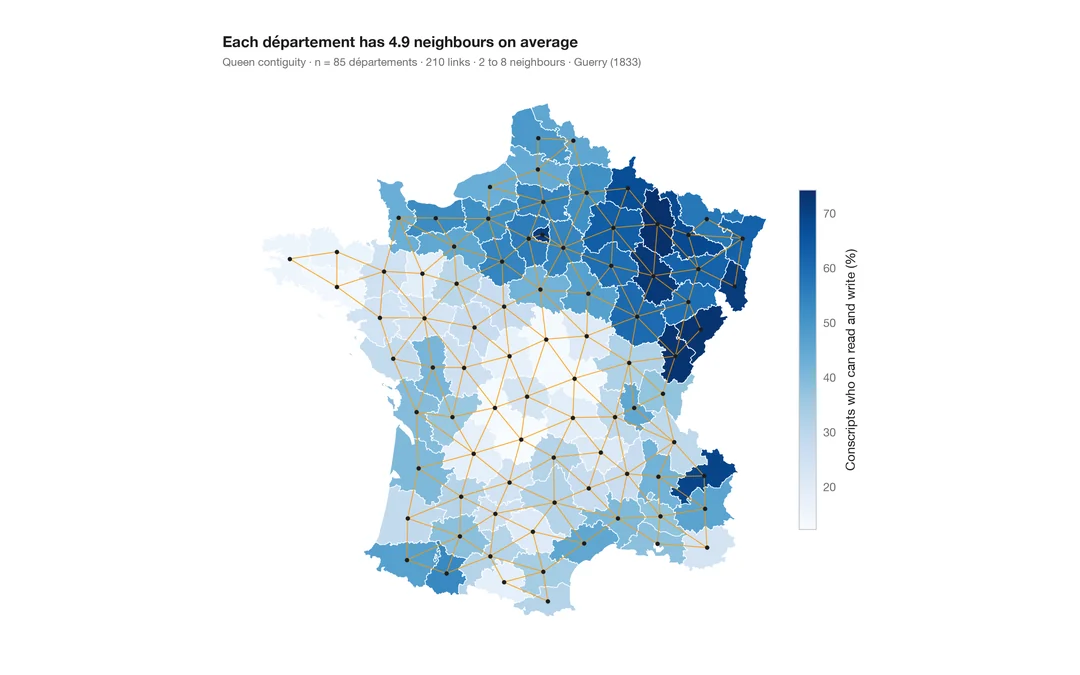
1 つの変数の地図に近隣ネットワークを重ねた図。あらゆる空間統計の土台となる構造です。
spdep::poly2nb() + plot(nb, coords)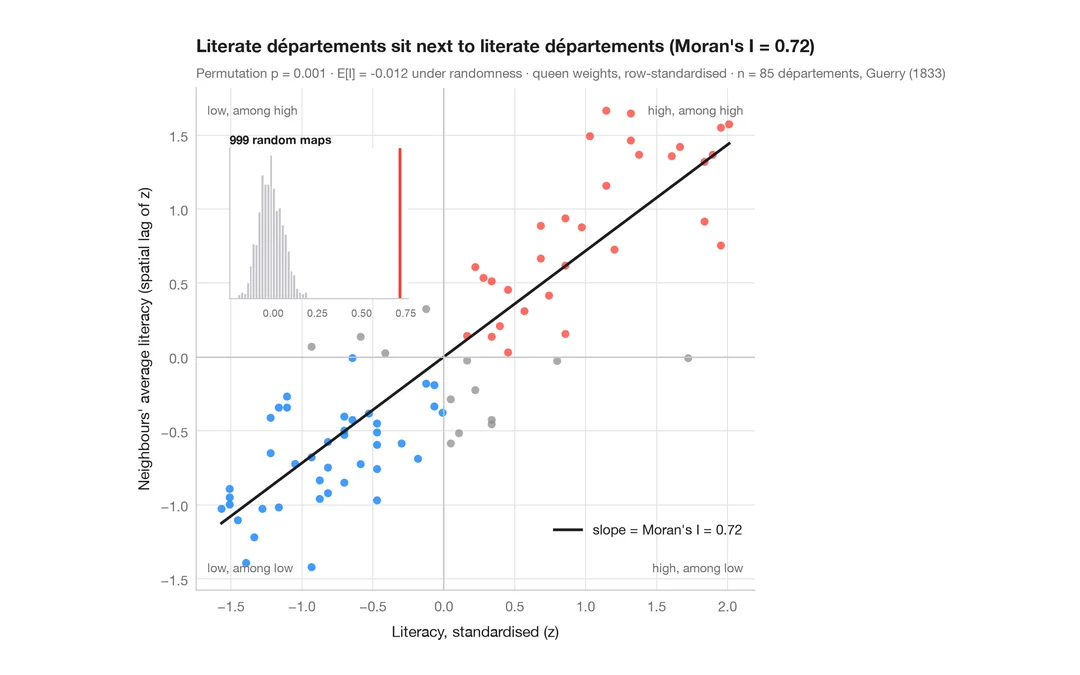
モラン散布図(大域的自己相関)
各地域をその近隣の平均と比べ、モランの I、並べ替え検定、参照分布を添えます。
spdep::moran.plot() + spdep::moran.mc()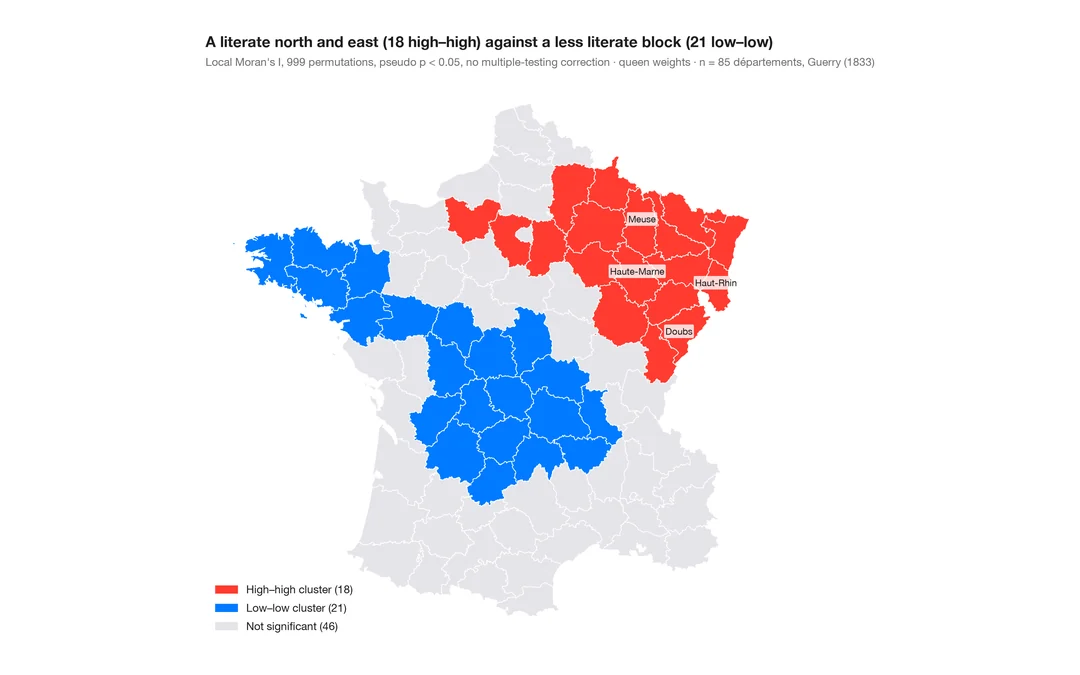
LISA クラスター地図(局所的自己相関)
クラスターと空間的外れ値がどこにあるか。各地域の局所モラン I を、並べ替えによる有意性とともに地図に示します。
spdep::localmoran_perm() / rgeoda::local_moran()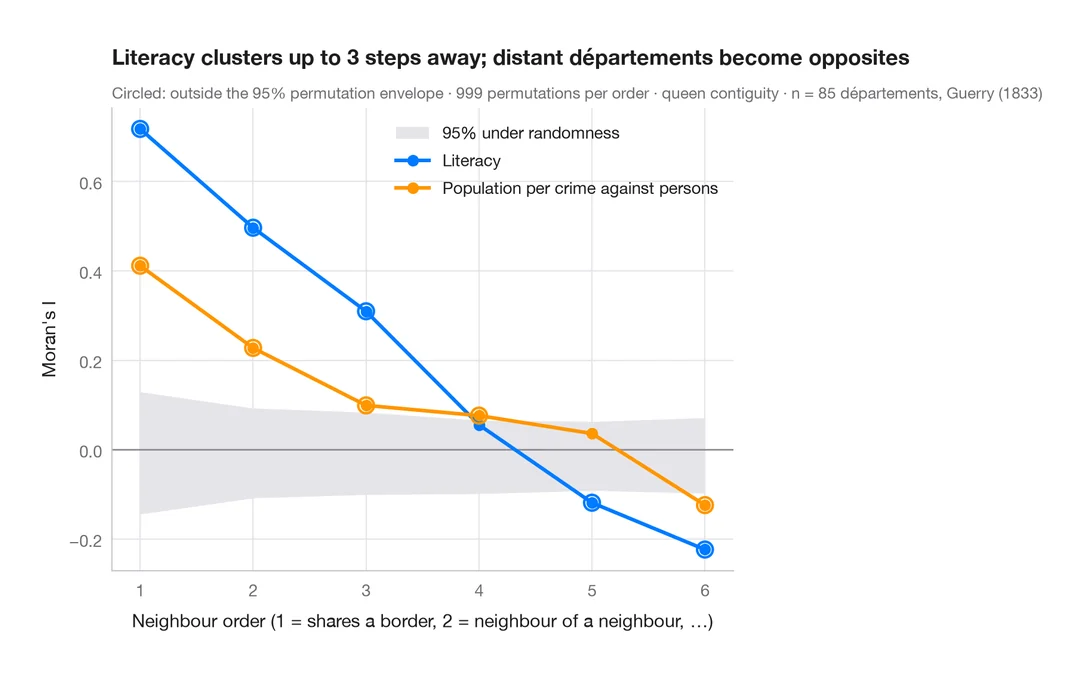
空間コレログラム
近隣の次数を広げながらモランの I を求め、並べ替えによる包絡線を添えます。空間的なクラスターがどこまで及ぶかを示します。
spdep::sp.correlogram(method = "I")分布
ヒストグラム、密度曲線、リッジラインプロット、ECDF、Q–Q プロットでデータの形をとらえます。
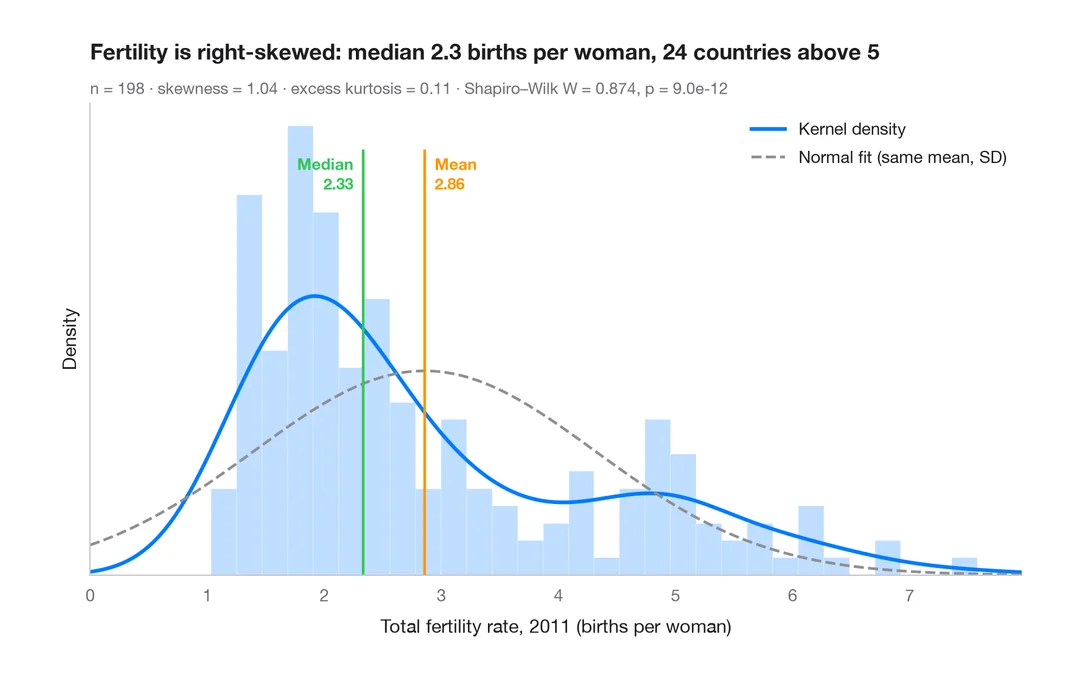
密度曲線付きヒストグラム
ヒストグラム、カーネル密度、当てはめた正規曲線を、分布の形状を表す統計量とともに示します。
ggplot2::geom_histogram() + geom_density()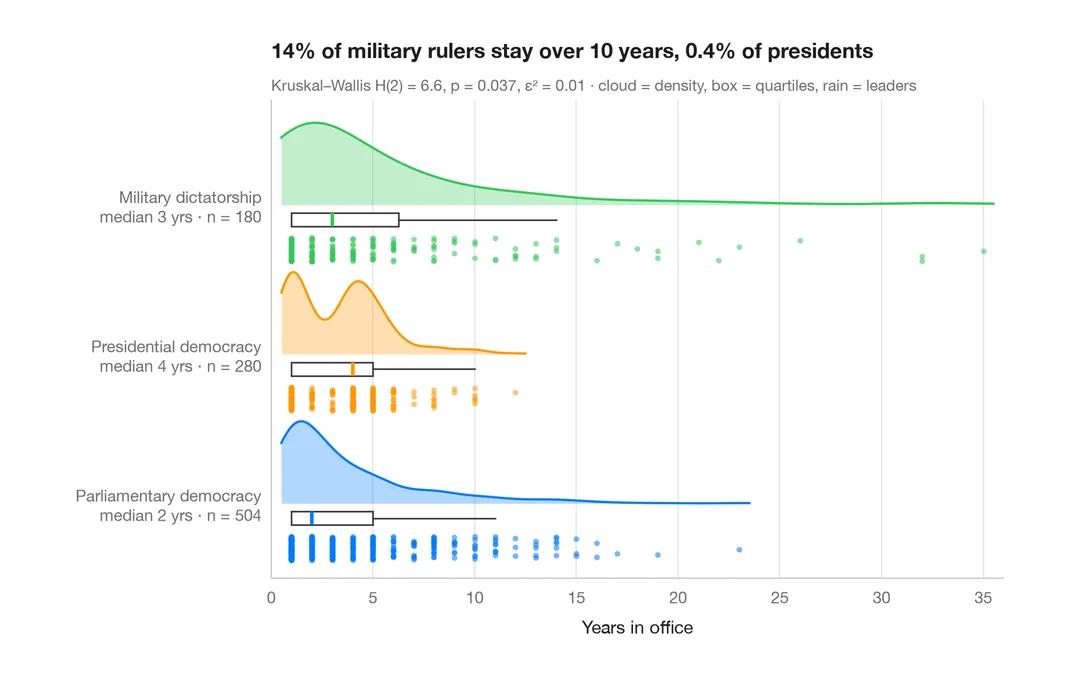
レインクラウドプロット
群ごとに半分のバイオリン、箱ひげ図、個々のデータ点を横向きに描きます。
ggdist::stat_halfeye() / ggrain::geom_rain()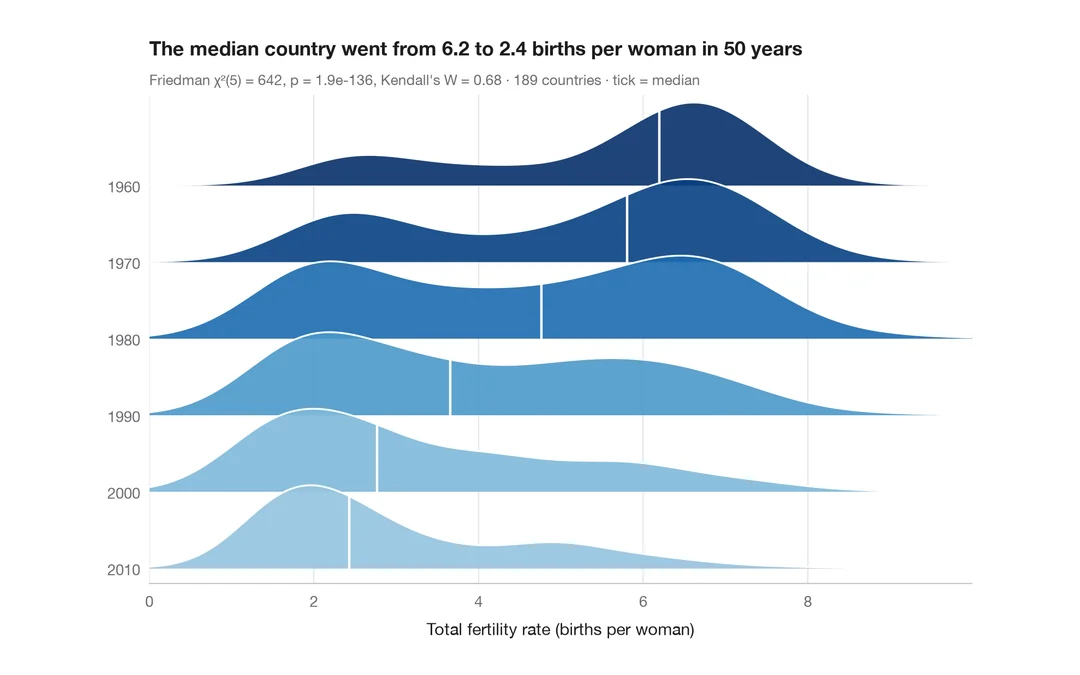
リッジラインプロット
重なり合う密度曲線で、多数の群にわたる分布を比較します。
ggridges::geom_density_ridges()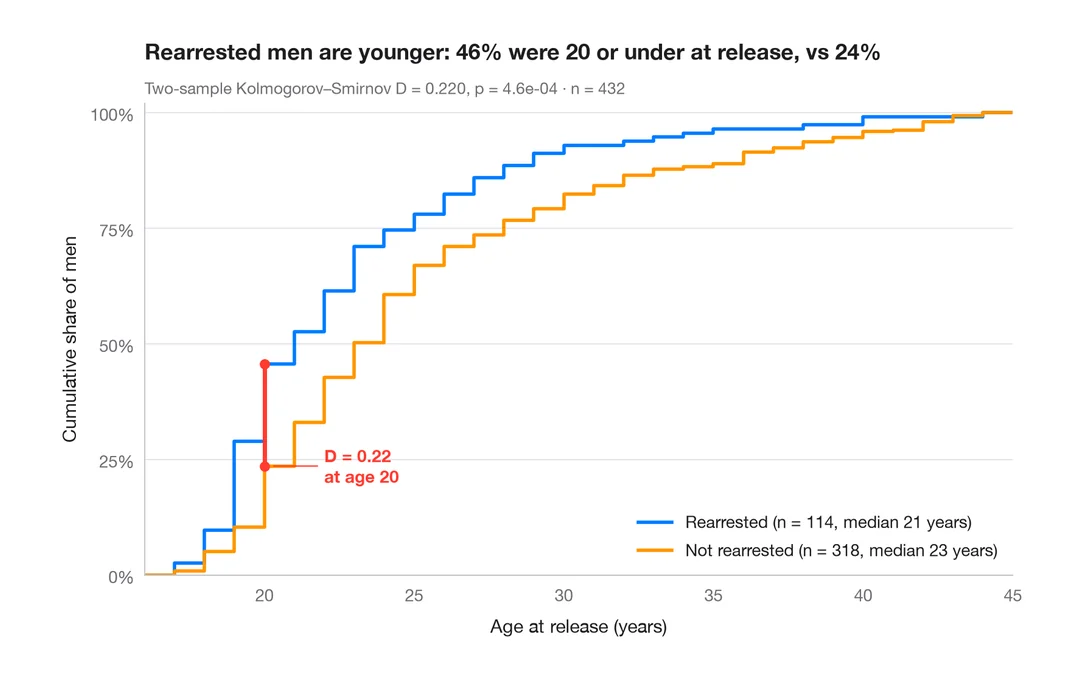
ECDF の比較
2群の経験累積分布関数を、コルモゴロフ・スミルノフ統計量の差とともに描きます。
ggplot2::stat_ecdf()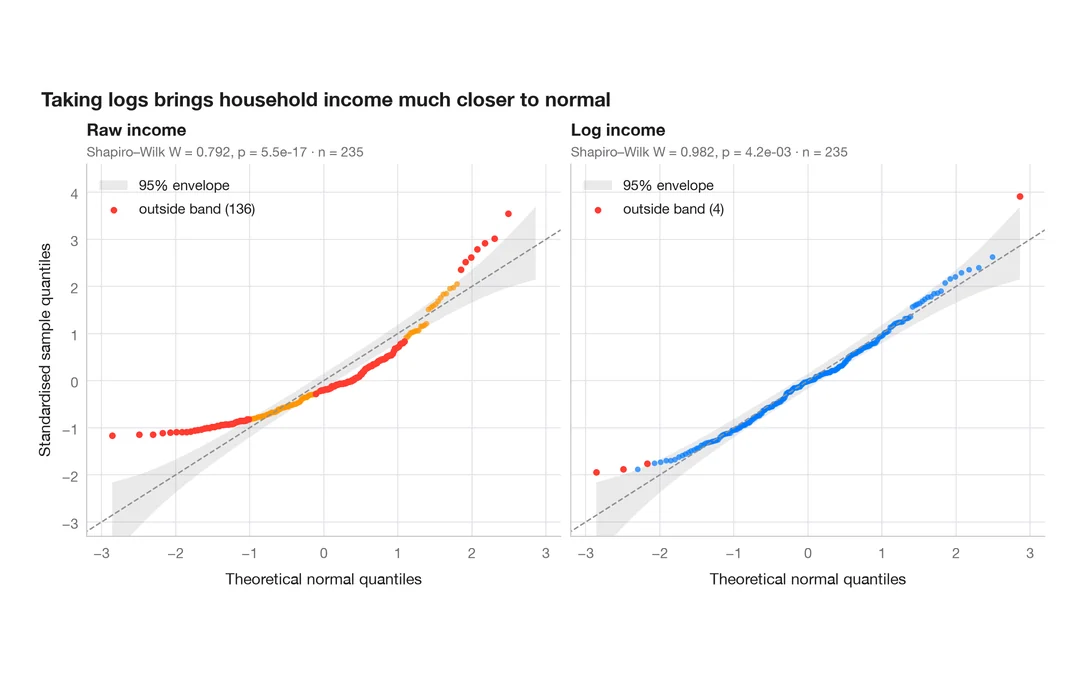
信頼帯付き Q–Q プロット
元の変数と対数変換した変数について、95% 包絡線付きの正規 Q–Q プロットを描きます。
qqplotr::stat_qq_band()群間比較
検定、効果量、p値をグラフ上に示して群を比較します。ggstatsplot のスタイルです。
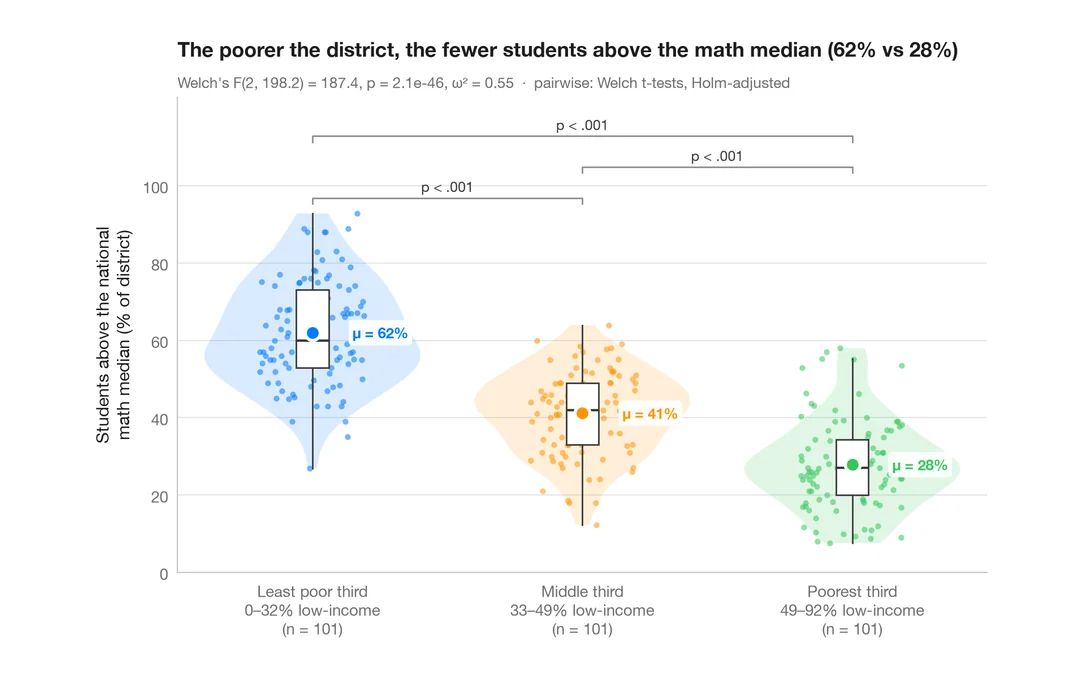
群間比較
バイオリン+箱ひげ+データ点に、ウェルチの分散分析、効果量、多重比較を添えます。
ggstatsplot::ggbetweenstats()
被験者内比較
被験者ごとの線、平均、反復測定分散分析、対応のある検定で反復測定データを示します。
ggstatsplot::ggwithinstats()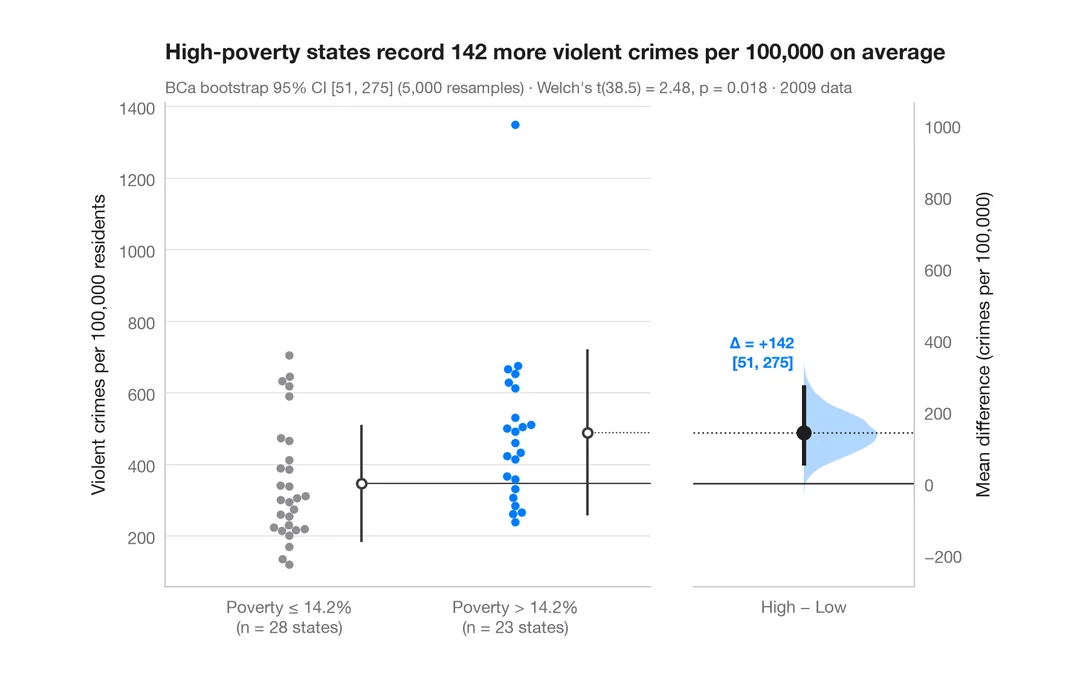
推定プロット
2群の生データに、平均値の差とそのブートストラップ 95% 信頼区間を添えます。
dabestr::dabest() + plot()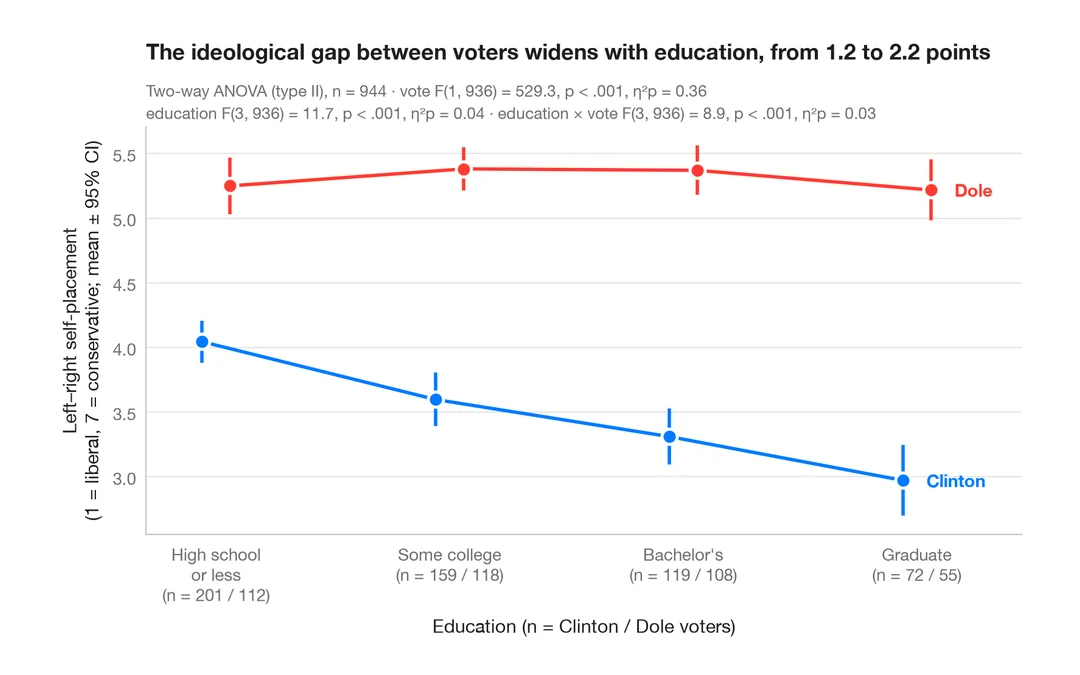
交互作用プロット
2要因の群平均を 95% 信頼区間とともに描き、二元配置分散分析を添えます。
ggpubr::ggline(add = "mean_ci") / ggstats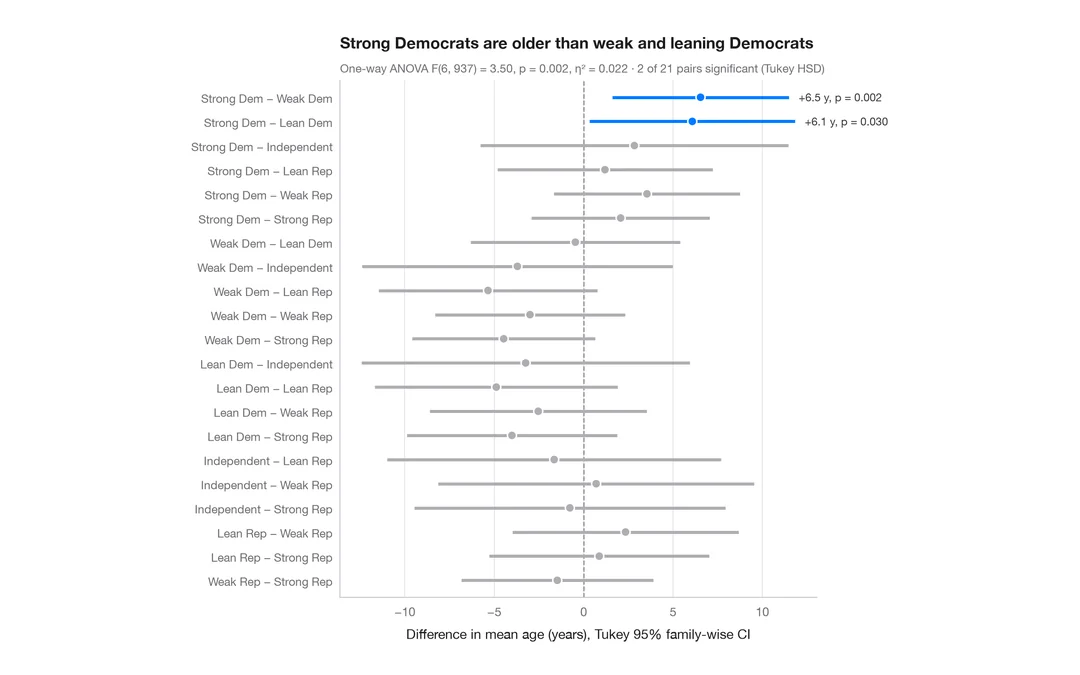
テューキーの HSD 区間
すべての平均値の差の対について、同時 95% 信頼区間を示します。
TukeyHSD() + plot()割合と調査データ
割合、クロス集計、リッカート尺度を、ggstats::gglikert や stat_prop の流儀で描きます。
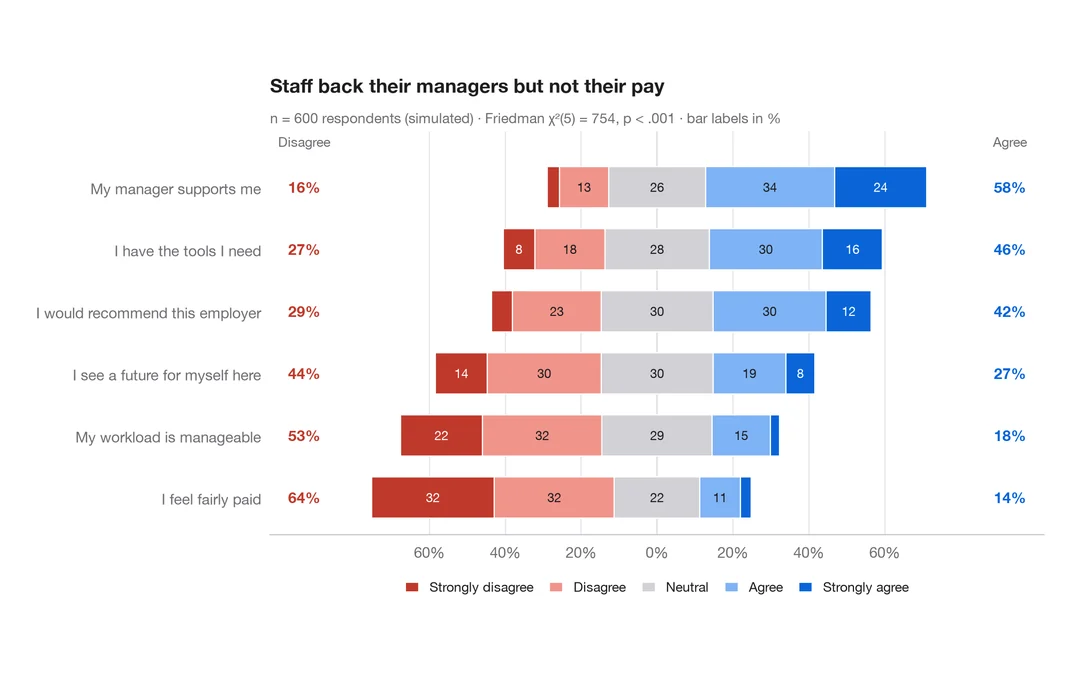
発散型リッカートチャート
5件法のリッカート項目を、中立の回答を中心とした発散型積み上げ棒で示します。
ggstats::gglikert()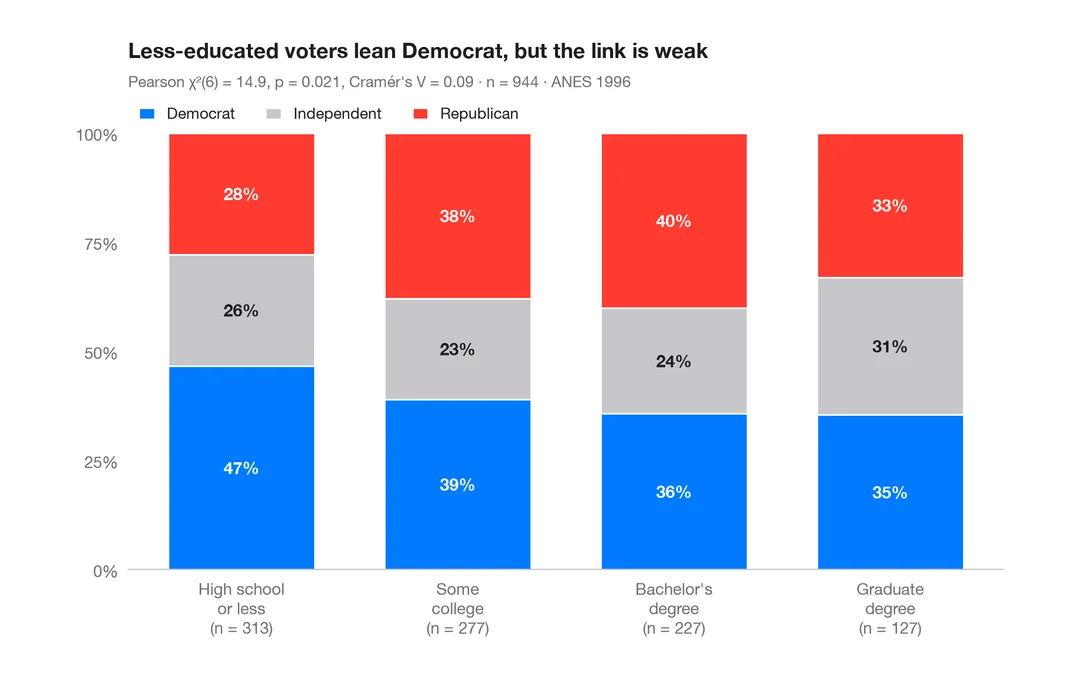
群別の積み上げ割合
割合ラベル、棒ごとの n、カイ二乗検定、クラメールの V を伴う 100% 積み上げ棒グラフ。
ggstatsplot::ggbarstats()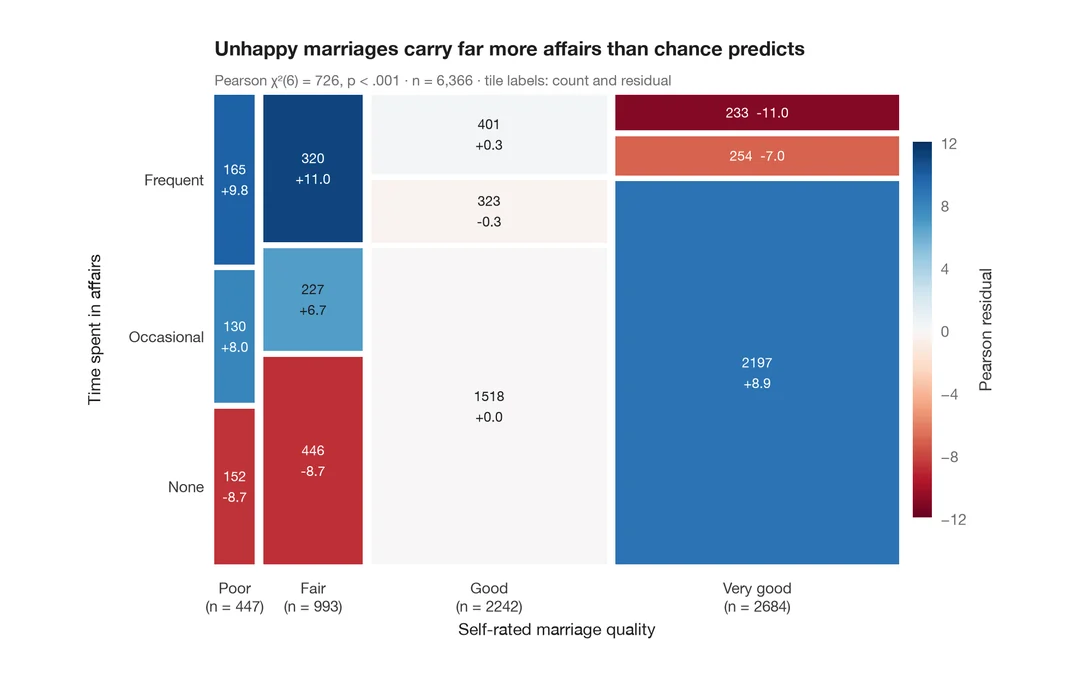
ピアソン残差付きモザイクプロット
セル度数に比例した面積のタイルを、独立性からのピアソン残差で色分けします。
vcd::mosaic(shade = TRUE)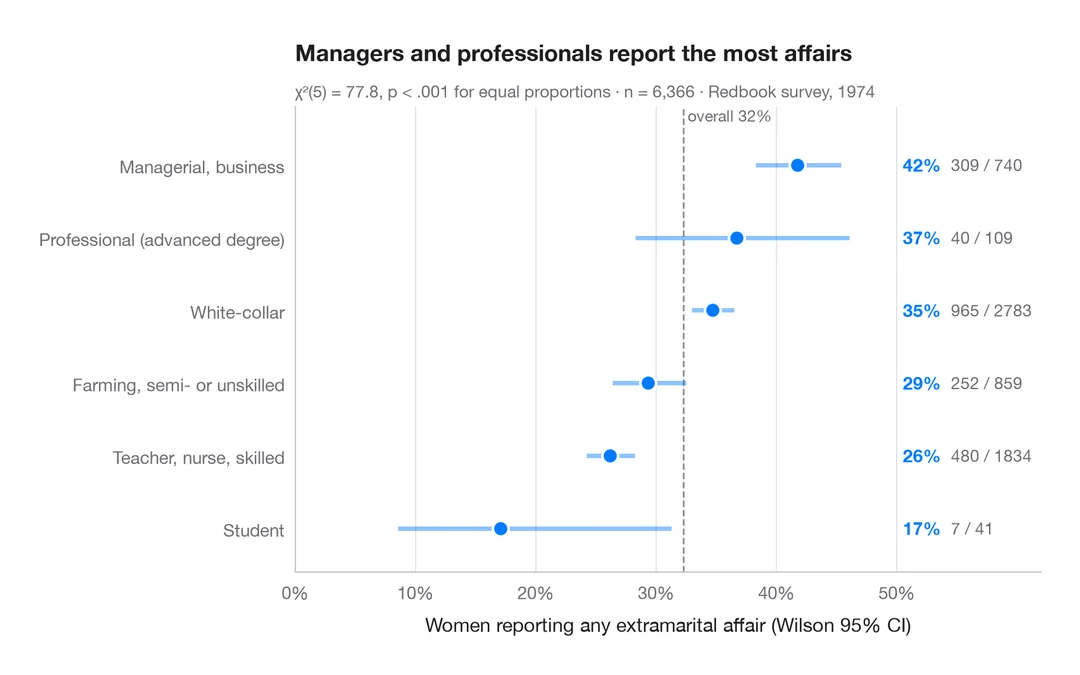
信頼区間付きの割合
群ごとの割合をウィルソンの 95% 信頼区間とともに、並べ替えたドットプロットで示します。
ggstats::stat_prop() + geom_errorbar()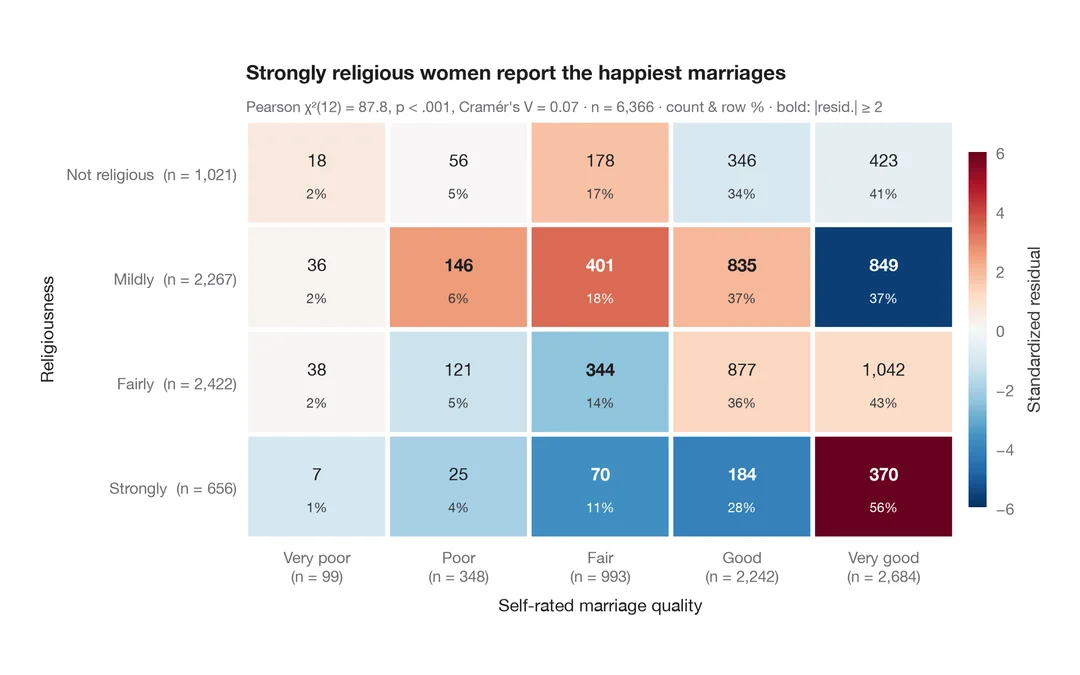
標準化残差付きクロス集計表
分割表をヒートマップとして描き、独立性からの標準化残差で色分けします。
ggstats::ggtable() / stat_cross()相関と関連
相関行列、統計量付き散布図、変数ペア間の関係を描きます。
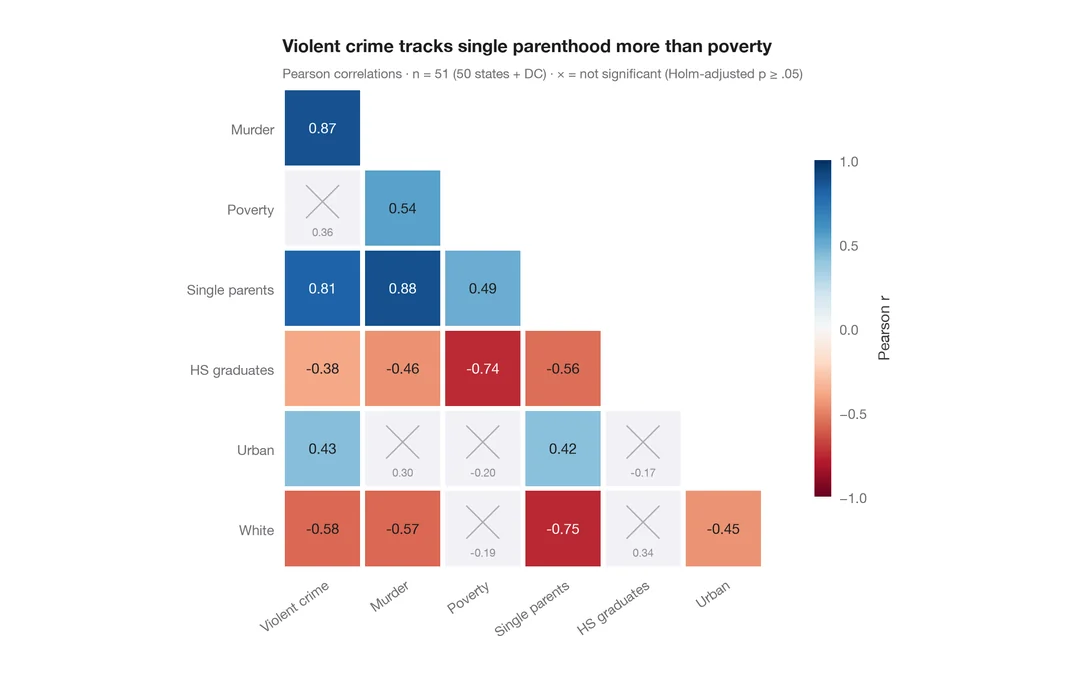
相関行列
ピアソン相関の下三角ヒートマップ。有意でないセル(ホルム法)には×印を付けます。
ggstatsplot::ggcorrmat()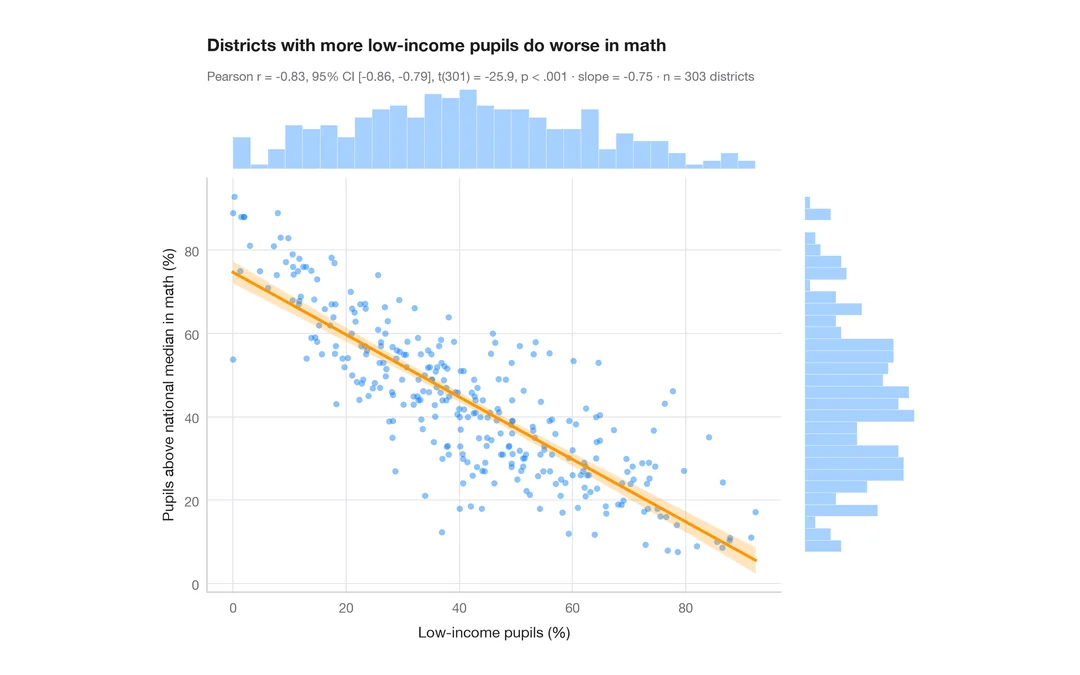
統計量付き散布図
カリフォルニア州 303 学区における低所得世帯の児童の割合と数学の成績 — 散布図、95% 信頼帯付きの OLS 直線、周辺ヒストグラム、ピアソンの r。
ggstatsplot::ggscatterstats()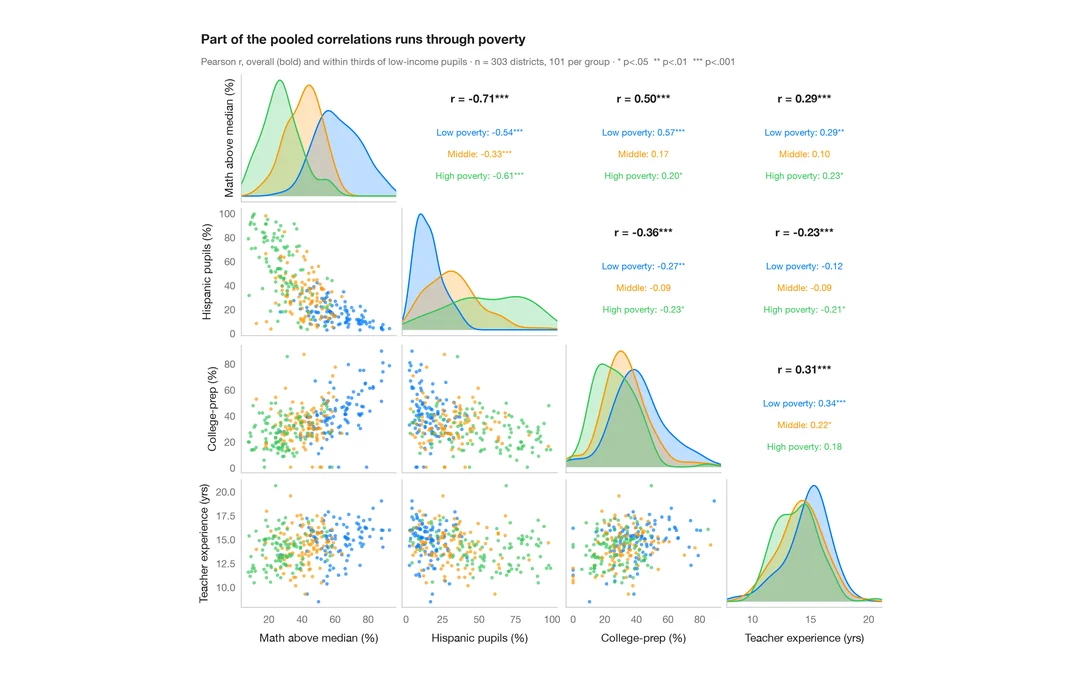
相関係数付きペアプロット
学区に関する 4 変数の散布図行列。対角線上に群別の密度、その上に全体と群内の相関係数を示します。
GGally::ggpairs()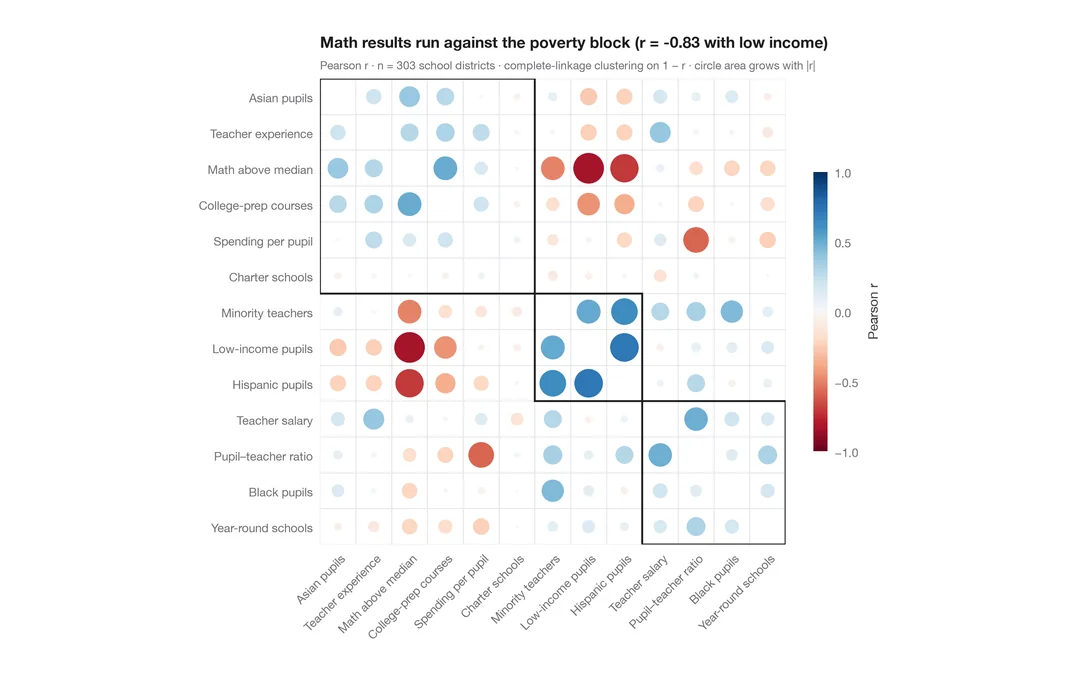
クラスタリング付きコレログラム
学区に関する 13 の指標について、r に応じて大きさと色を決めた corrplot 風の円を、階層的クラスタリングの順に並べたものです。
corrplot::corrplot(order = "hclust", addrect = 3)回帰モデル
係数プロット、オッズ比、モデル比較、限界効果。Python 版の ggcoef_model です。

係数プロット
回帰係数の推定値を 95% 信頼区間とともに、項ごとに1行で示します。
ggstats::ggcoef_model()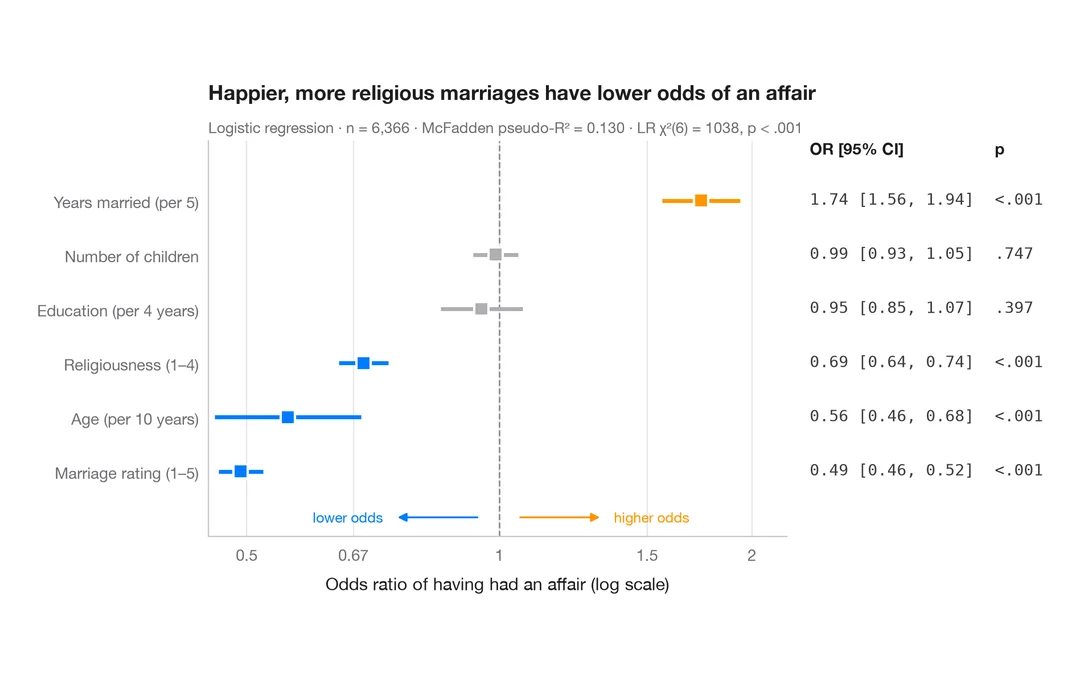
オッズ比のフォレストプロット
ロジスティック回帰のオッズ比を対数スケールで描き、OR [95% CI] の表を並べます。
ggstats::ggcoef_model(exponentiate = TRUE)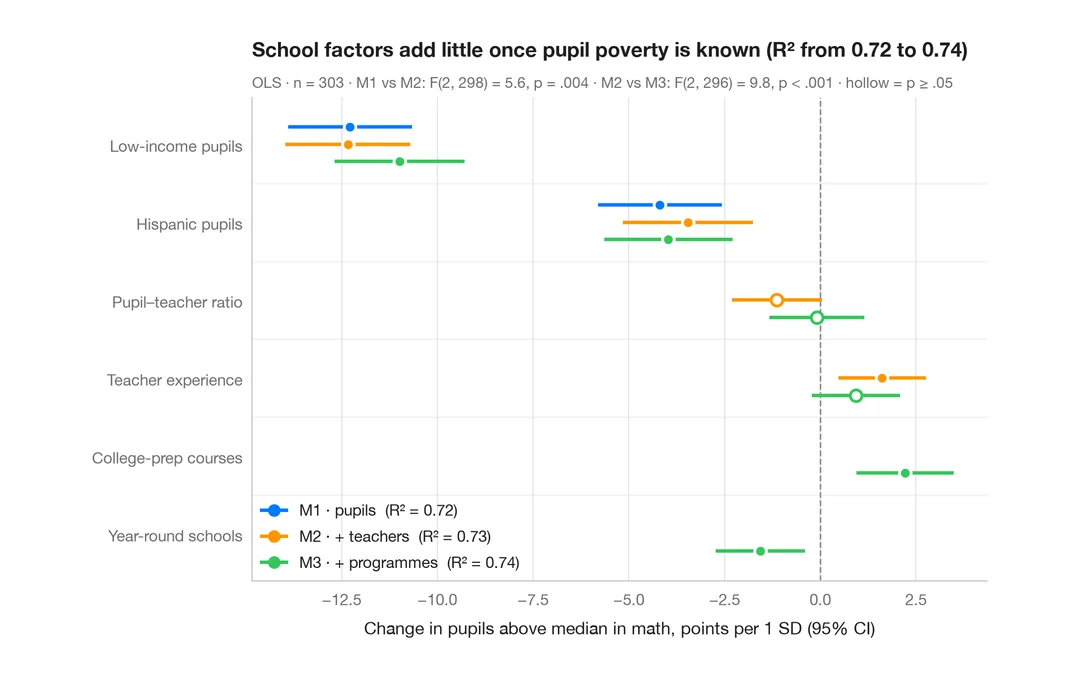
入れ子モデルの比較
学区の数学の成績に関する 3 つの入れ子回帰の係数を並べ、ブロックを追加するにつれて推定値がどう動くかを見ます。
ggstats::ggcoef_compare()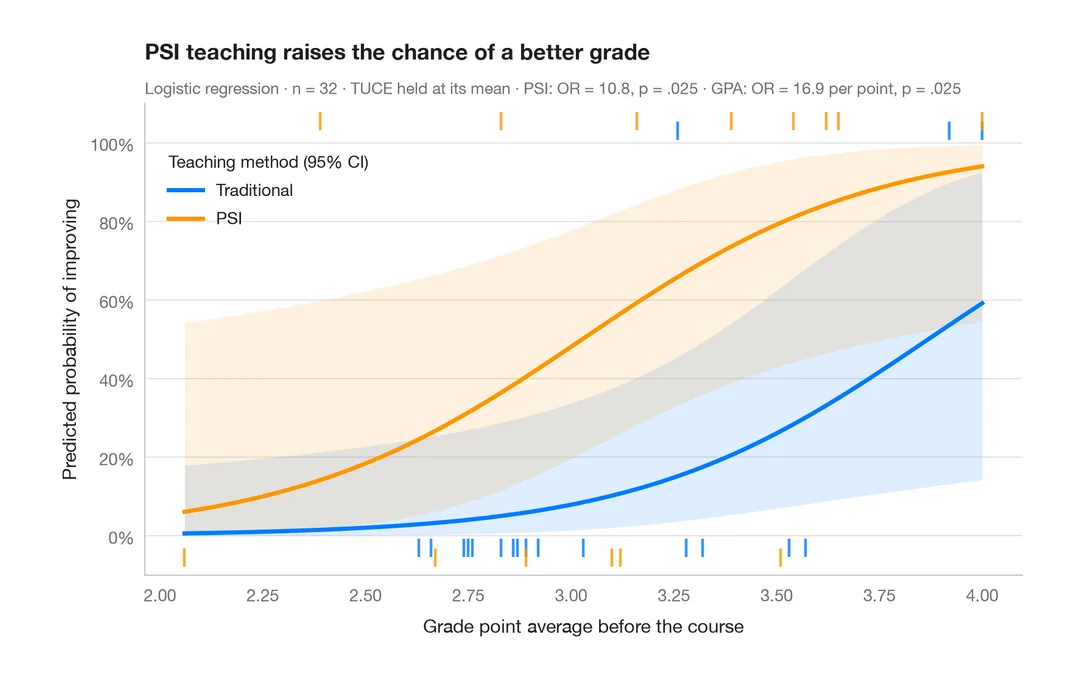
予測確率
モデルに基づく確率曲線を、群ごとに 95% 信頼帯とともに説明変数の範囲にわたって描きます。
ggeffects::ggpredict() / marginaleffects::plot_predictions()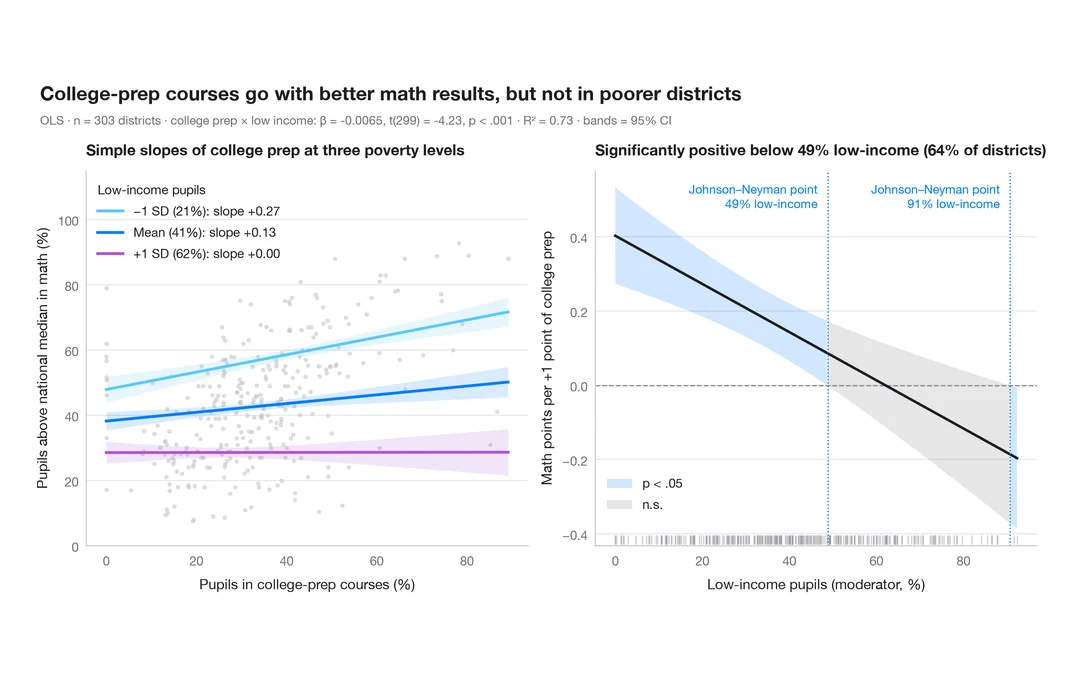
交互作用効果
平均 ± 1 SD における単純傾斜とジョンソン・ネイマン・プロット。大学進学準備コースと数学の成績の関係を、児童の貧困が調整します。
interactions::interact_plot() / interactions::johnson_neyman()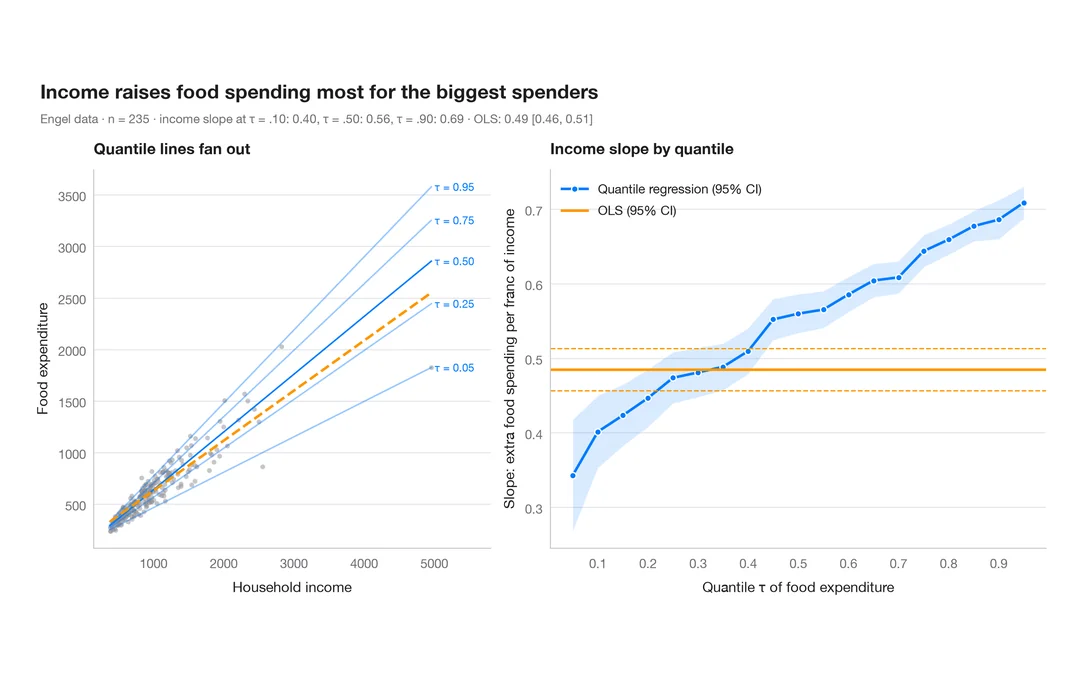
分位点回帰プロセス
条件付き分布にわたって傾きがどう変化するかを、単一の OLS 推定値と比較します。
quantreg::plot(summary(rq(tau = 1:19 / 20)))モデル診断
残差、てこ比、キャリブレーション、ROC 曲線。モデルを信頼する前に確認しましょう。
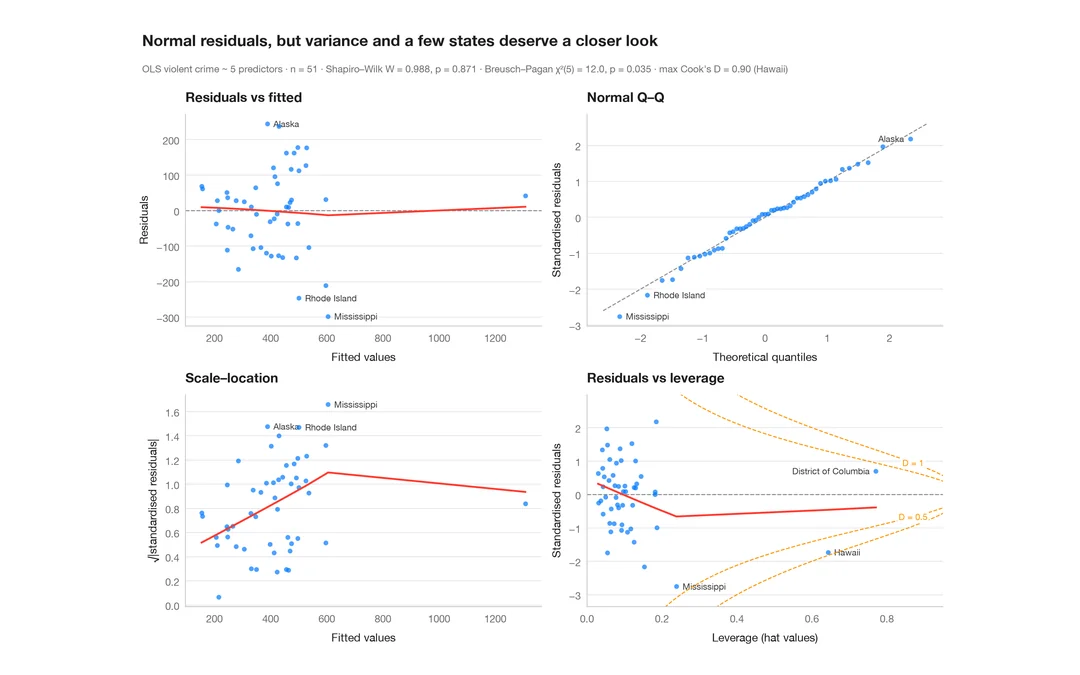
残差診断
線形モデルのための定番の 2 × 2 パネル。線形性、正規性、分散、てこ比を確認します。
plot(lm) / performance::check_model()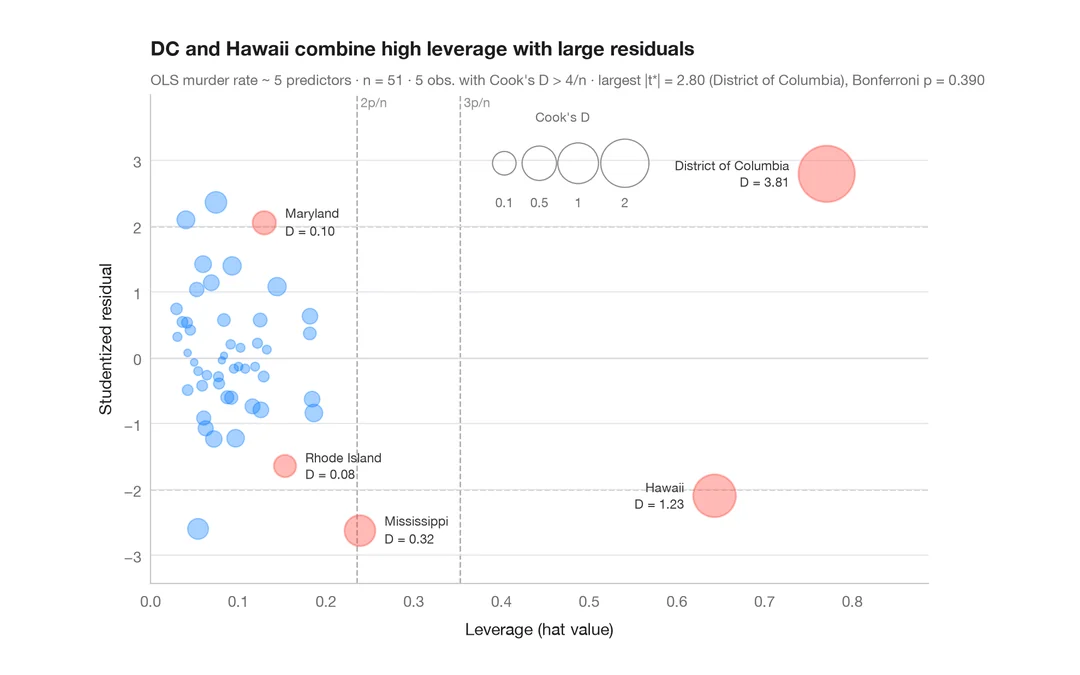
影響度プロット
スチューデント化残差対てこ比を、クックの距離に応じた大きさのバブルで描きます。
car::influencePlot()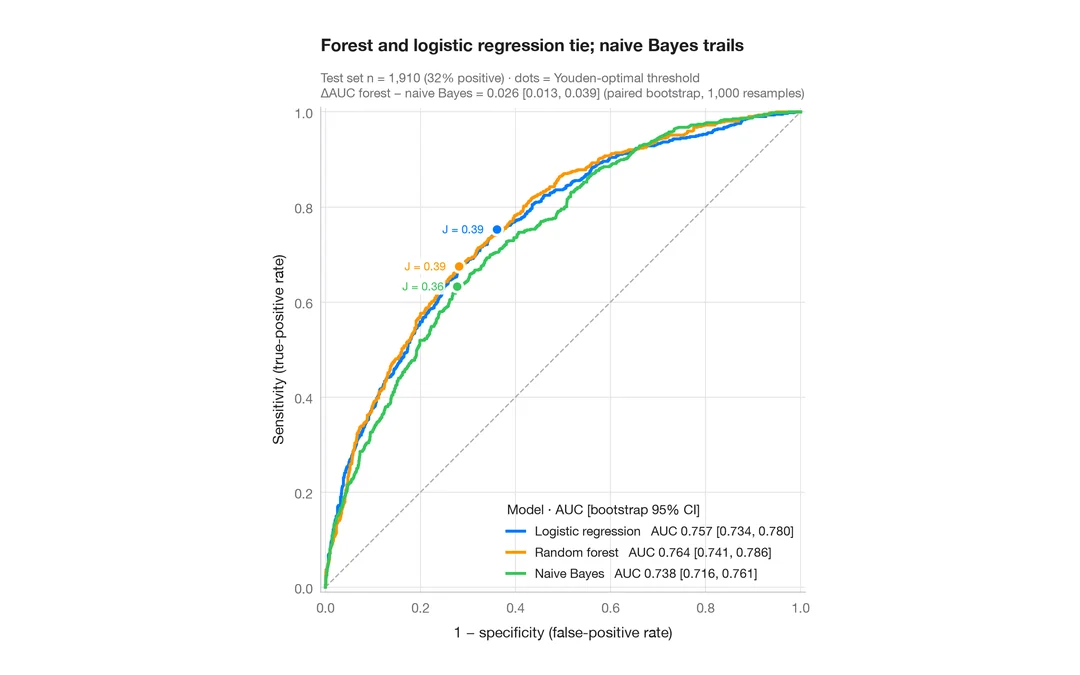
ROC 曲線
3つの分類器を ROC 曲線、ブートストラップ 95% 信頼区間付きの AUC、ユーデン点で比較します。
pROC::ggroc() / pROC::ci.auc()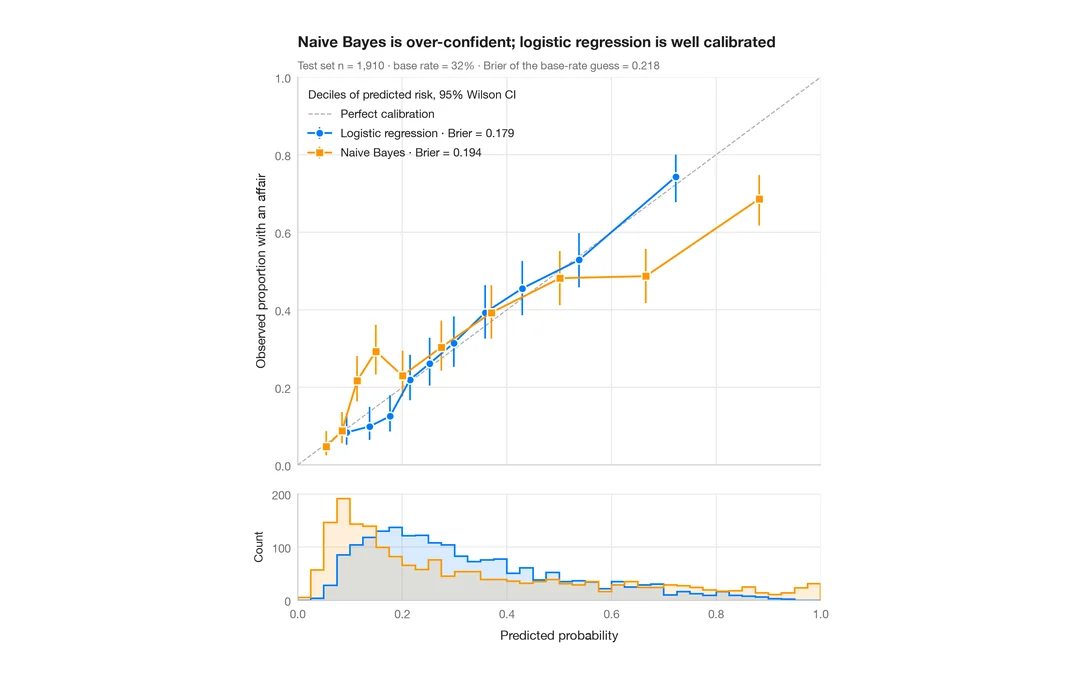
キャリブレーションプロット
十分位ごとの予測リスク対観測リスクを、ウィルソン信頼区間、予測値のヒストグラム、ブライアスコアとともに示します。
rms::calibrate() / probably::cal_plot_breaks()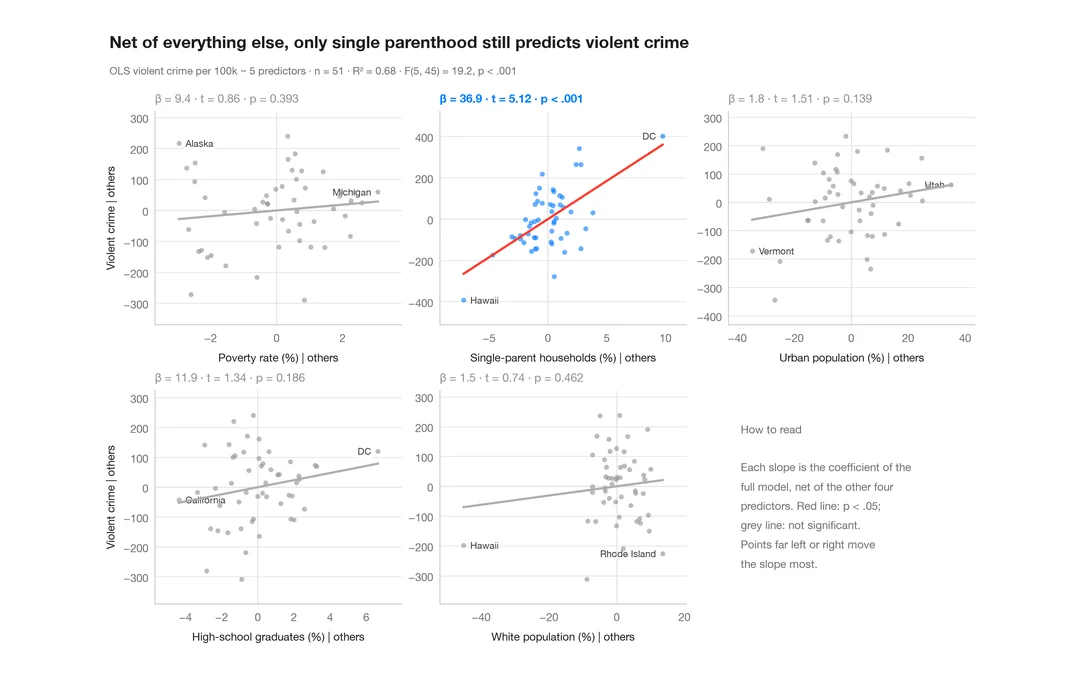
追加変数プロット
説明変数ごとの偏回帰パネル。当てはめた各傾きはその回帰係数に一致します。
car::avPlots()生存時間分析
リスク集合表付きのカプラン・マイヤー曲線、累積ハザード、Cox モデルのハザード比。
カプラン・マイヤー曲線
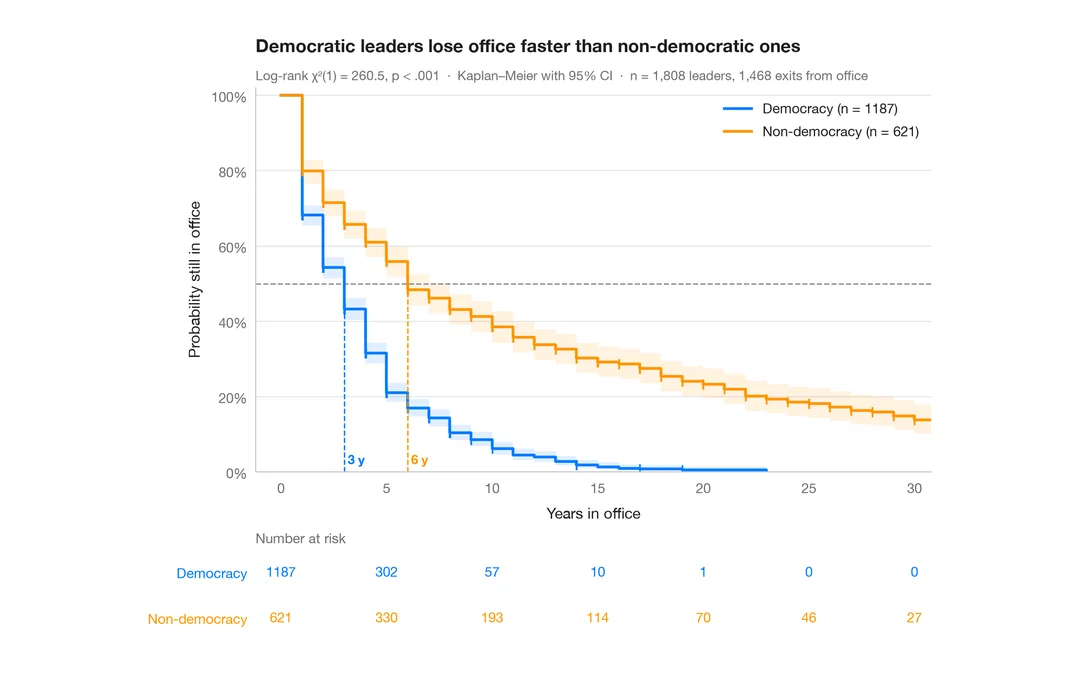
政治指導者が在任し続ける期間、民主制と非民主制の比較 — 信頼帯、打ち切りの印、ログランク検定、リスク集合の表付きの生存曲線。
survminer::ggsurvplot(risk.table = TRUE)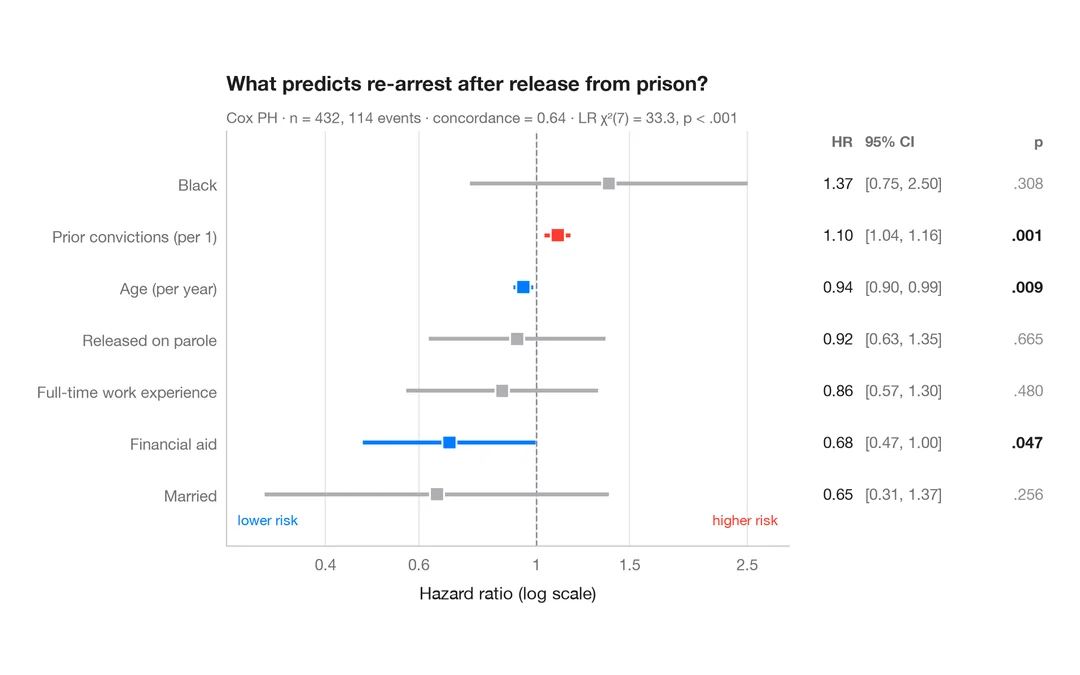
Cox モデルのハザード比
HR、95% 信頼区間、p値を示す Cox 比例ハザードモデルのフォレストプロットです。
survminer::ggforest()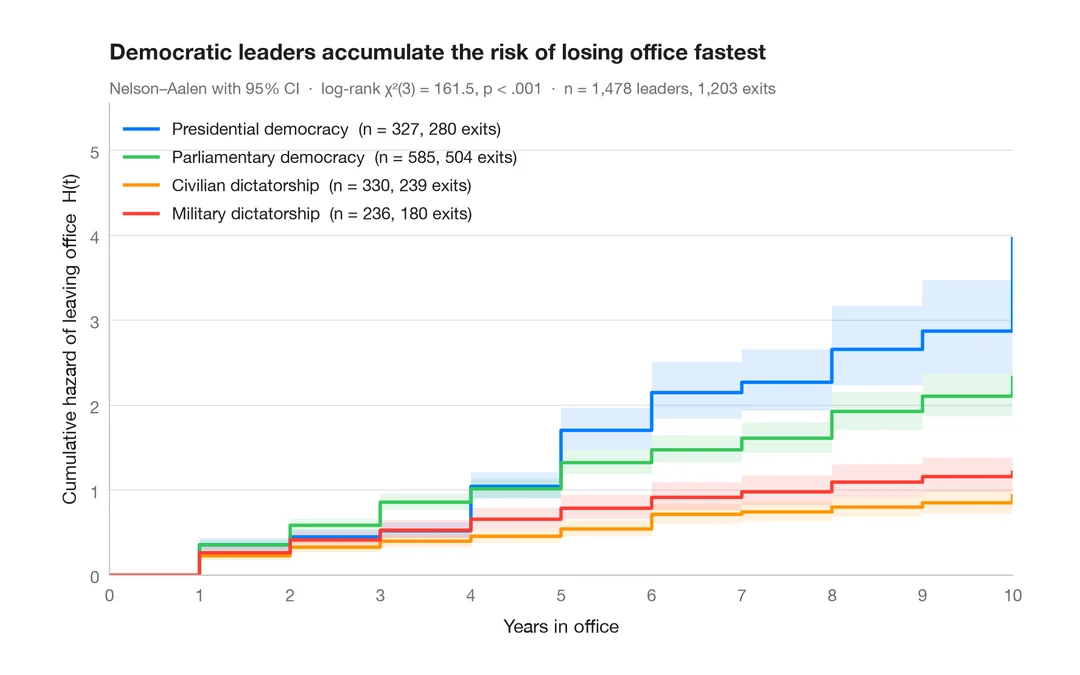
累積ハザード
4 つの政治体制について、退任の Nelson–Aalen 累積ハザードを 95% 信頼帯とともに示します。
survminer::ggsurvplot(fun = "cumhaz")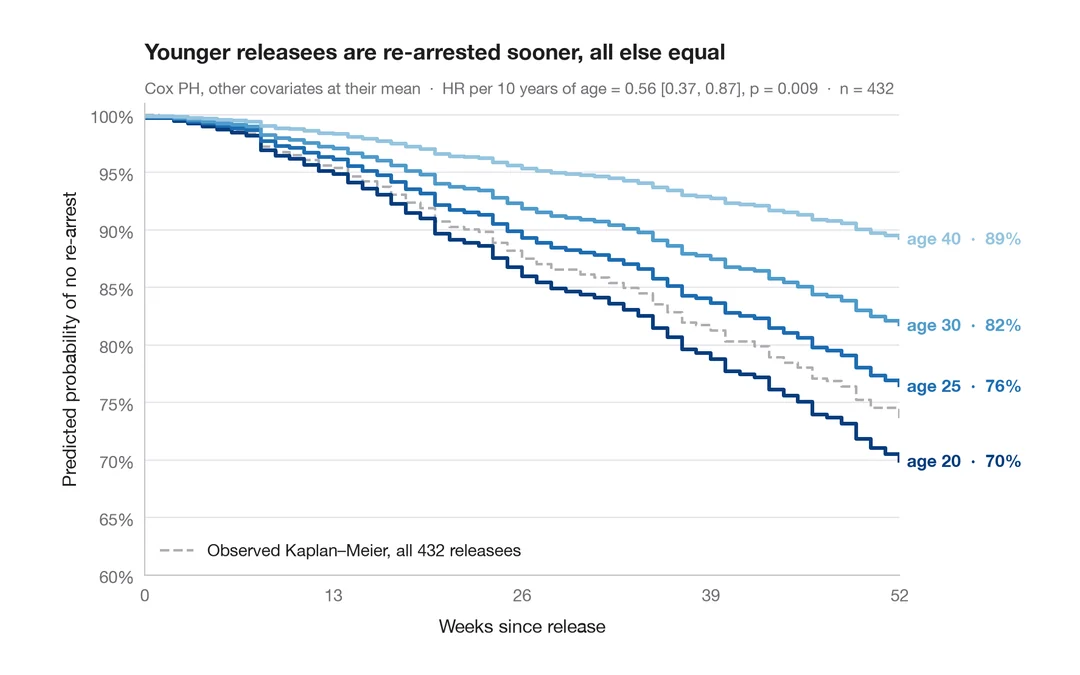
調整済み生存曲線
他の共変量を平均値に固定し、複数の年齢について Cox モデルで予測した生存曲線です。
survminer::ggadjustedcurves()時系列
分解、自己相関、予測区間付きの予測、時間的変化を描きます。
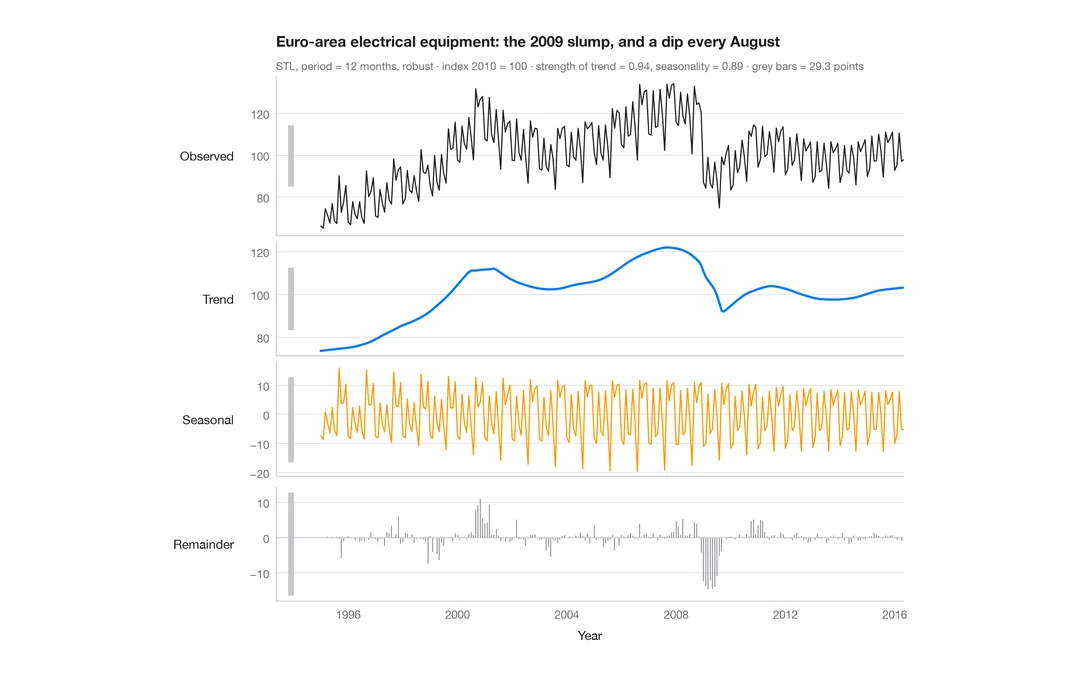
STL 分解
月次の工業売上高の系列を、トレンド、季節成分、残差に分解して縦に並べたパネルで示します。
feasts::STL() + autoplot()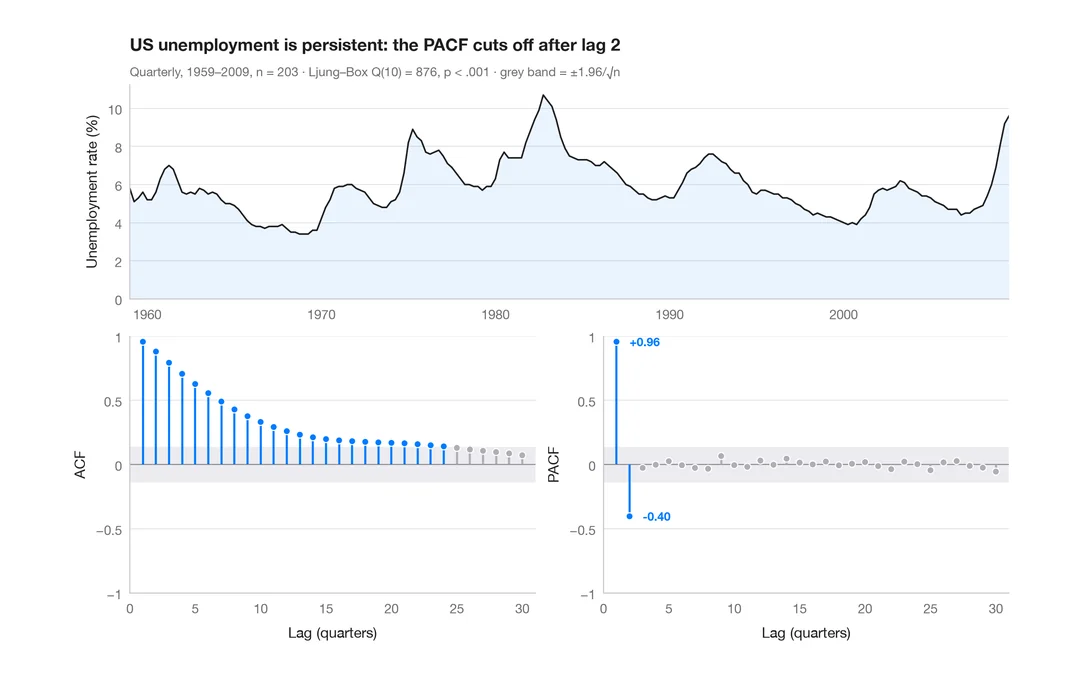
ACF と PACF
米国の四半期失業率の自己相関と偏自己相関を、95% 有意帯付きのロリポップで示します。
forecast::ggtsdisplay()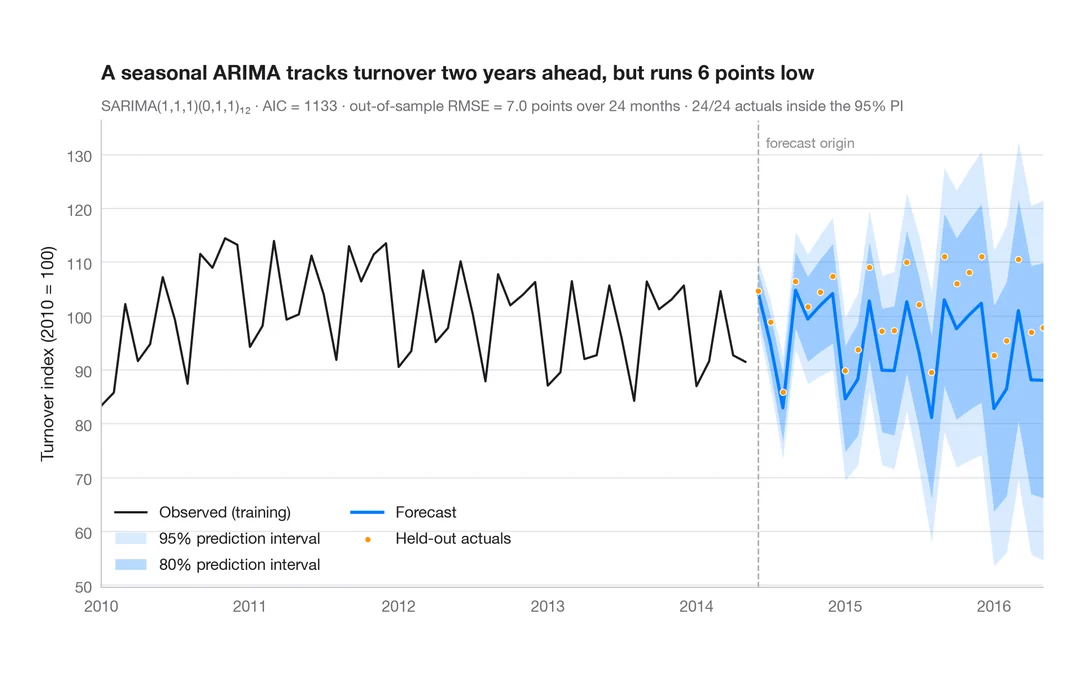
SARIMA 予測
工業売上高の季節 ARIMA 予測を、80% と 95% の予測区間とともにホールドアウトしたデータと比較します。
forecast::autoplot(forecast())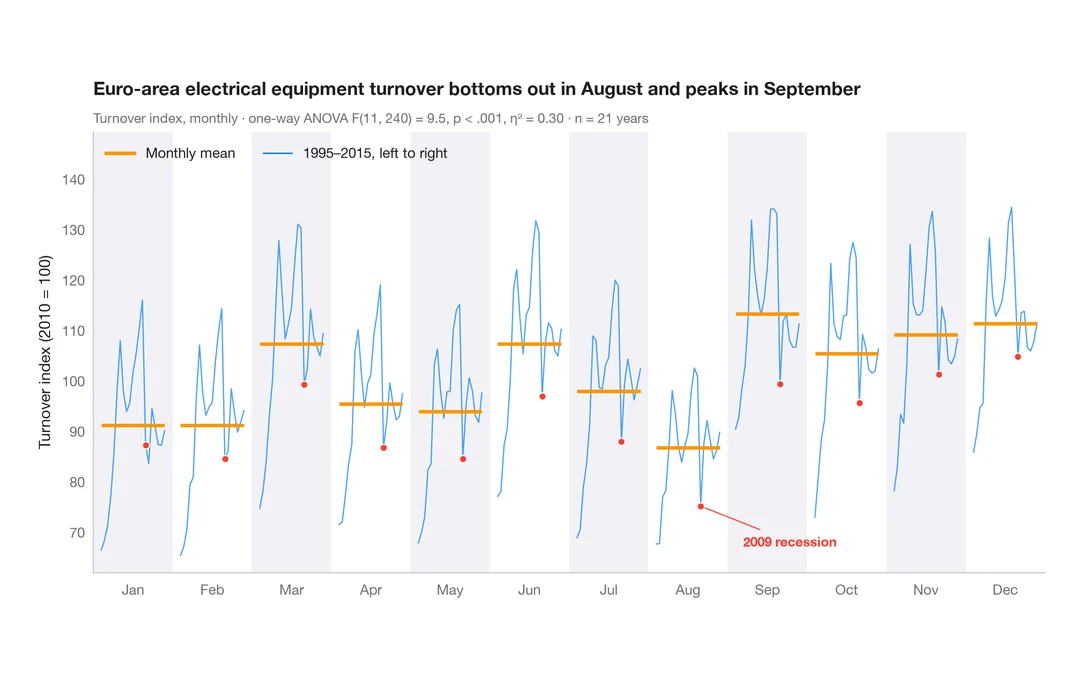
季節サブシリーズプロット
各暦月の工業売上高の年ごとの推移を、月平均を基準として示します。
feasts::gg_subseries()多変量解析とクラスタリング
高次元データのための PCA バイプロット、スクリープロット、クラスタリング、ヒートマップ。
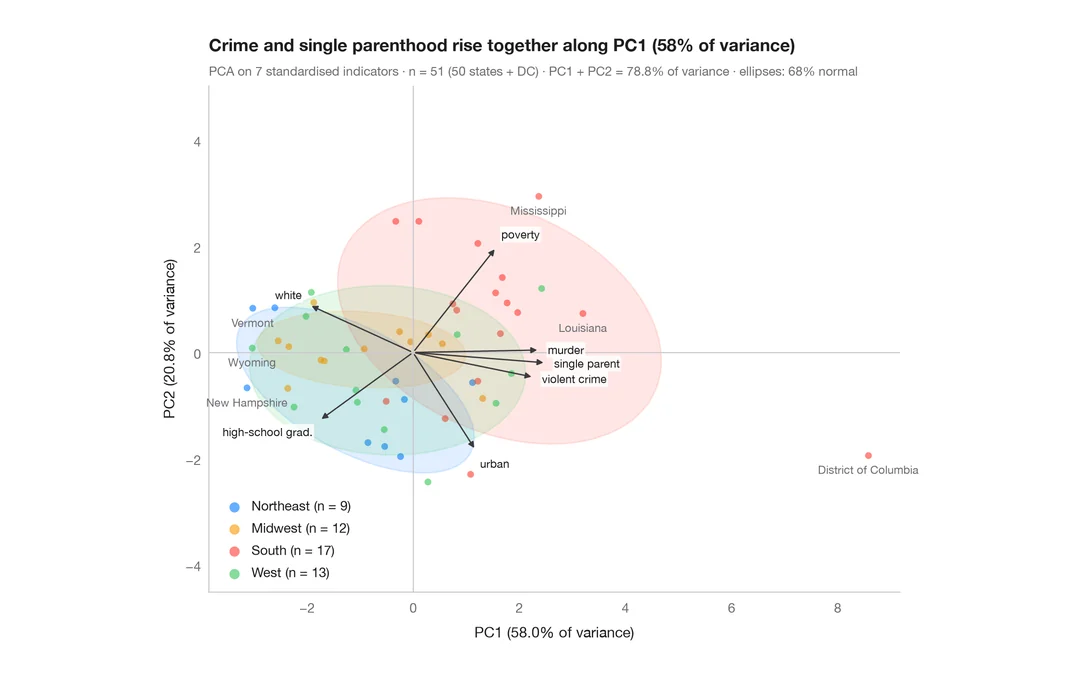
PCA バイプロット
米国の州とその社会指標を第 1・第 2 主成分の平面に配置します。
factoextra::fviz_pca_biplot()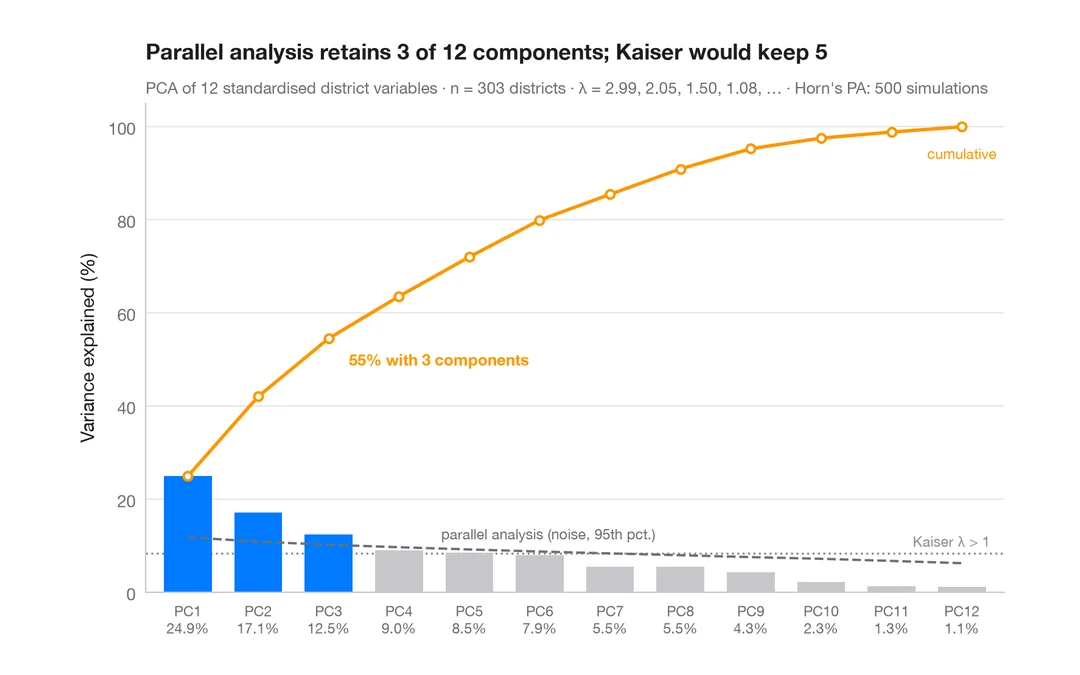
スクリープロット
カリフォルニア州の 303 学区を記述するには何次元が必要か?成分ごとの分散と平行分析による基準。
factoextra::fviz_eig()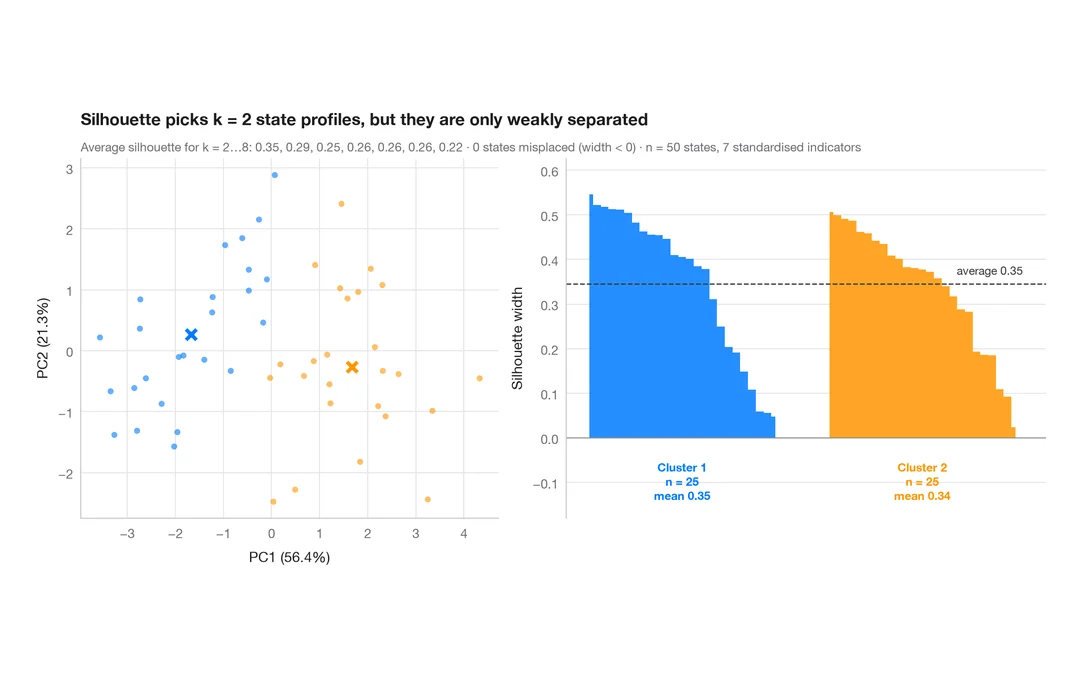
k-means のシルエットプロット
米国の州ははっきり異なる社会的プロファイルに分かれるか?k-means のクラスターとシルエット幅。
factoextra::fviz_silhouette()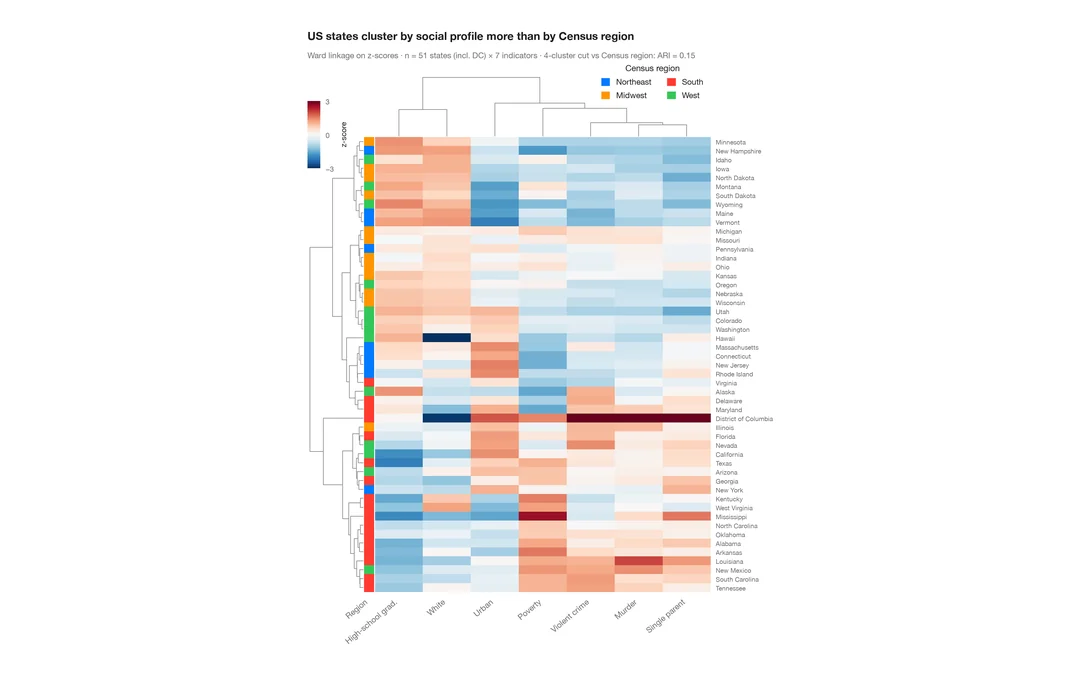
クラスター化ヒートマップ
米国各州の社会指標の z スコアのヒートマップ。行と列のデンドログラム、国勢調査地域のカラーバー付き。
pheatmap::pheatmap() / ComplexHeatmap::Heatmap()推測と不確実性
ブートストラップ、信頼区間、検出力、一致度、メタアナリシスのフォレストプロット。
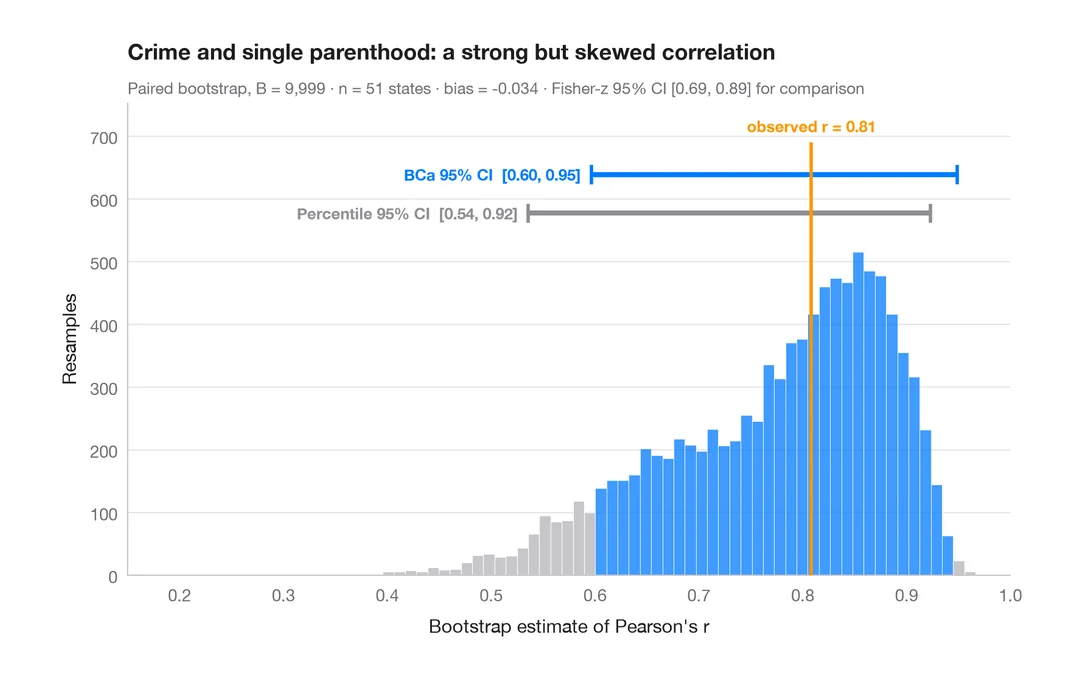
ブートストラップ分布
再標本化した相関係数を、パーセンタイル法と BCa 法の 95% 信頼区間とともに示します。
boot::boot() + boot::boot.ci()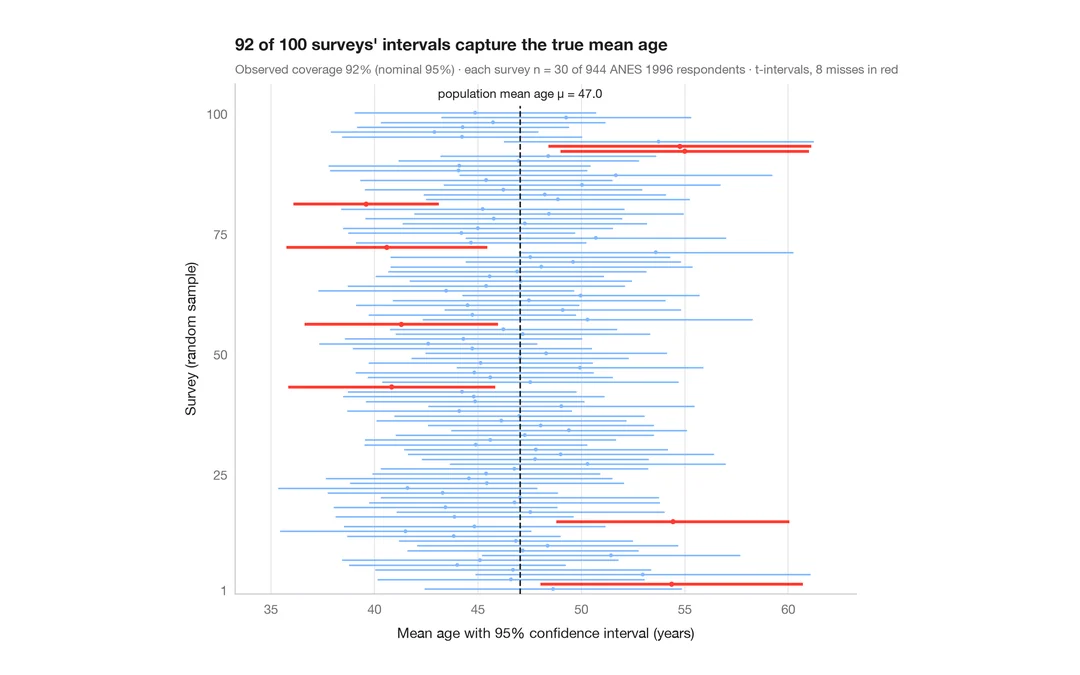
95% 信頼区間の意味
ANES の回答者 944 人から 30 人を抽出する調査を 100 回。平均年齢の 95% 信頼区間のうち真値を外したものを赤で示します。
teaching classic (e.g. TeachingDemos::ci.examp())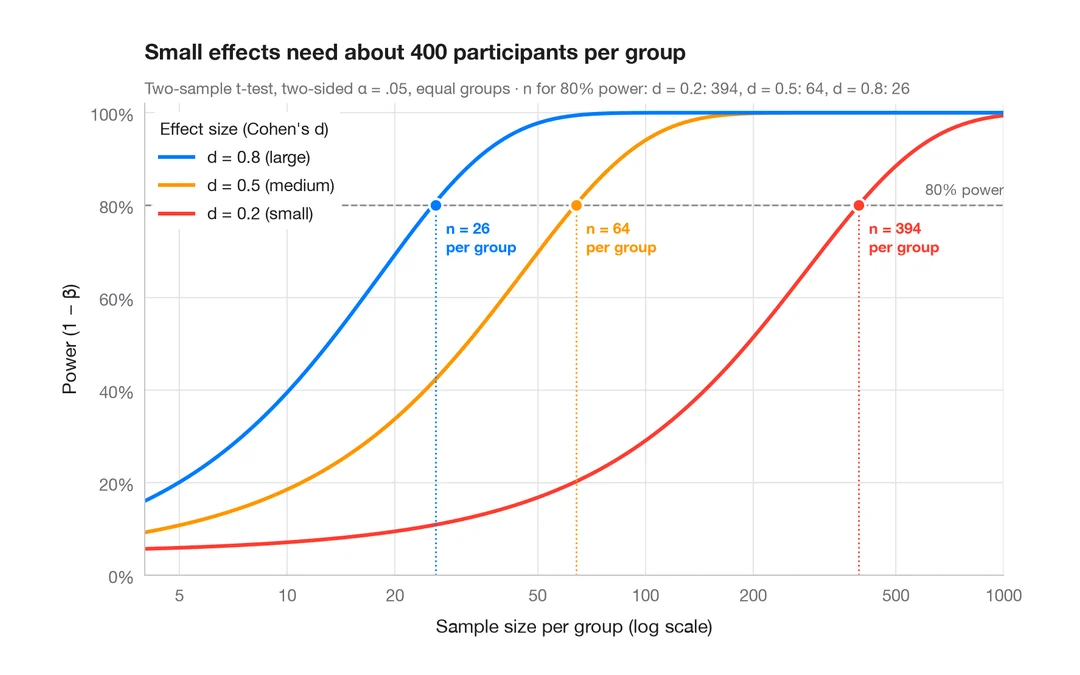
検出力曲線
2標本 t 検定の検出力を、小・中・大の効果量ごとに標本サイズに対して描きます。
pwr::pwr.t.test() + plot()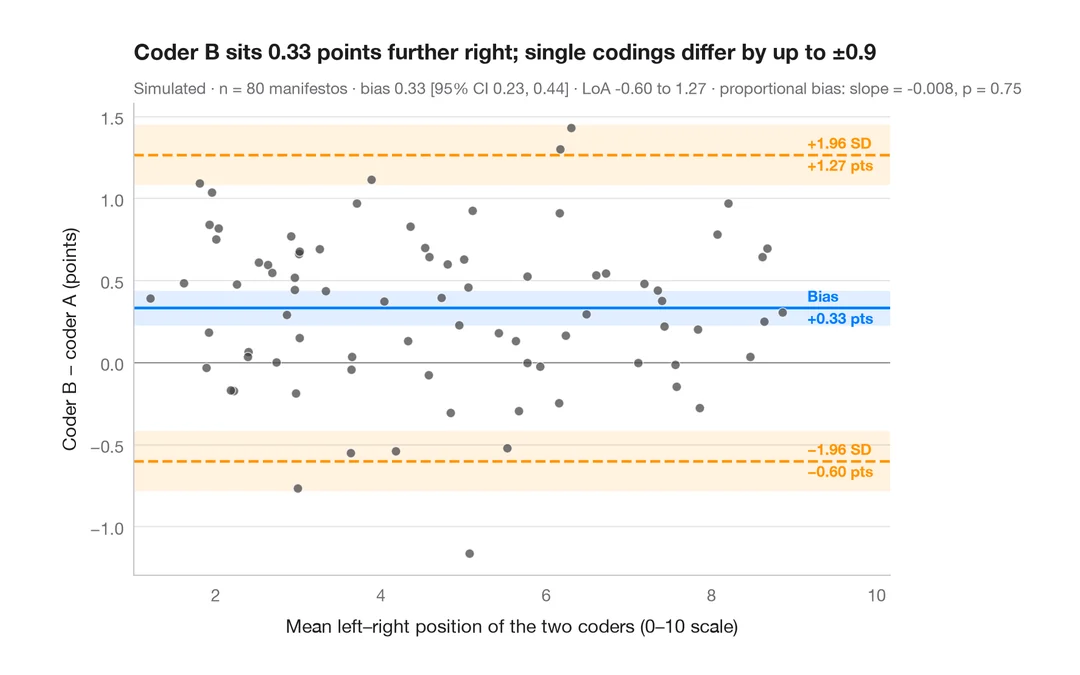
ブランド・アルトマンプロット
2 人のコーダーは政党の選挙綱領を左右軸上に同じように位置づけるか?バイアスと 95% 一致限界。
BlandAltmanLeh::bland.altman.plot() / blandr::blandr.draw()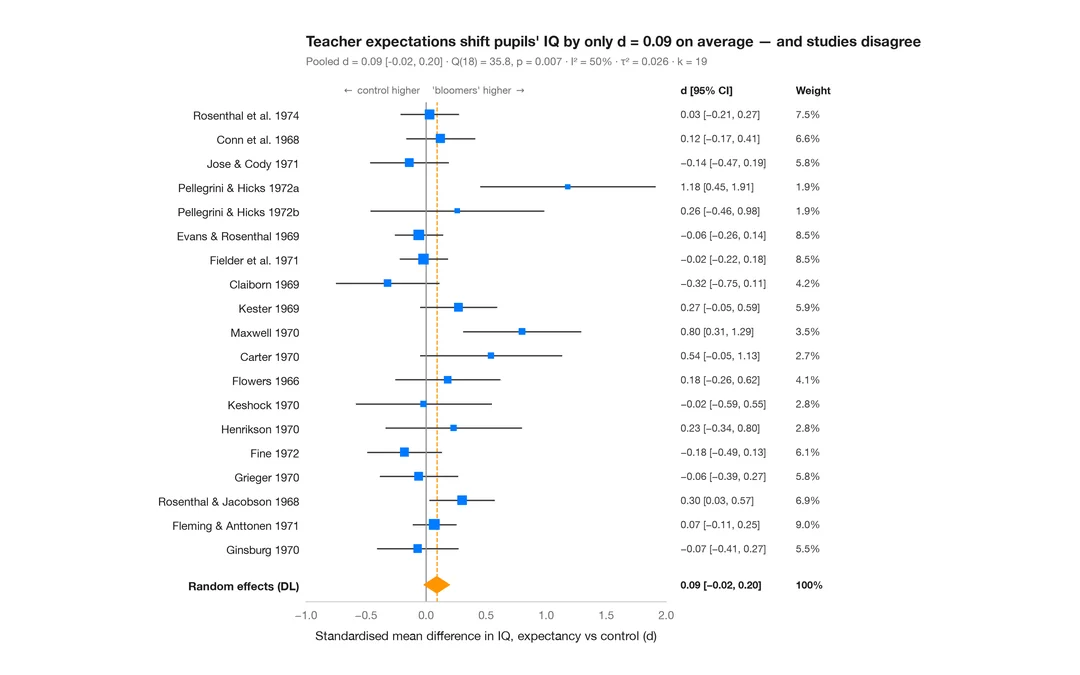
メタアナリシスのフォレストプロット
教師の期待は児童の IQ を高めるか?19 件の「ピグマリオン」実験、変量効果による統合推定のひし形と異質性の統計量。
meta::forest() / metafor::forest()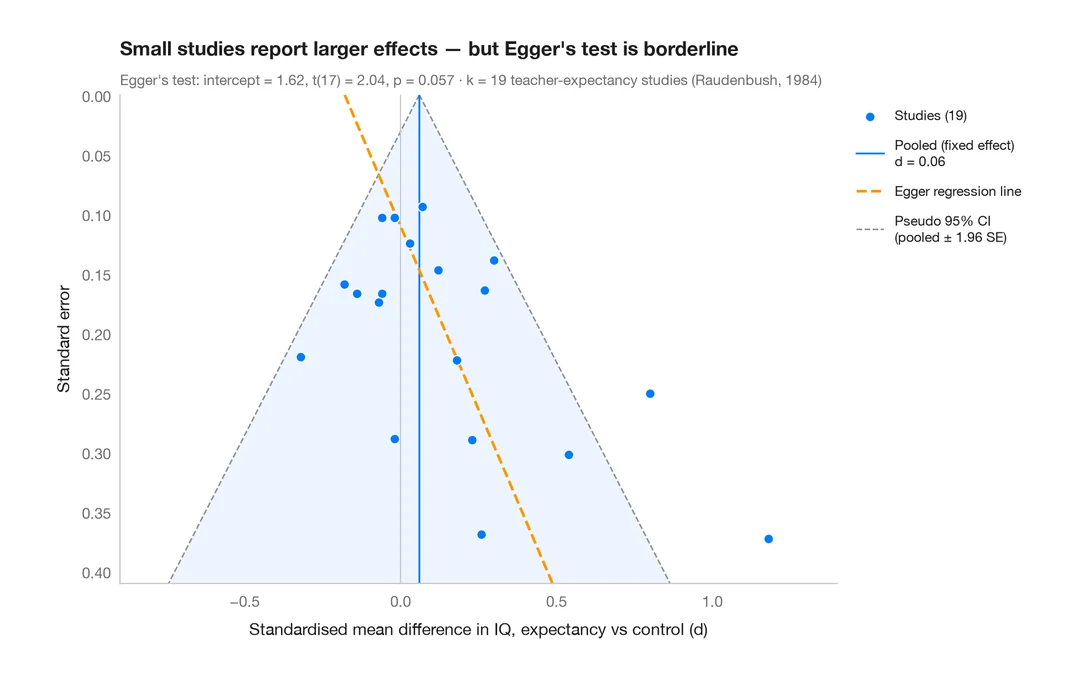
ファンネルプロット
小規模な「ピグマリオン」研究ほど楽観的か?教師期待の効果 19 件を標準誤差に対して描き、疑似 95% ファンネルと Egger 検定を添えます。
metafor::funnel() + metafor::regtest()引用方法
PyStatlas は Thierry Warin が作成・運営しています。研究や業務に役立った場合は、ぜひ引用してください。
Warin, T. (2026). PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}