61 graphiques statistiques · 12 familles · 100 % Python
Science des données sociales.
Élégamment pythonique.
Des graphiques statistiques pour Python, construits sur de vraies données de sciences sociales et rangés selon la question à laquelle ils répondent. L'apprentissage automatique — ce que vaut un modèle et pourquoi il prédit ce qu'il prédit — et les données spatiales — cartes et autocorrélation spatiale — y côtoient les distributions, les comparaisons de groupes, la régression et la survie, et chaque figure affiche les statistiques qui la fondent : estimations, intervalles de confiance, tests, tailles d'effet.
La plupart des ressources Python enseignent d'abord le code et gardent les questions pour plus tard. Cette galerie fait l'inverse. Conçue d'abord pour les étudiants en sciences sociales, elle s'adresse à toute personne qui connaît son domaine et a une question à trancher : ces groupes diffèrent-ils, ces deux variables évoluent-elles ensemble, pourquoi le modèle a-t-il prédit cela ? Partez de la question, trouvez le graphique qui y répond, lisez les statistiques qu'il affiche, et ne prenez que le code dont vous avez besoin.
Aucun graphique ne correspond à votre recherche. Essayez « régression », « enquête », « intervalle de confiance » ou le nom d'une fonction R.
Apprentissage automatique
Le modèle prédit-il bien sur de nouvelles données, et pourquoi ? Évaluation hors échantillon, courbes d'apprentissage et explications indépendantes du modèle — chacune avec son incertitude.

Matrice de confusion avec indicateurs
Dans quelle mesure une régression logistique prédit qui a voté Dole en 1996 — matrice de confusion hors échantillon, avec effectifs et parts par ligne, et intervalles bootstrap pour les principaux indicateurs.
yardstick::conf_mat() + autoplot()
Courbes précision–rappel
Courbes précision–rappel hors échantillon pour deux classifieurs qui prédisent quelles femmes mariées déclarent une liaison, avec précision moyenne et référence sans compétence.
yardstick::pr_curve() + autoplot()
Courbe d'apprentissage
Exactitude d'entraînement et en validation croisée à mesure que l'échantillon d'entraînement grandit, pour deux modèles qui prédisent quelles femmes mariées déclarent une liaison.
caret::learning_curve_dat() + ggplot()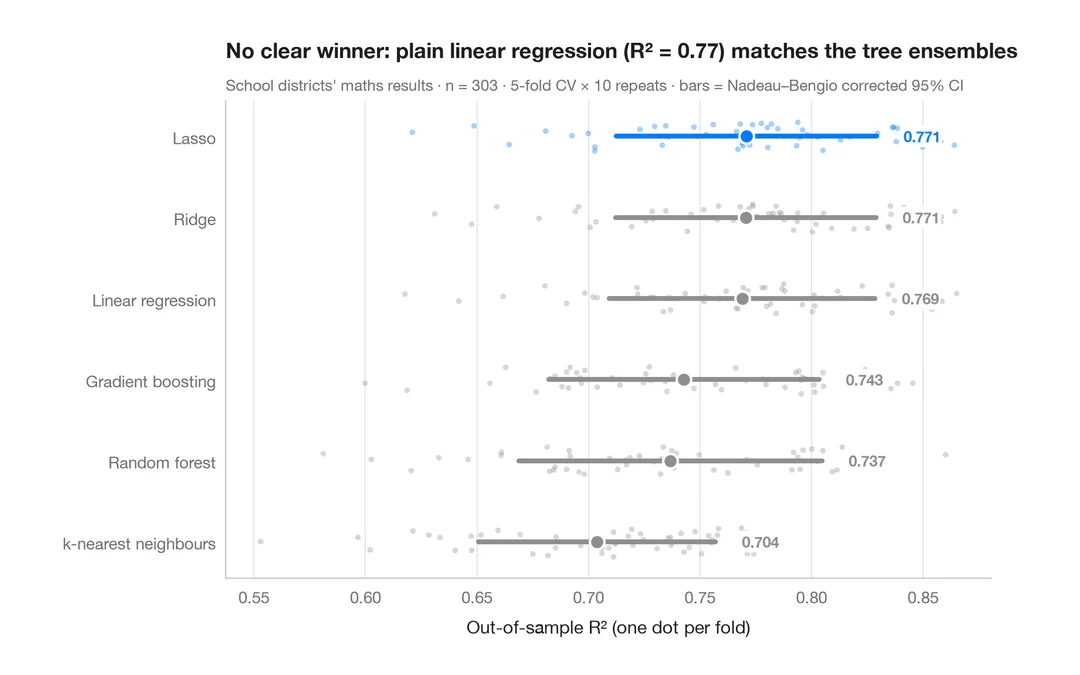
Comparaison de modèles en validation croisée
R² pli par pli de six modèles qui prédisent les résultats en mathématiques des districts scolaires californiens, avec moyennes et intervalles à 95 % corrigés.
caret::resamples() + bwplot() / tune::autoplot()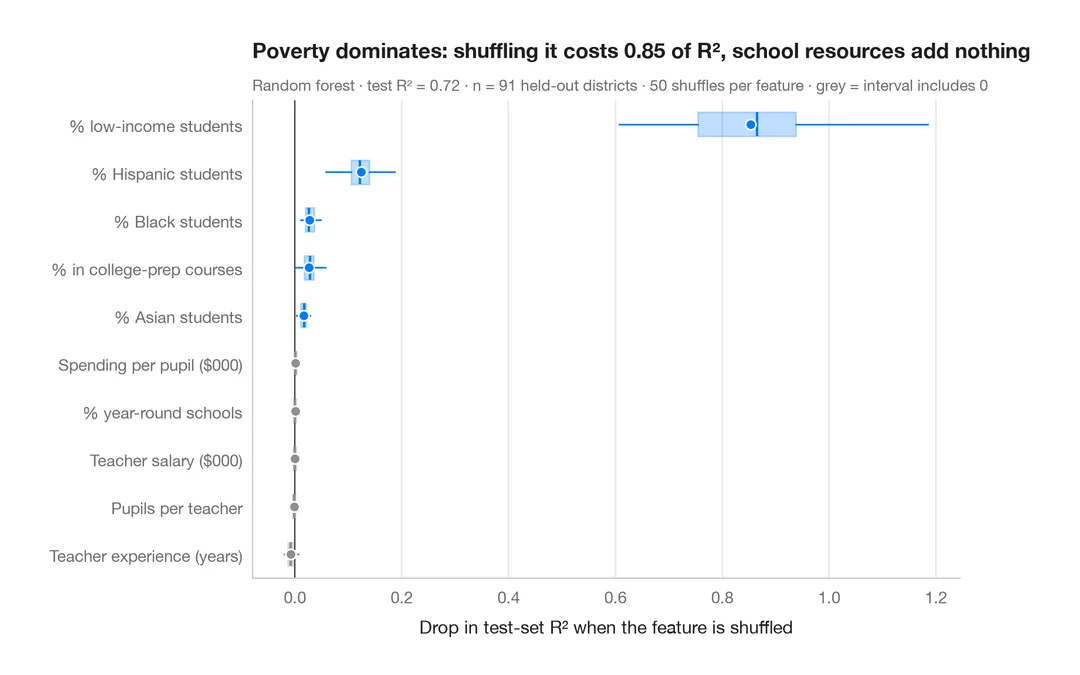
Importance par permutation
Les caractéristiques des districts sur lesquelles s'appuie une forêt aléatoire pour prédire les résultats en mathématiques — baisse du R² sur l'échantillon test quand chacune est permutée.
vip::vip(method = "permute")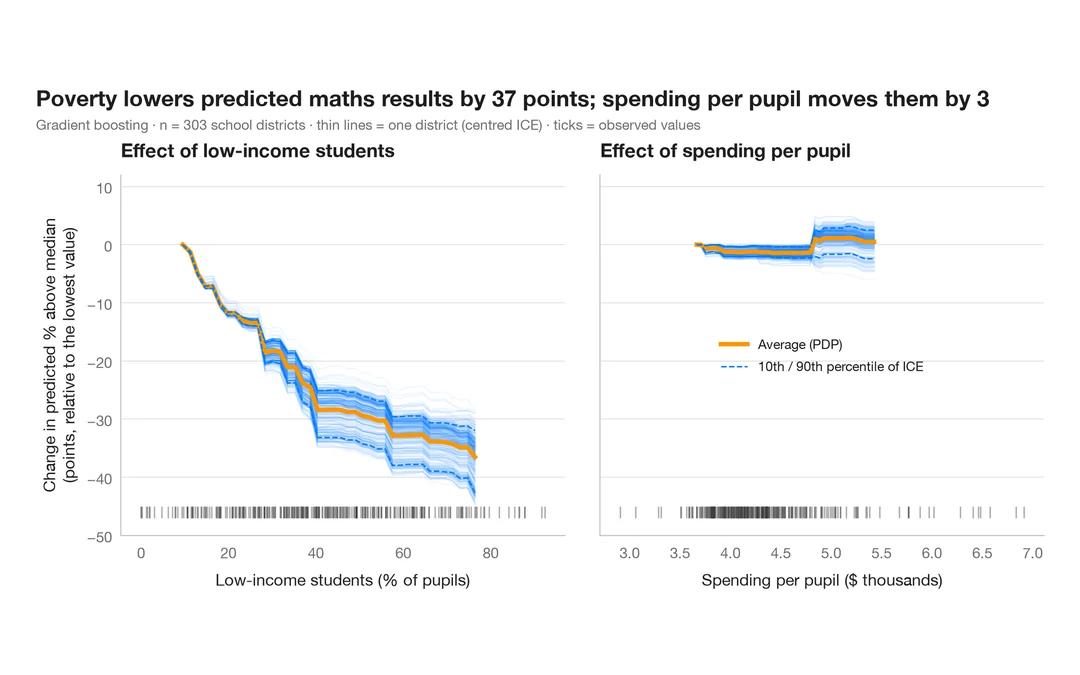
Dépendance partielle avec courbes ICE
Comment les résultats prédits en mathématiques varient avec la pauvreté et avec la dépense par élève — la moyenne (PDP) sur une courbe par district scolaire (ICE).
pdp::partial(ice = TRUE) + autoplot() / iml::FeatureEffectAvancé : explications SHAP
Les valeurs de Shapley décomposent chaque prédiction en contributions additives des variables — globalement, variable par variable, et pour un cas unique.
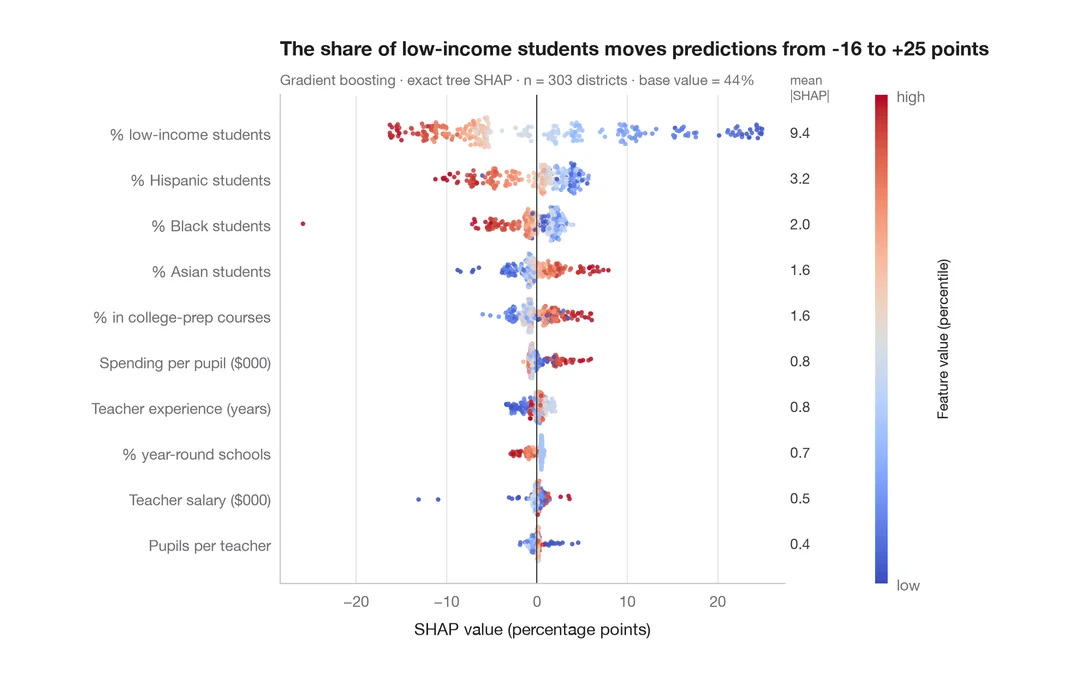
Synthèse SHAP (essaim)
La valeur SHAP de chaque district scolaire pour chaque caractéristique, colorée selon la valeur de la caractéristique, avec l'importance moyenne |SHAP|.
shapviz::sv_importance(kind = "beeswarm")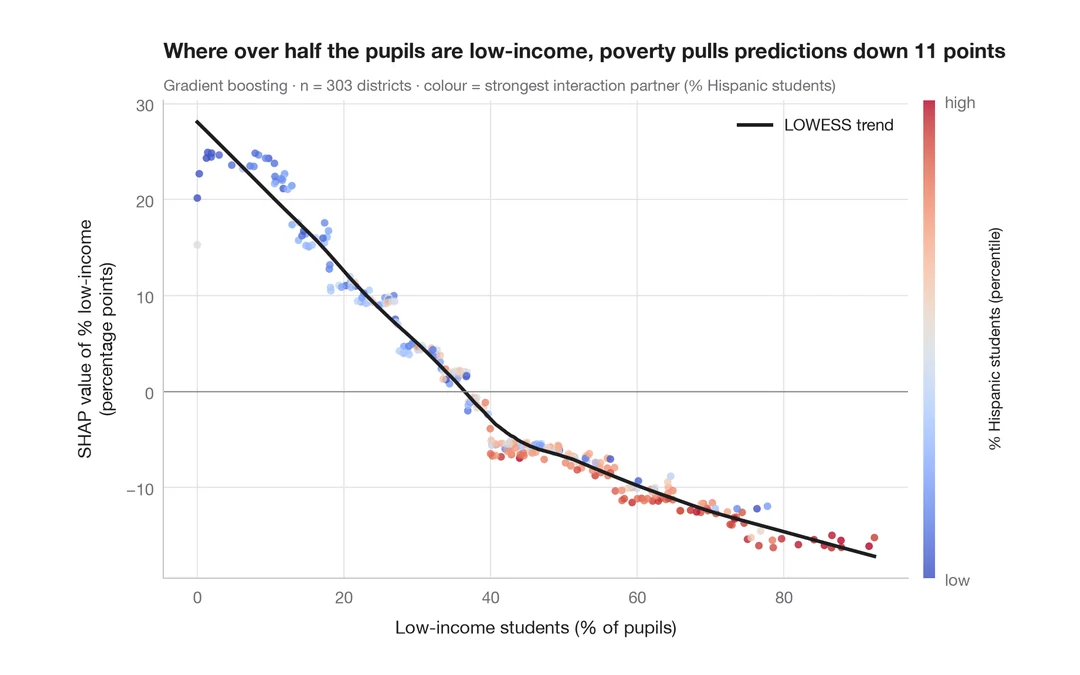
Graphique de dépendance SHAP
Comment la part d'élèves à faible revenu pèse sur les résultats prédits en mathématiques de chaque district, colorée selon son principal partenaire d'interaction, avec une tendance lissée.
shapviz::sv_dependence()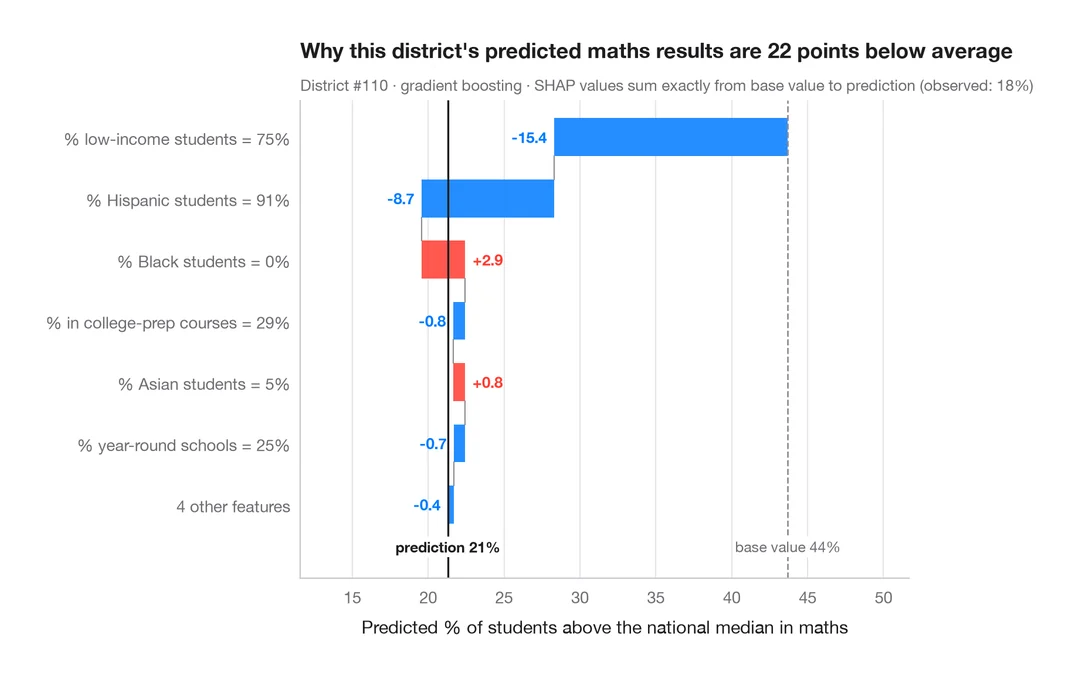
Cascade SHAP pour une prédiction
Comment chaque caractéristique déplace les résultats prédits en mathématiques d'un district scolaire en difficulté, de la moyenne jusqu'à la sortie du modèle.
shapviz::sv_waterfall()Données spatiales
Une valeur est-elle plus élevée là où celle des voisins l'est aussi ? Pondérations spatiales, autocorrélation spatiale globale et locale, et portée des regroupements — sur la France de Guerry, vers 1830.
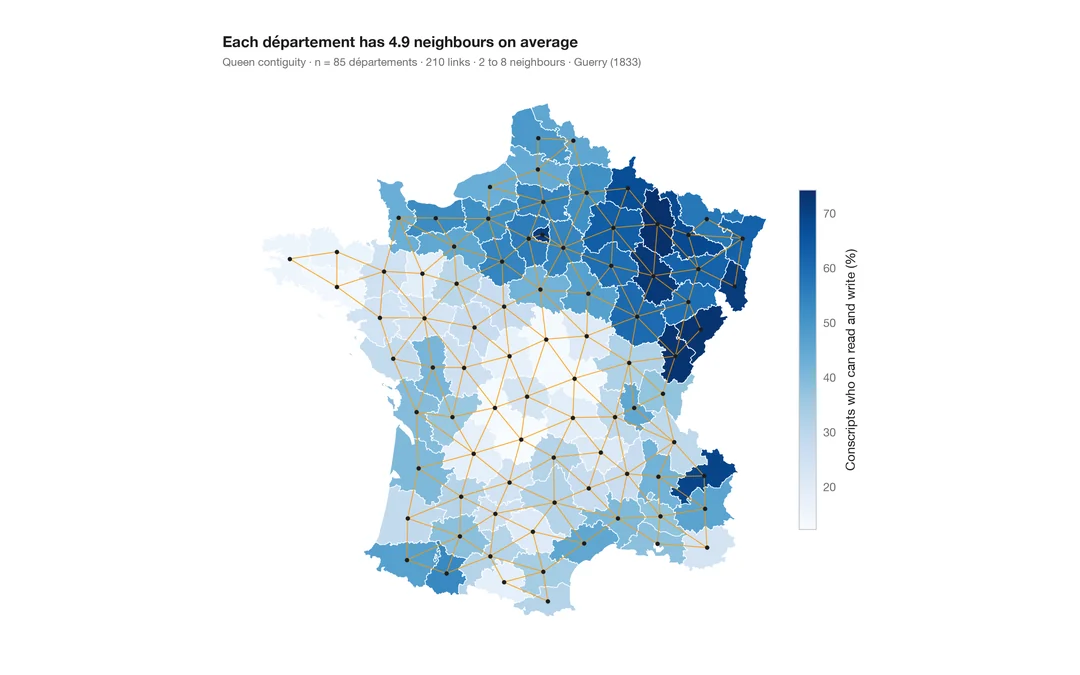
Carte choroplèthe avec pondérations spatiales
Une carte d'une variable avec, par-dessus, le réseau des voisins — la structure sur laquelle repose toute statistique spatiale.
spdep::poly2nb() + plot(nb, coords)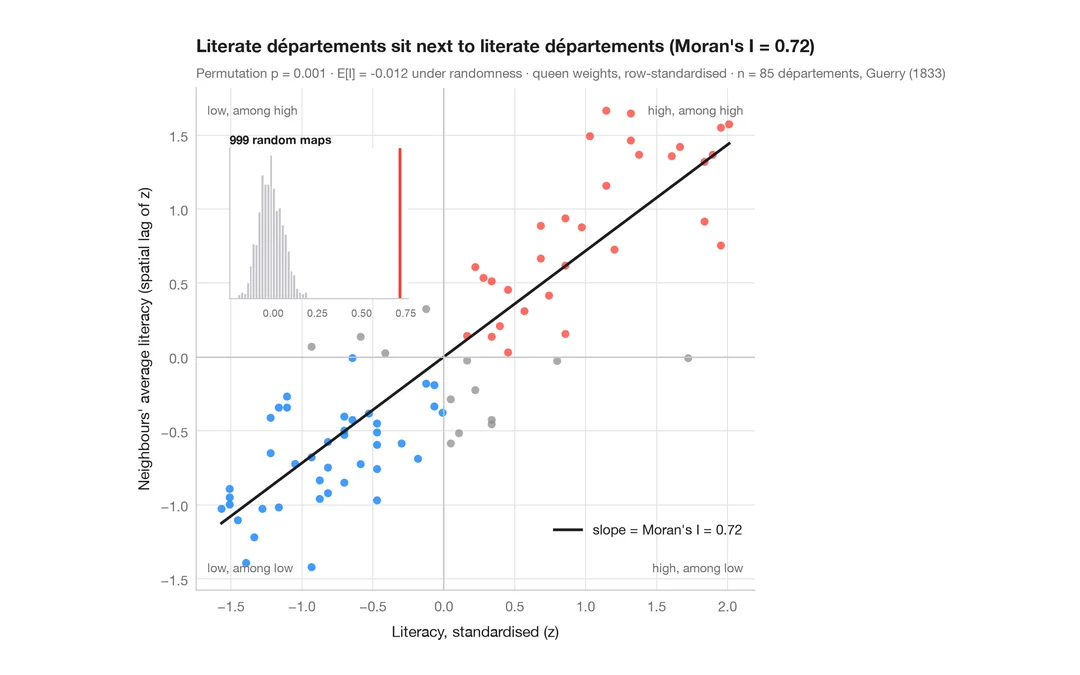
Diagramme de Moran (autocorrélation globale)
Chaque zone face à la moyenne de ses voisines, avec le I de Moran, son test par permutation et la distribution de référence.
spdep::moran.plot() + spdep::moran.mc()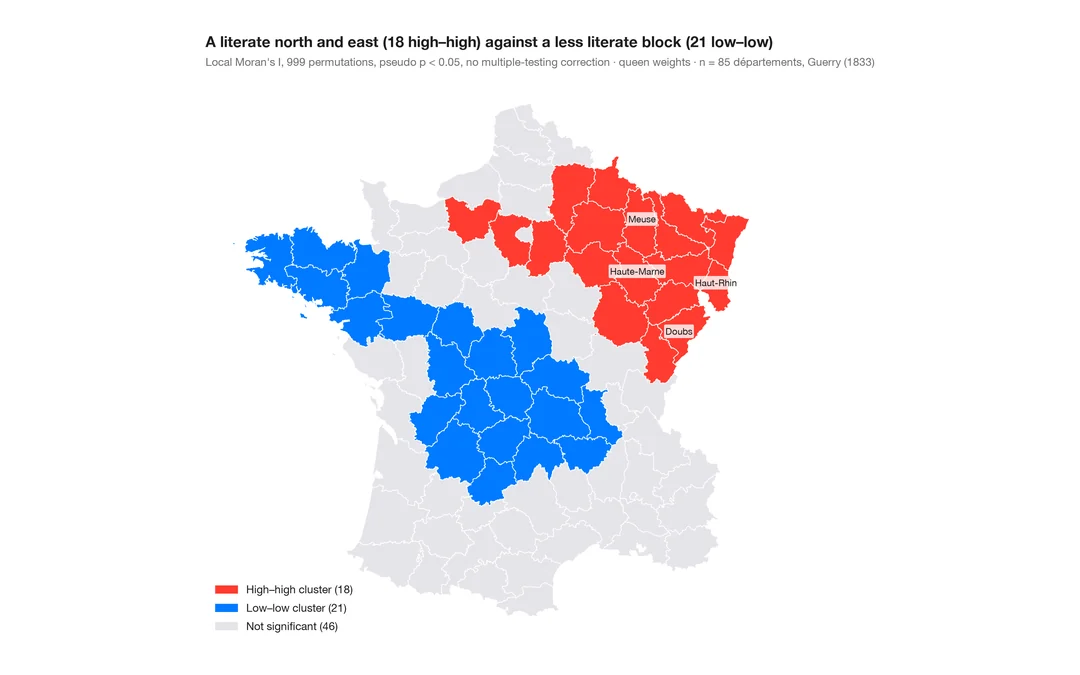
Carte des regroupements LISA (autocorrélation locale)
Où se trouvent les regroupements et les valeurs atypiques spatiales — I de Moran local pour chaque zone, cartographié avec sa significativité par permutation.
spdep::localmoran_perm() / rgeoda::local_moran()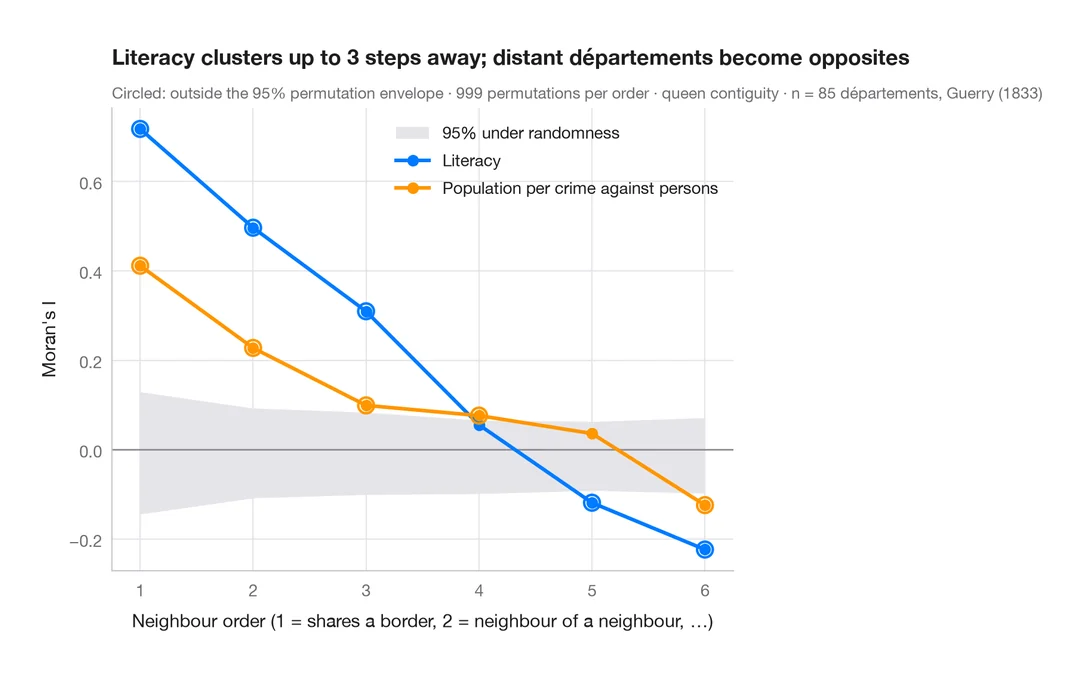
Corrélogramme spatial
Le I de Moran à des ordres de voisinage croissants, avec une enveloppe de permutation — jusqu'où porte le regroupement spatial.
spdep::sp.correlogram(method = "I")Distributions
Visualisez la forme de vos données : histogrammes, densités, graphiques en crêtes, fonctions de répartition empiriques et diagrammes Q–Q.
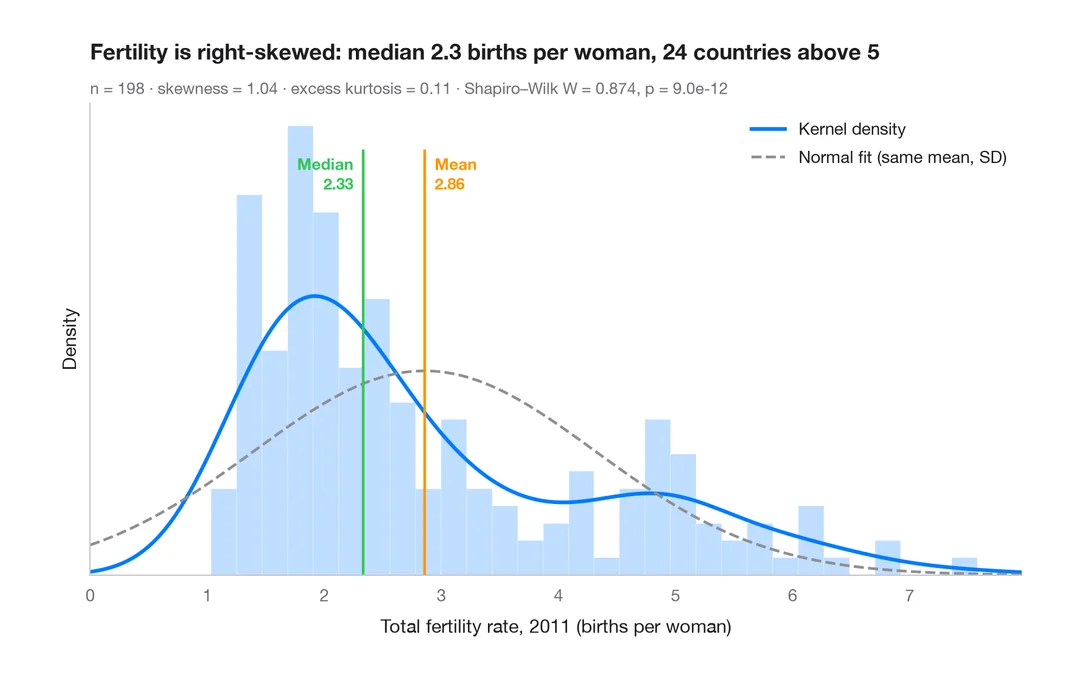
Histogramme avec densité
Histogramme, densité par noyau et courbe normale ajustée, avec statistiques de forme.
ggplot2::geom_histogram() + geom_density()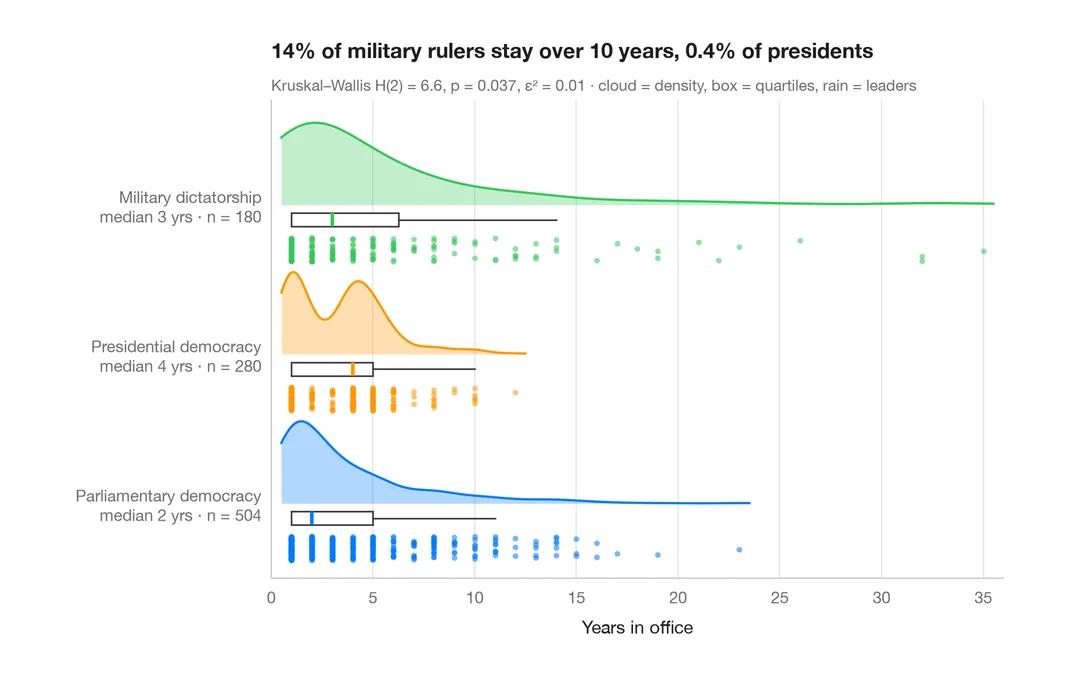
Graphique en nuage de pluie
Demi-violon, boîte à moustaches et points bruts par groupe, tracés à l'horizontale.
ggdist::stat_halfeye() / ggrain::geom_rain()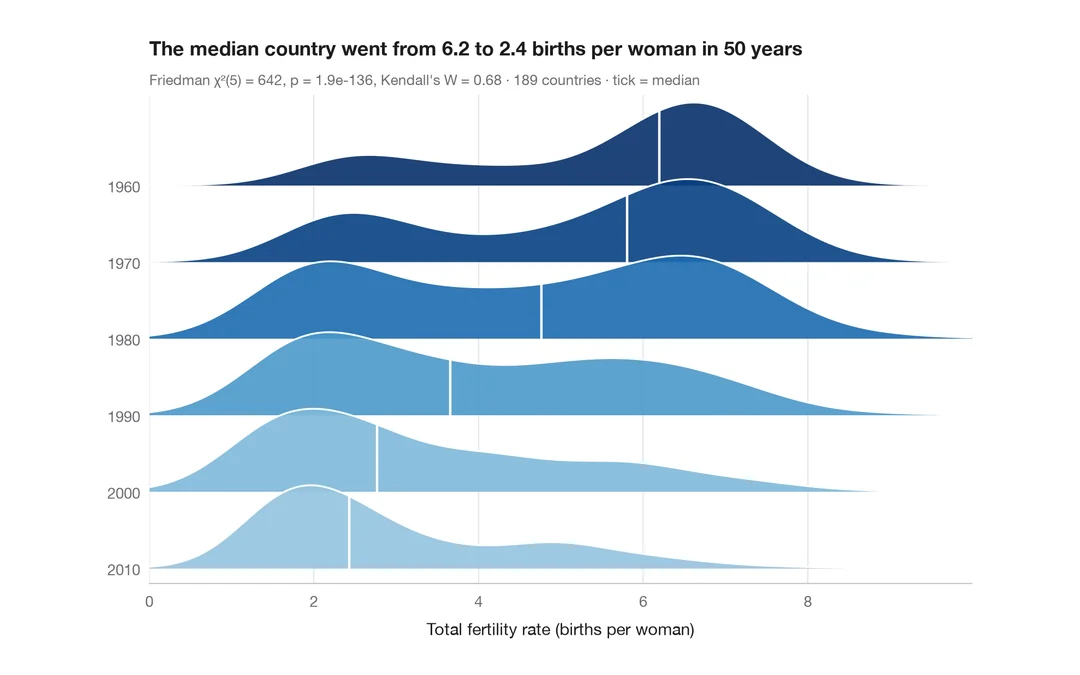
Graphique en crêtes
Courbes de densité qui se chevauchent pour comparer une distribution entre de nombreux groupes.
ggridges::geom_density_ridges()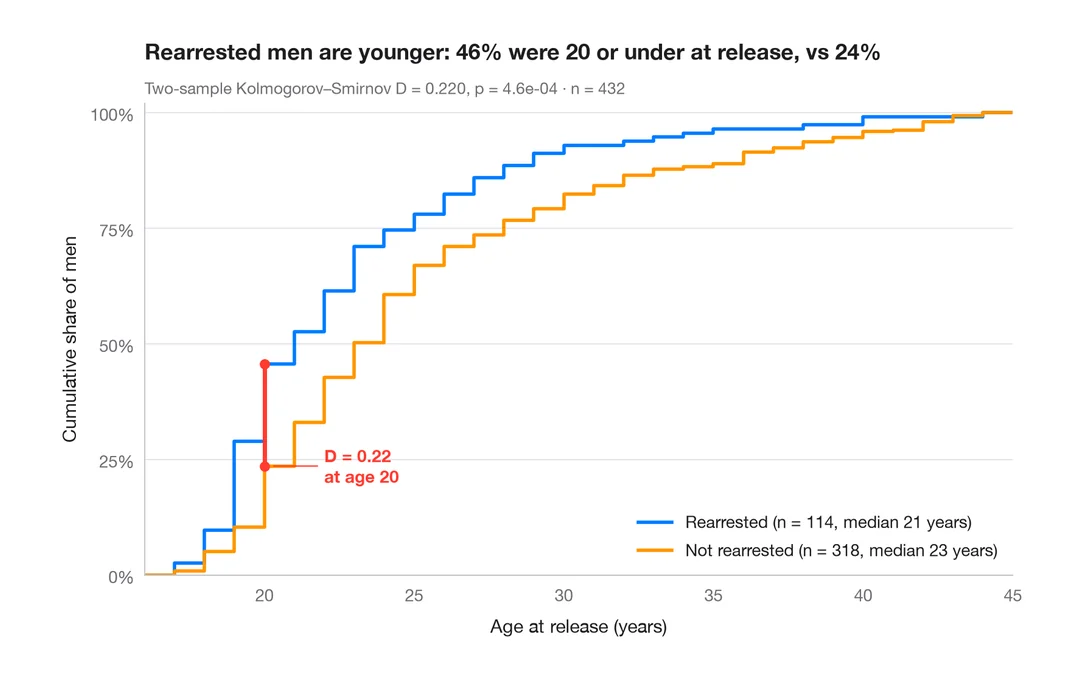
Comparaison de fonctions de répartition empiriques
Fonctions de répartition empiriques de deux groupes, avec l'écart de Kolmogorov–Smirnov.
ggplot2::stat_ecdf()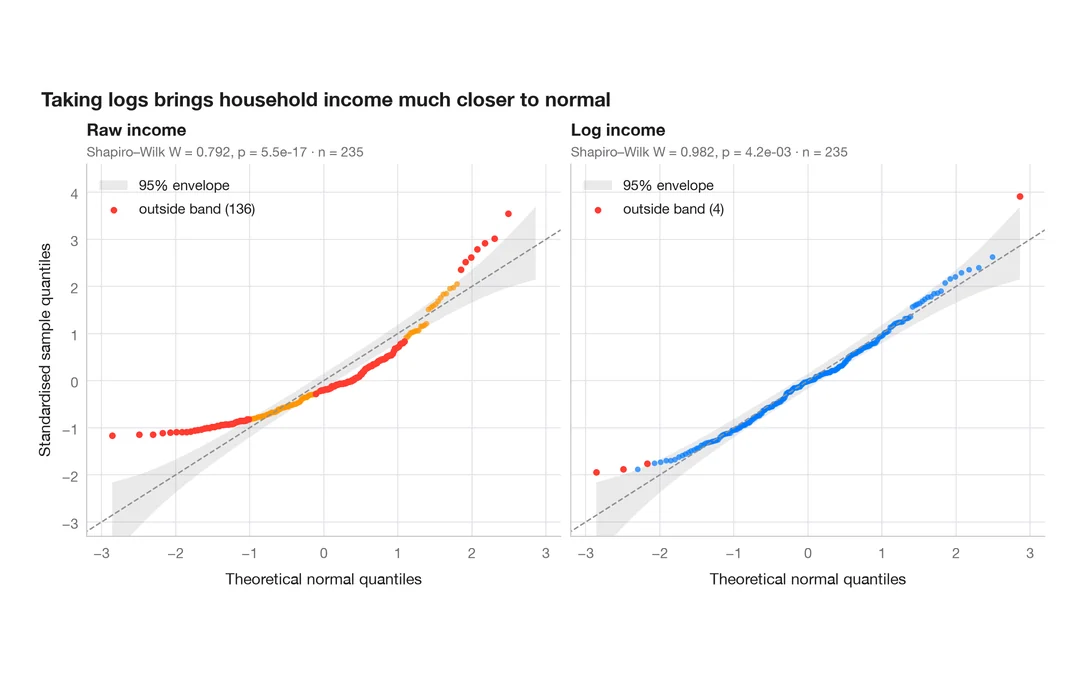
Diagramme Q–Q avec bande de confiance
Diagrammes quantile-quantile normaux avec enveloppe à 95 %, pour une variable brute et sa version logarithmique.
qqplotr::stat_qq_band()Comparaisons de groupes
Comparez des groupes avec le test, la taille d'effet et les valeurs p sur le graphique — à la manière de ggstatsplot.
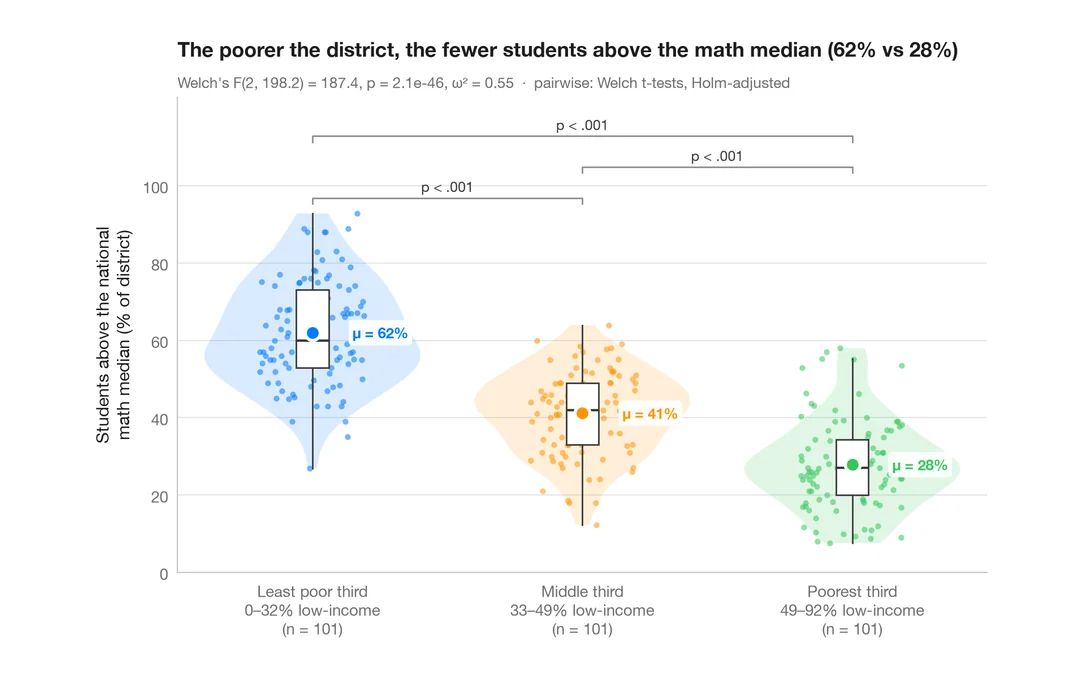
Comparaison entre groupes
Violon, boîte et points avec ANOVA de Welch, taille d'effet et tests deux à deux.
ggstatsplot::ggbetweenstats()
Comparaison intra-sujets
Mesures répétées avec une ligne par sujet, moyennes, ANOVA à mesures répétées et tests appariés.
ggstatsplot::ggwithinstats()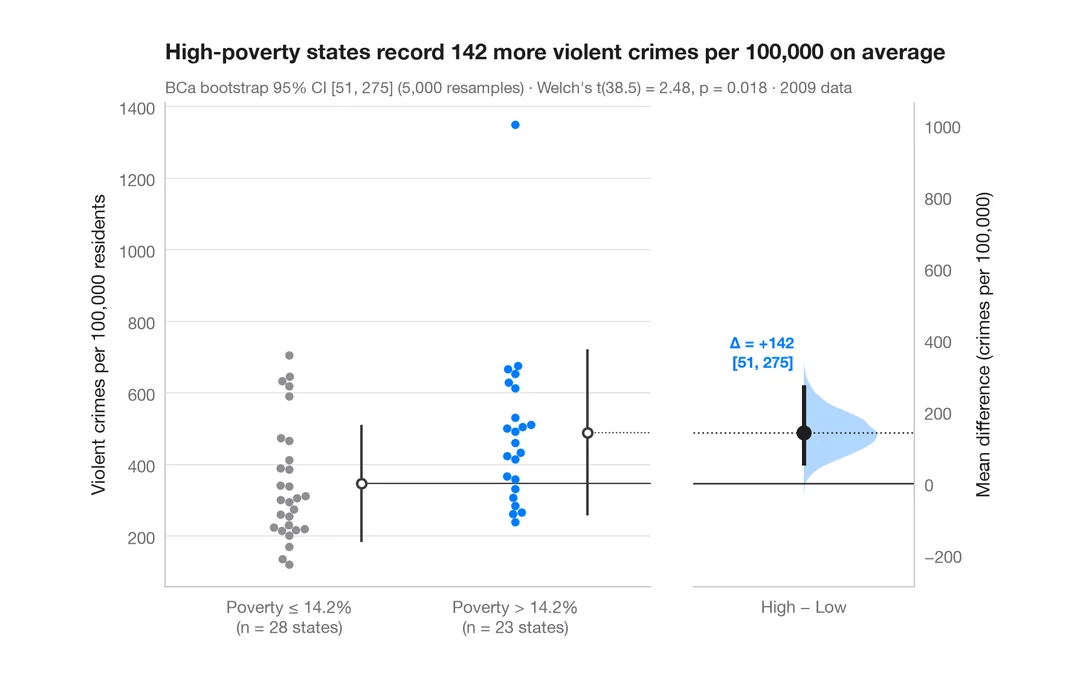
Graphique d'estimation
Données brutes de deux groupes, avec la différence de moyennes et son IC à 95 % par bootstrap.
dabestr::dabest() + plot()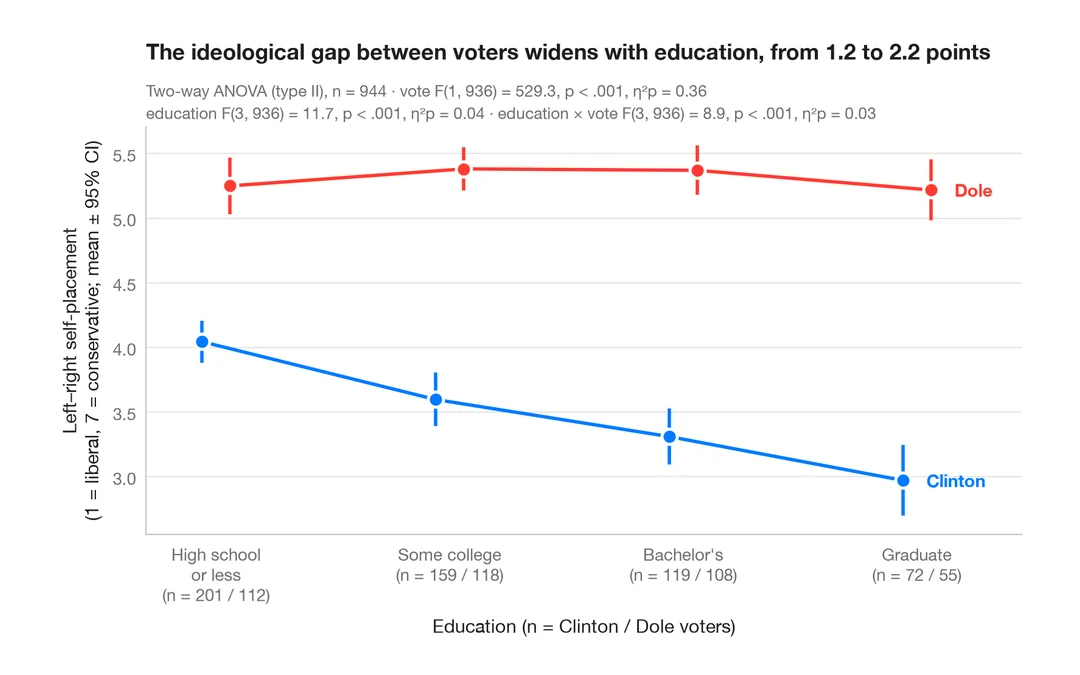
Graphique d'interaction
Moyennes de groupes avec intervalles de confiance à 95 % pour deux facteurs, avec ANOVA à deux facteurs.
ggpubr::ggline(add = "mean_ci") / ggstats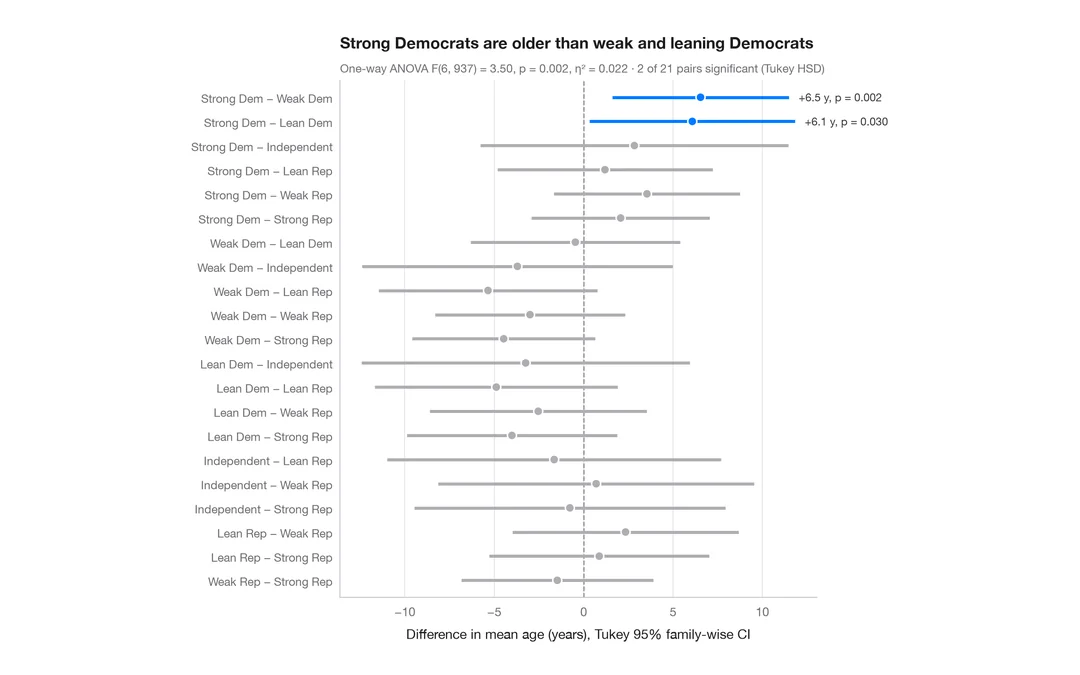
Intervalles HSD de Tukey
Intervalles de confiance simultanés à 95 % pour chaque différence de moyennes deux à deux.
TukeyHSD() + plot()Proportions et enquêtes
Proportions, tableaux croisés et échelles de Likert, dans l'esprit de ggstats::gglikert et stat_prop.
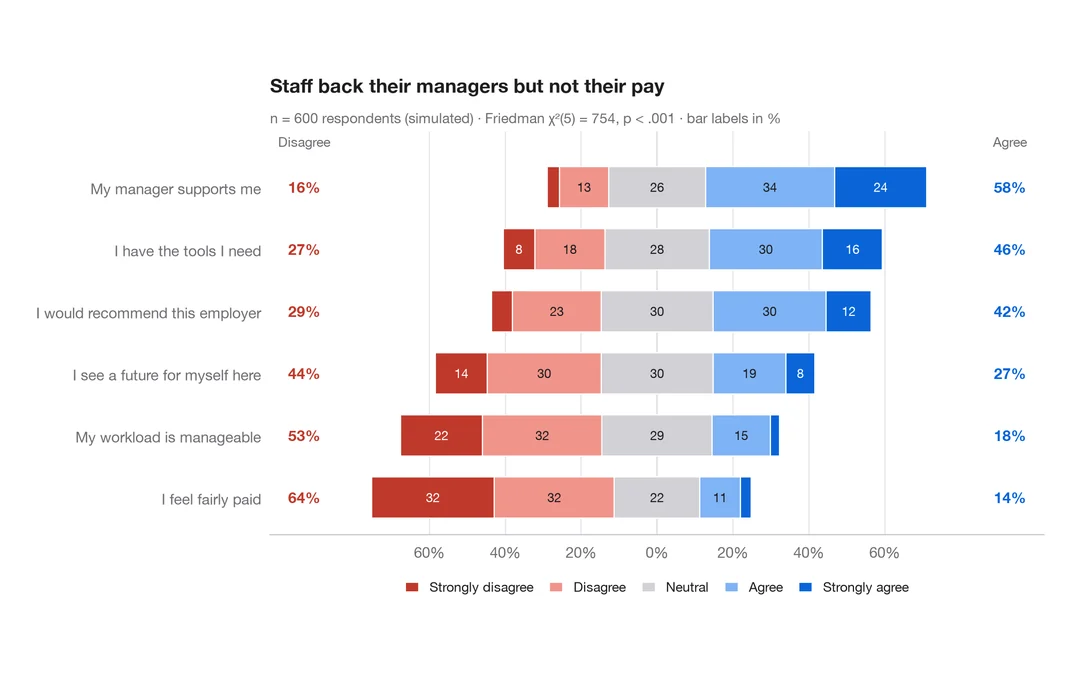
Graphique de Likert divergent
Items de Likert à cinq niveaux en barres empilées divergentes, centrées sur la réponse neutre.
ggstats::gglikert()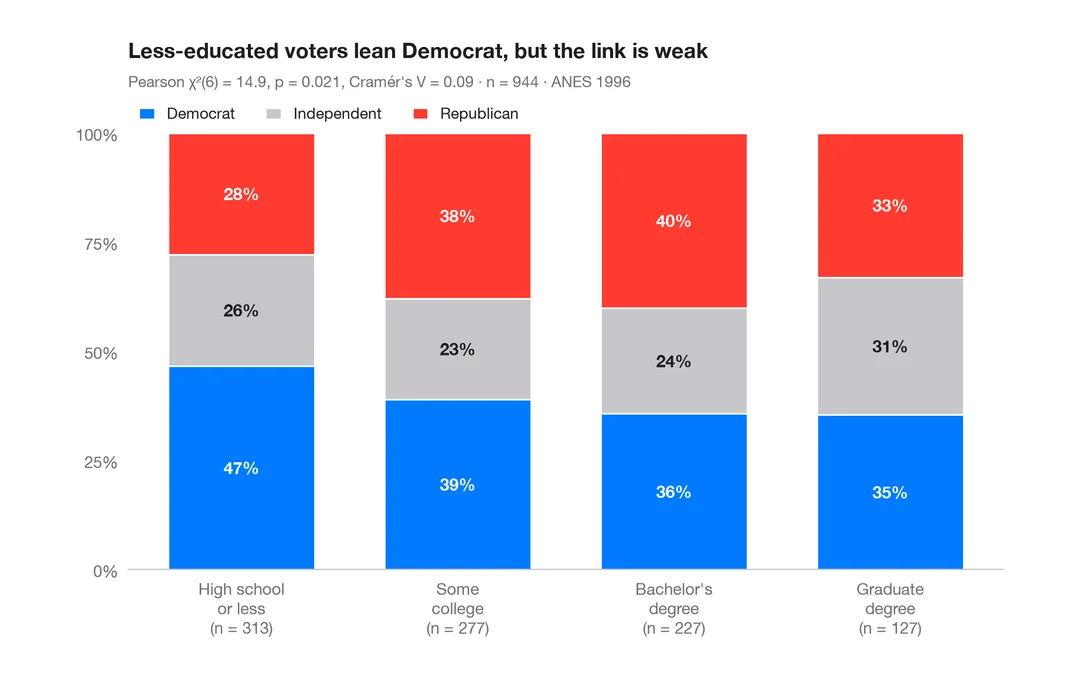
Proportions empilées par groupe
Barres empilées à 100 % avec pourcentages, n par barre, test du khi-deux et V de Cramér.
ggstatsplot::ggbarstats()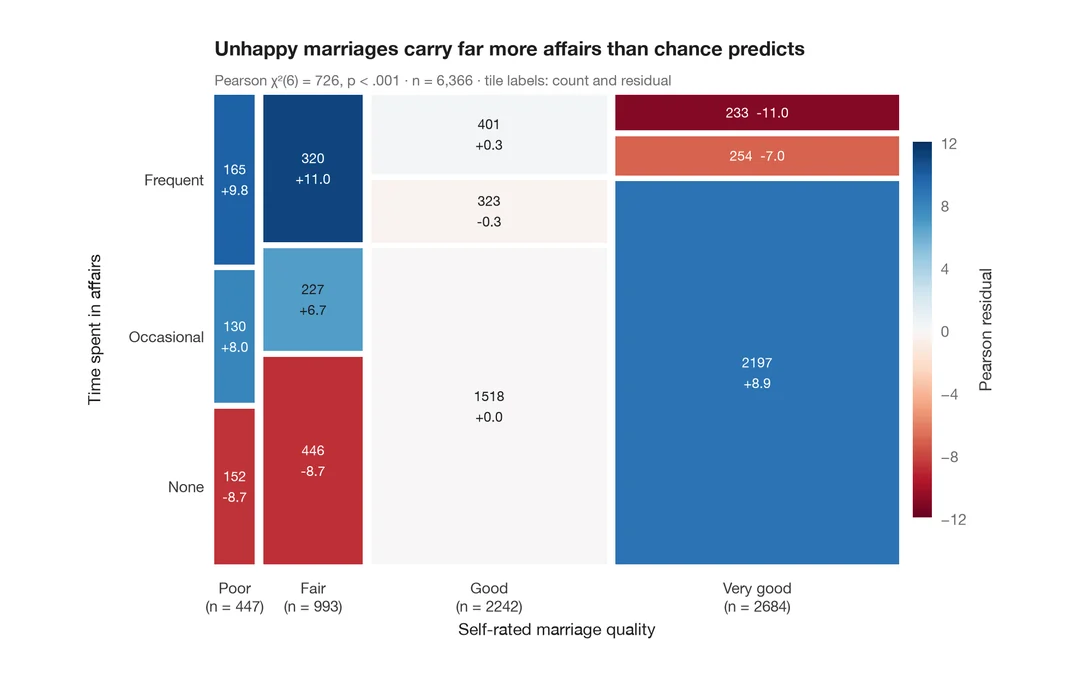
Diagramme en mosaïque avec résidus de Pearson
Aires des tuiles proportionnelles aux effectifs, colorées selon les résidus de Pearson par rapport à l'indépendance.
vcd::mosaic(shade = TRUE)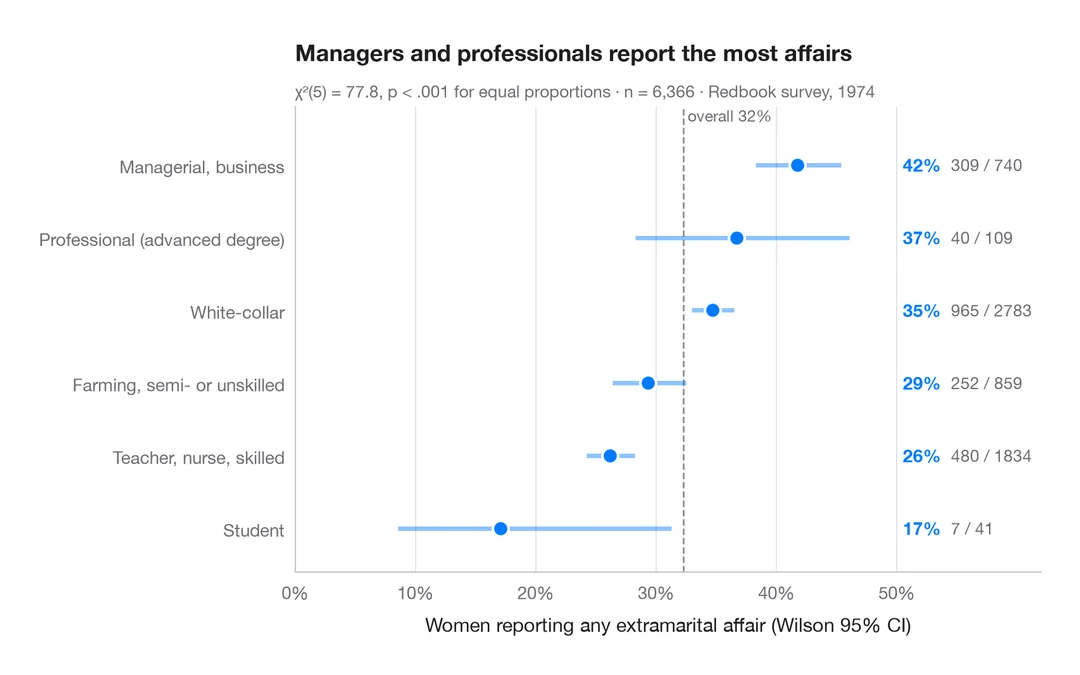
Proportions avec intervalles de confiance
Diagramme en points trié des proportions par groupe, avec intervalles de confiance de Wilson à 95 %.
ggstats::stat_prop() + geom_errorbar()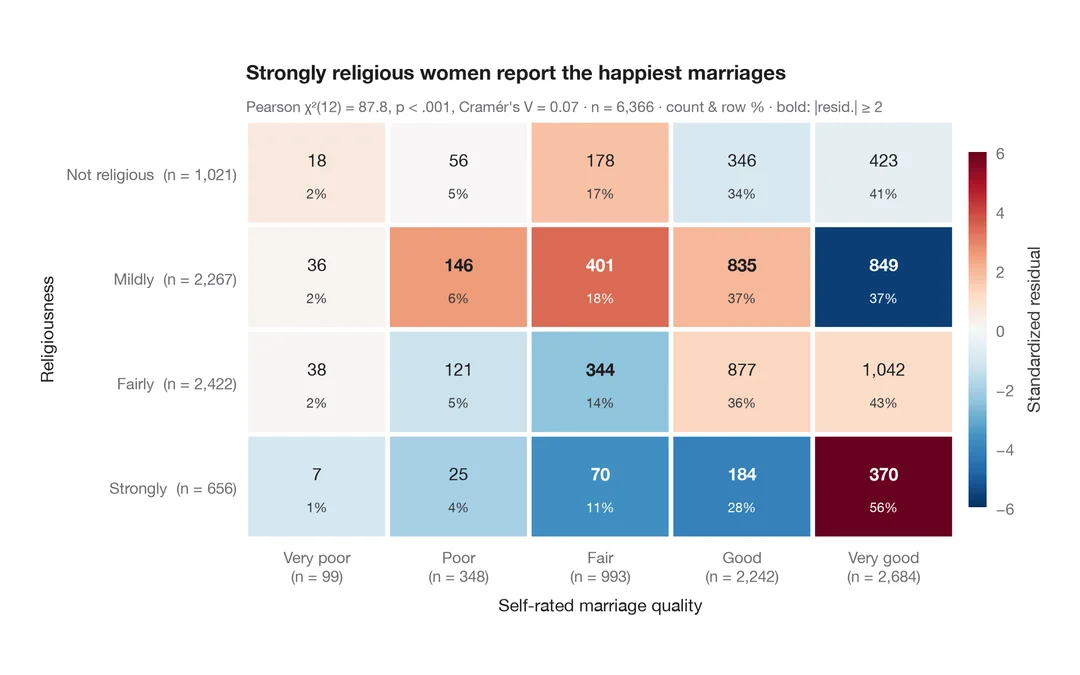
Tableau croisé avec résidus standardisés
Un tableau de contingence en carte de chaleur, coloré selon les résidus standardisés par rapport à l'indépendance.
ggstats::ggtable() / stat_cross()Corrélation et association
Matrices de corrélation, nuages de points avec statistiques et relations deux à deux.
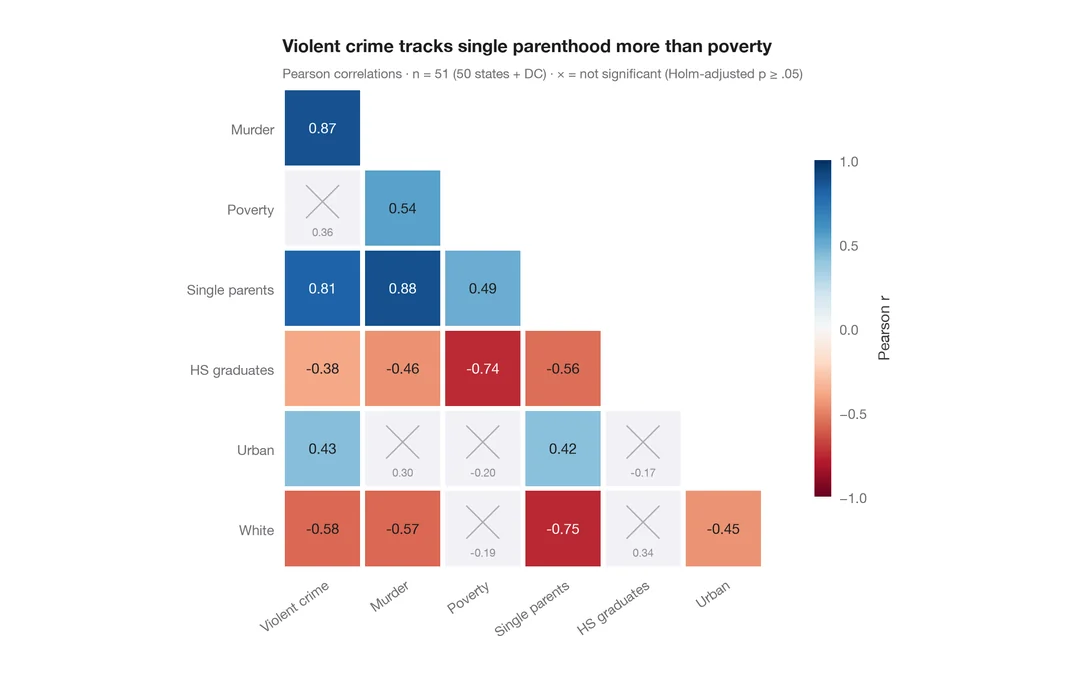
Matrice de corrélation
Carte de chaleur triangulaire des corrélations de Pearson ; les cellules non significatives (Holm) sont barrées.
ggstatsplot::ggcorrmat()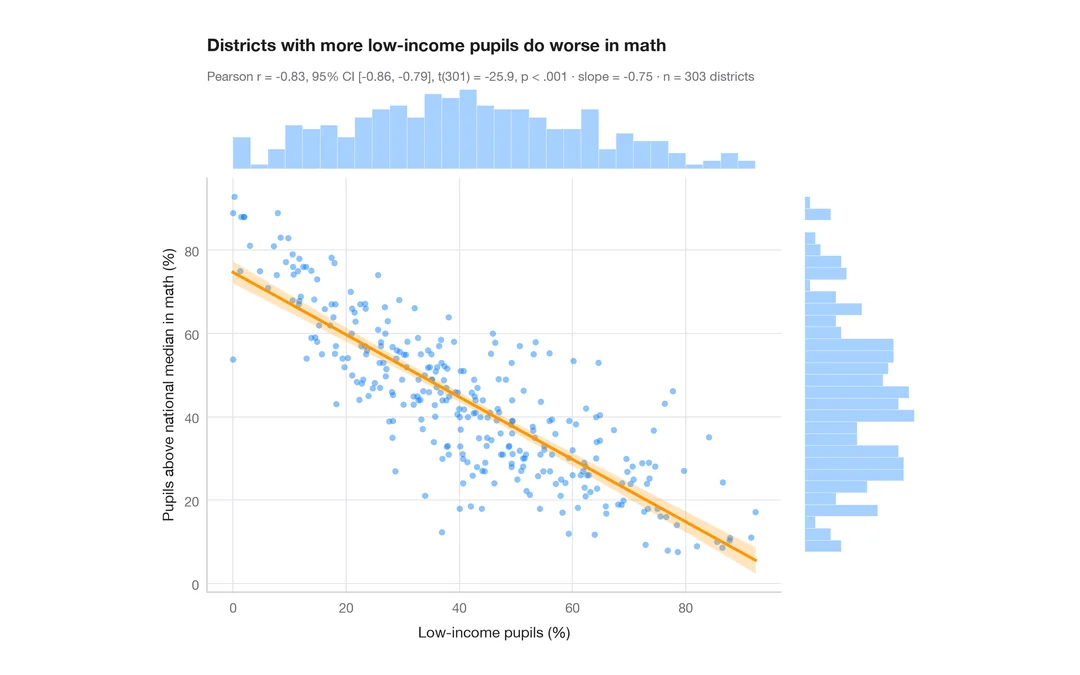
Nuage de points avec statistiques
Part d'élèves à faible revenu et résultats en mathématiques dans 303 districts californiens — nuage de points, droite des MCO avec bande à 95 %, histogrammes marginaux et r de Pearson.
ggstatsplot::ggscatterstats()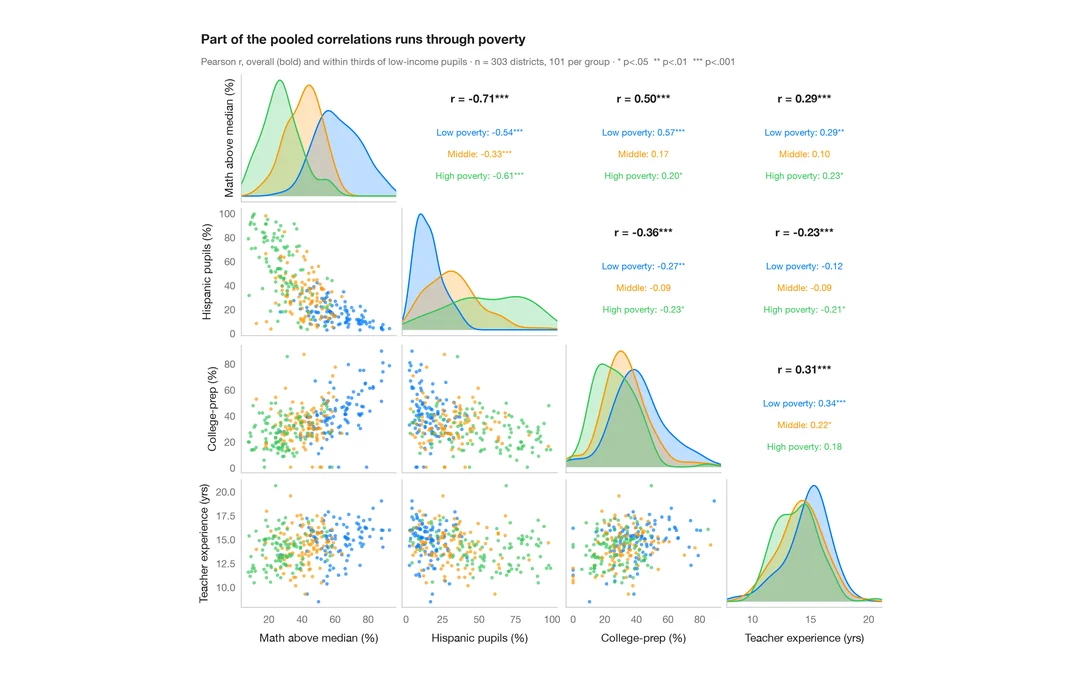
Matrice de nuages de points avec corrélations
Matrice de nuages de points de quatre variables de districts scolaires, avec densités par groupe sur la diagonale et corrélations globales et intragroupes au-dessus.
GGally::ggpairs()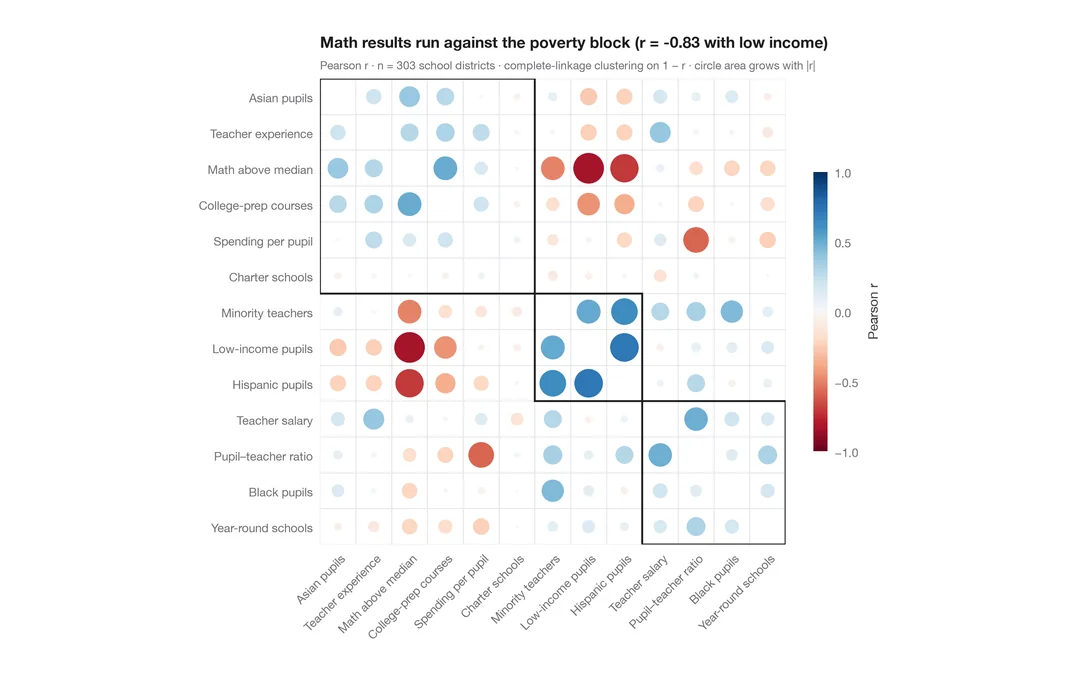
Corrélogramme avec classification
Cercles à la corrplot, dimensionnés et colorés selon r pour 13 indicateurs de districts scolaires, ordonnés par classification hiérarchique.
corrplot::corrplot(order = "hclust", addrect = 3)Modèles de régression
Graphiques de coefficients, rapports de cotes, comparaison de modèles et effets marginaux — ggcoef_model pour Python.

Graphique des coefficients
Estimations de régression avec intervalles de confiance à 95 %, une ligne par terme.
ggstats::ggcoef_model()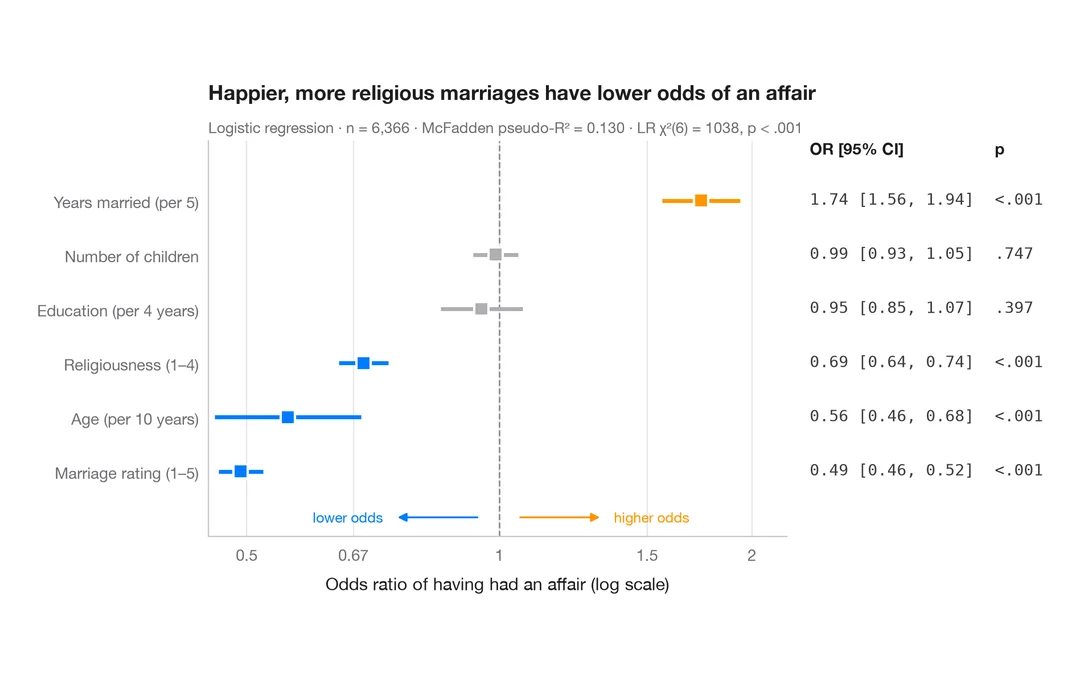
Graphique en forêt des rapports de cotes
Rapports de cotes d'une régression logistique sur échelle logarithmique, accompagnés d'un tableau RC [IC à 95 %].
ggstats::ggcoef_model(exponentiate = TRUE)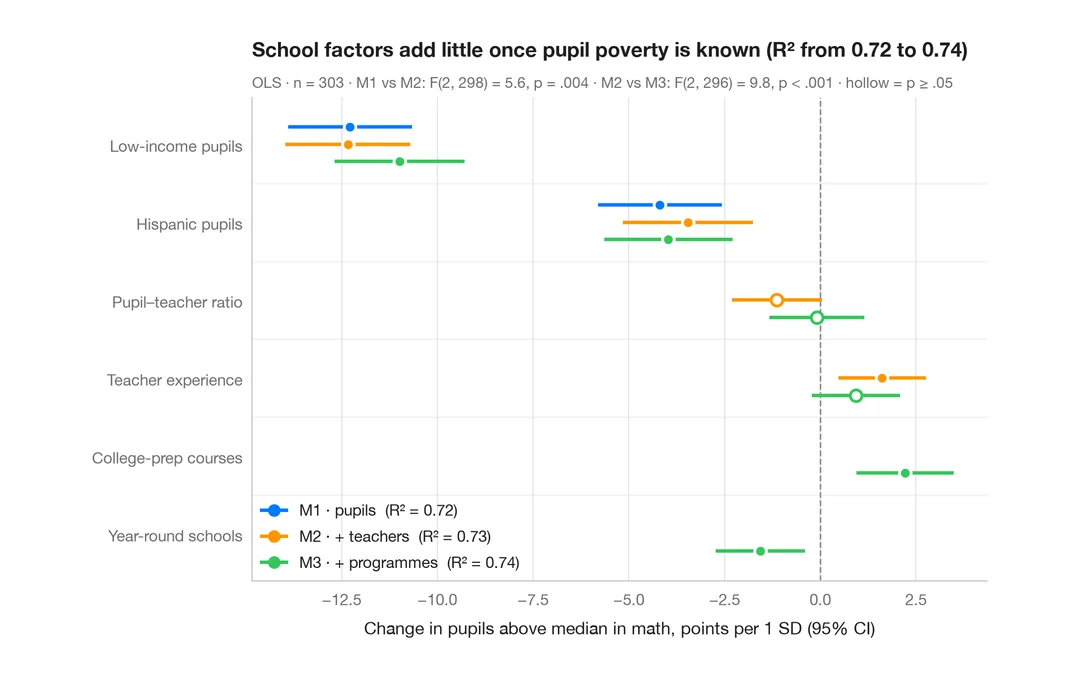
Comparaison de modèles emboîtés
Coefficients de trois régressions emboîtées des résultats en mathématiques des districts, côte à côte, pour voir comment les estimations bougent à mesure que des blocs sont ajoutés.
ggstats::ggcoef_compare()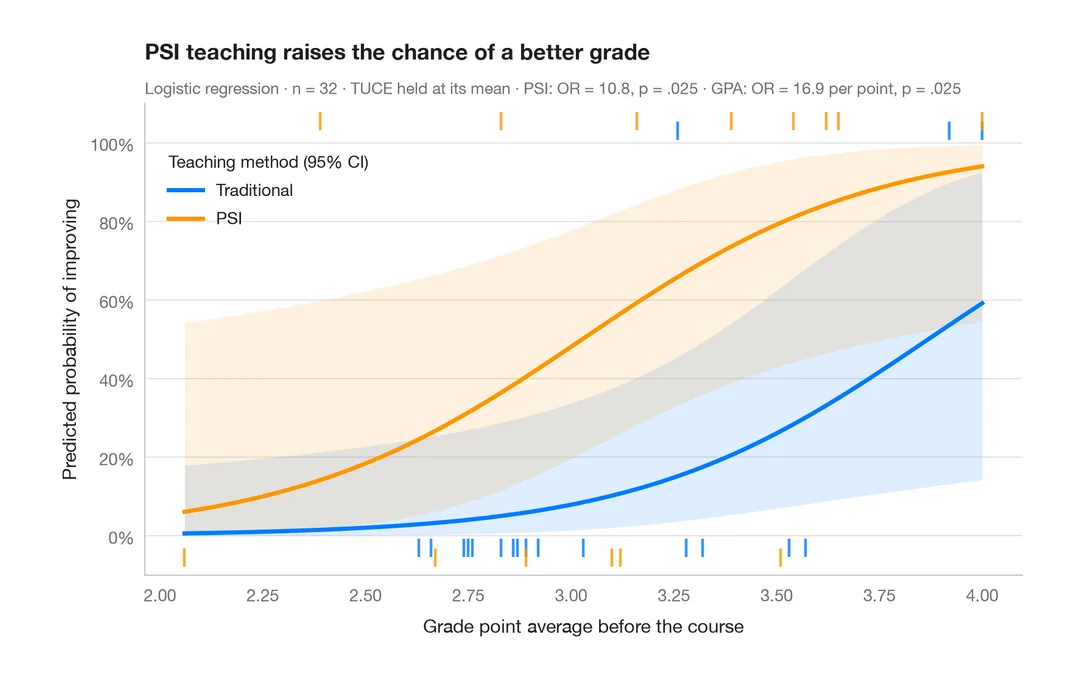
Probabilités prédites
Courbes de probabilité issues du modèle, avec rubans d'IC à 95 %, selon un prédicteur et par groupe.
ggeffects::ggpredict() / marginaleffects::plot_predictions()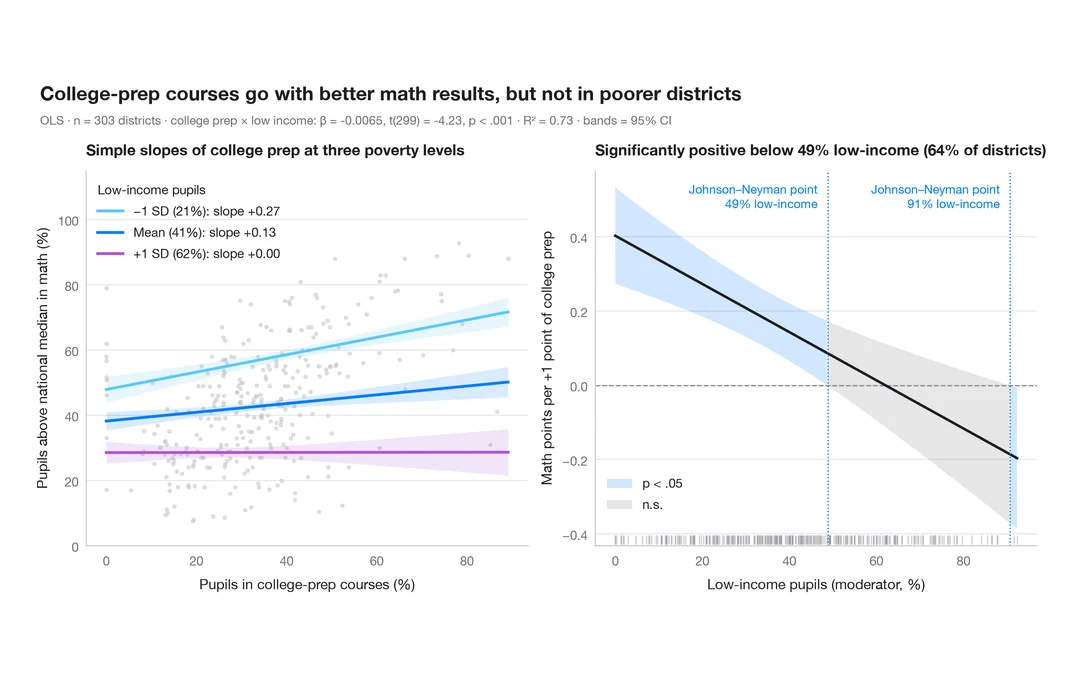
Effets d'interaction
Pentes simples à la moyenne ± 1 écart type et graphique de Johnson–Neyman pour les cours préparatoires et les résultats en mathématiques, modérés par la pauvreté des élèves.
interactions::interact_plot() / interactions::johnson_neyman()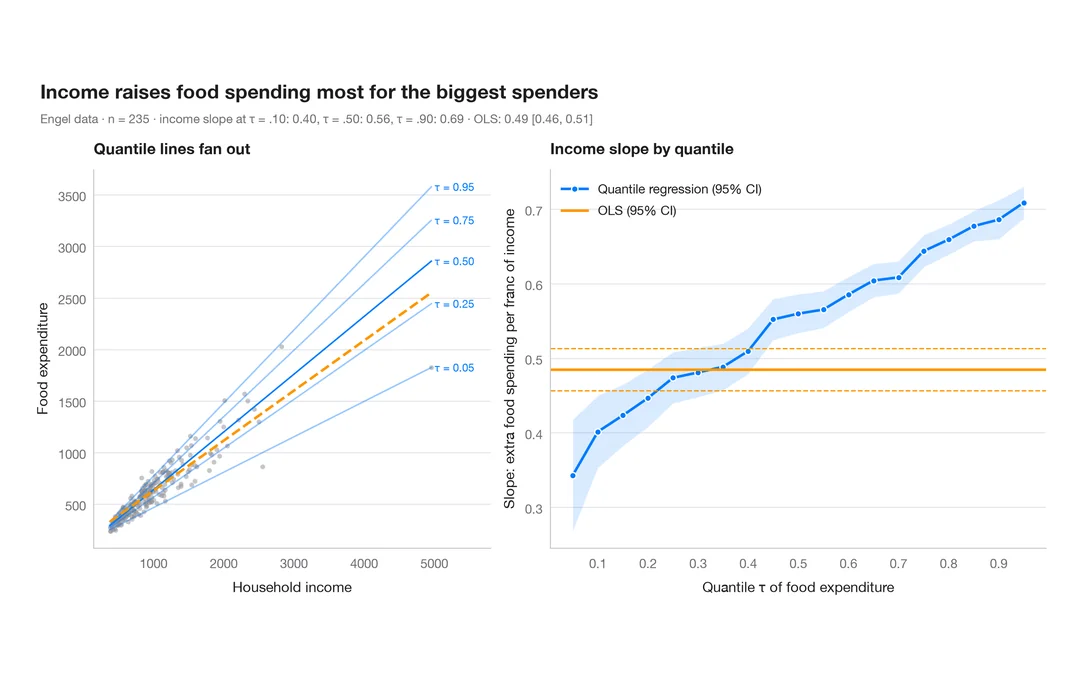
Processus de régression quantile
Comment une pente varie le long de la distribution conditionnelle, comparée à l'unique estimation des MCO.
quantreg::plot(summary(rq(tau = 1:19 / 20)))Diagnostics de modèles
Résidus, effet de levier, calibration et courbes ROC : vérifiez avant de faire confiance à un modèle.
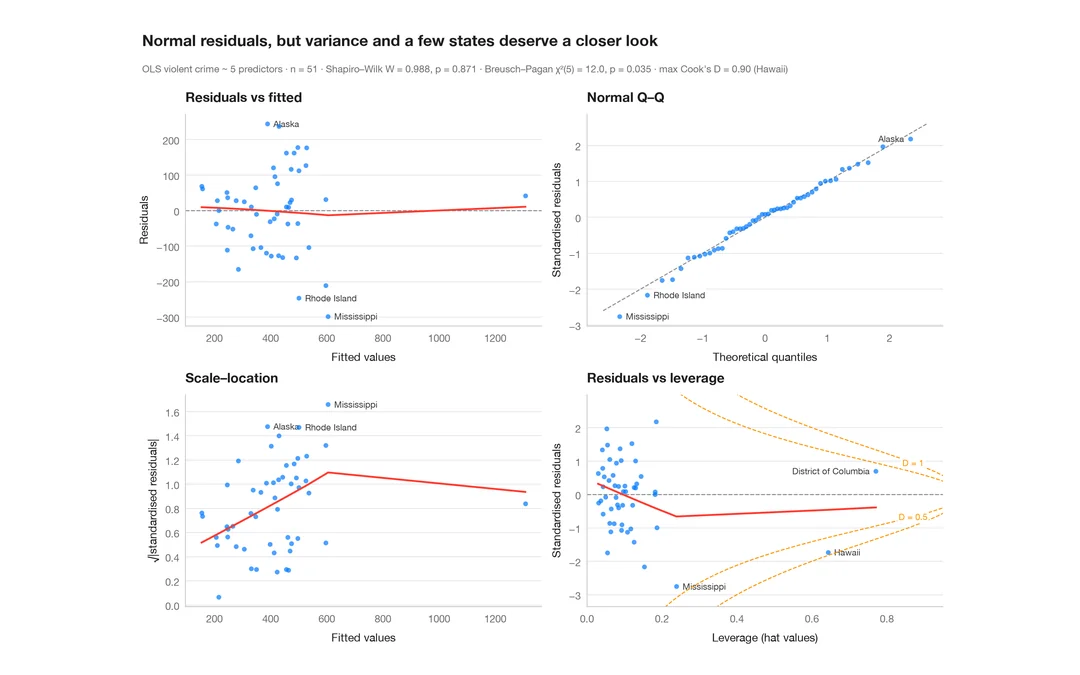
Diagnostics des résidus
Le panneau classique 2 × 2 d'un modèle linéaire — linéarité, normalité, variance, effet de levier.
plot(lm) / performance::check_model()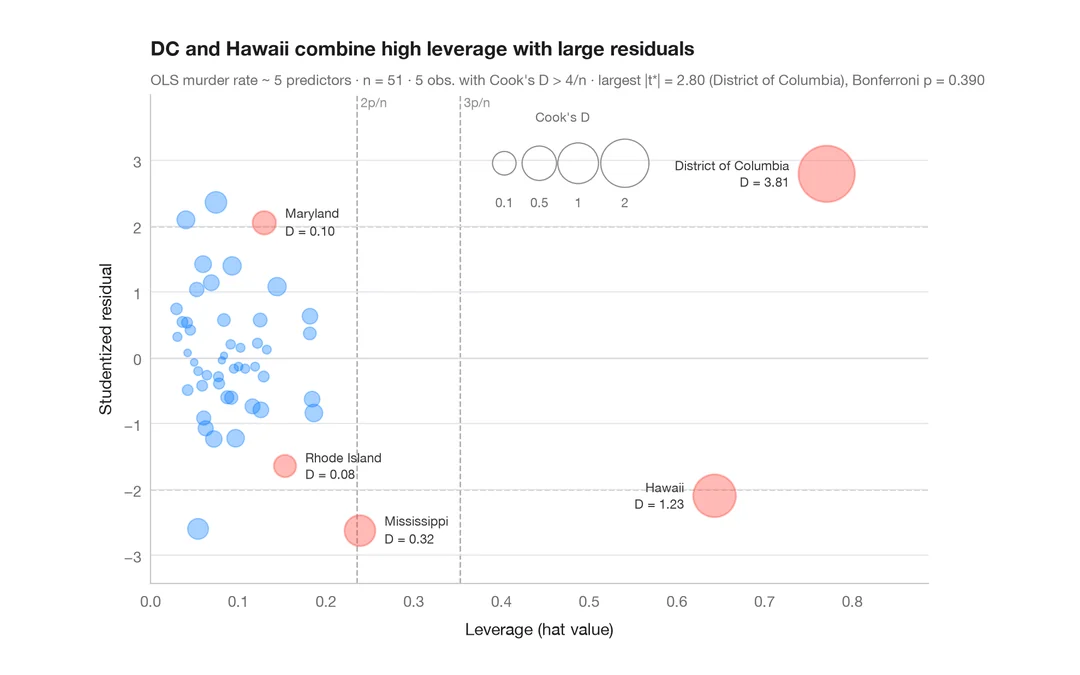
Graphique d'influence
Résidus studentisés en fonction de l'effet de levier, avec des bulles proportionnelles à la distance de Cook.
car::influencePlot()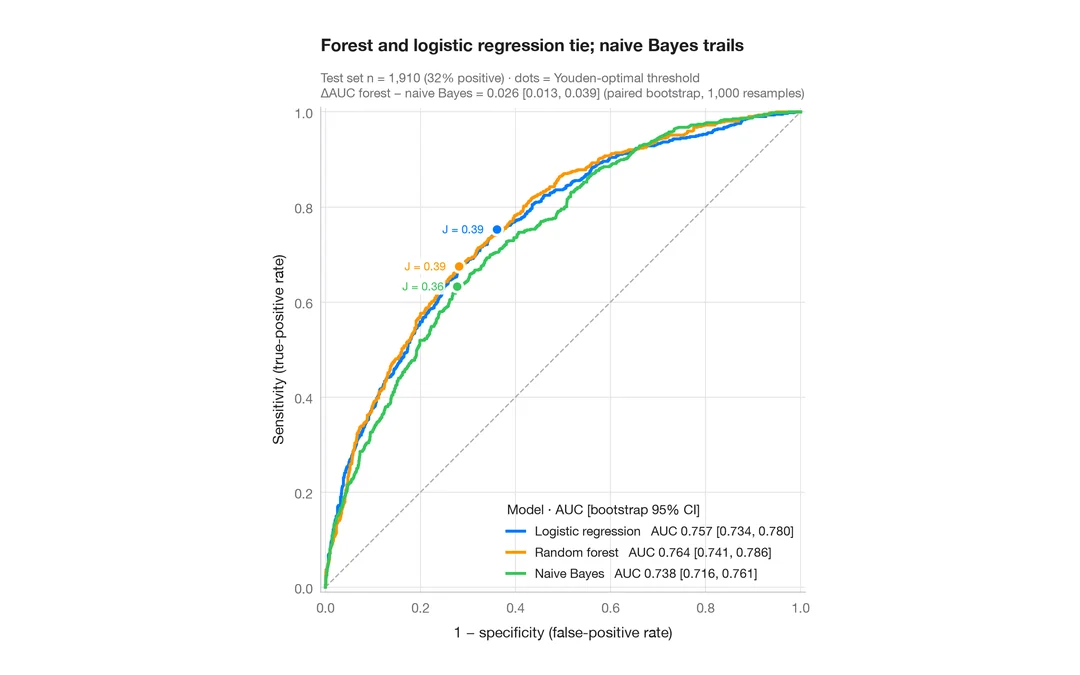
Courbes ROC
Trois classificateurs comparés par courbe ROC, AUC avec IC à 95 % par bootstrap et point de Youden.
pROC::ggroc() / pROC::ci.auc()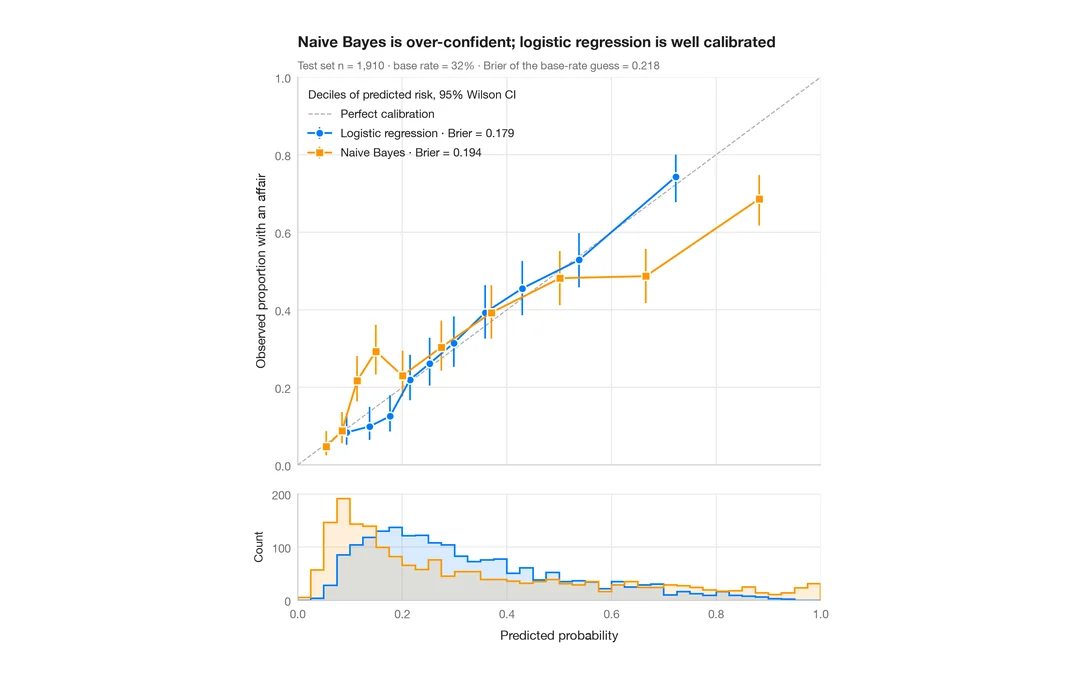
Graphique de calibration
Risque prédit et risque observé par décile, avec IC de Wilson, histogrammes des prédictions et score de Brier.
rms::calibrate() / probably::cal_plot_breaks()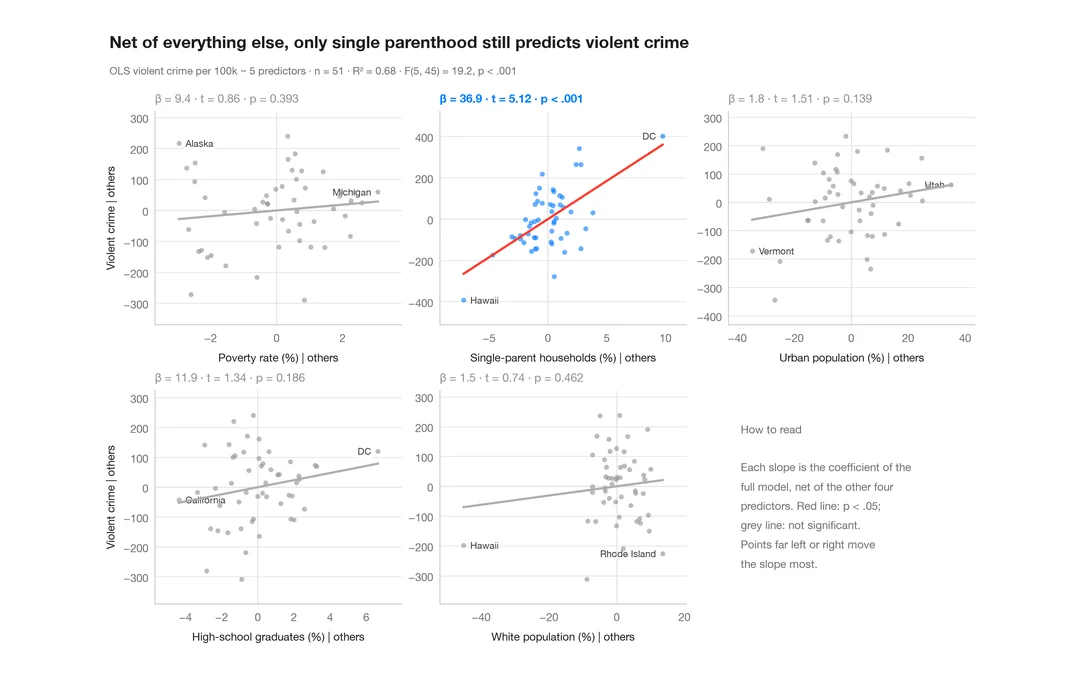
Graphiques de variables ajoutées
Un panneau de régression partielle par prédicteur ; chaque pente ajustée est égale à son coefficient.
car::avPlots()Analyse de survie
Courbes de Kaplan–Meier avec tableaux des effectifs à risque, risques cumulés et rapports de risques du modèle de Cox.
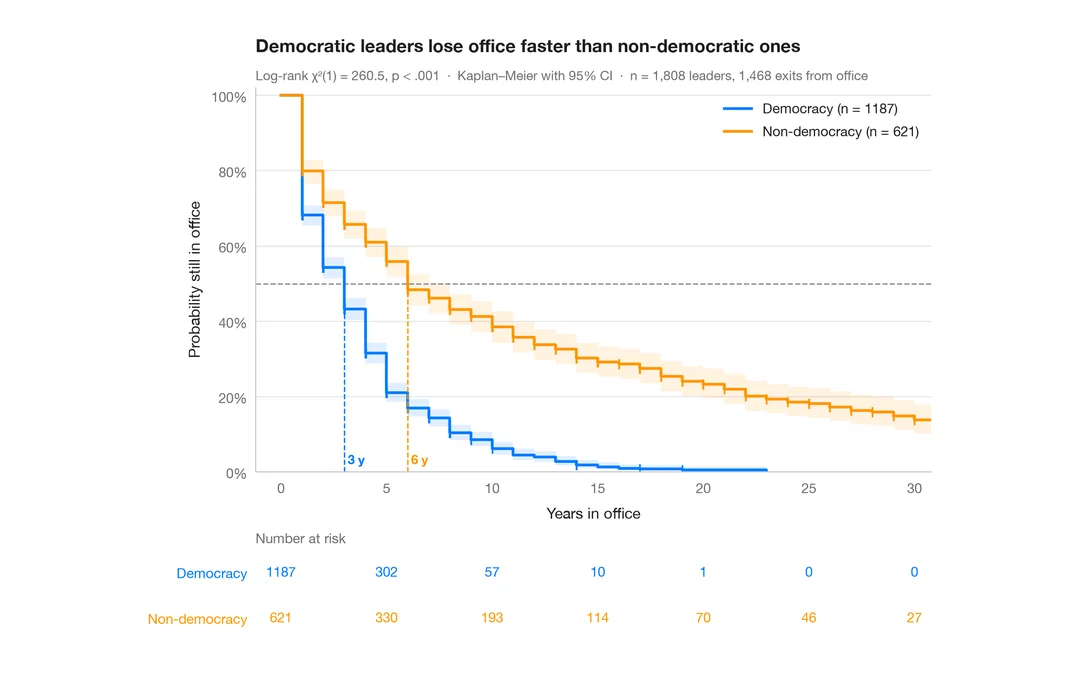
Courbes de Kaplan–Meier
Combien de temps les dirigeants politiques restent au pouvoir, démocraties et non-démocraties — courbes de survie avec bandes de confiance, marques de censure, test du log-rank et tableau des effectifs à risque.
survminer::ggsurvplot(risk.table = TRUE)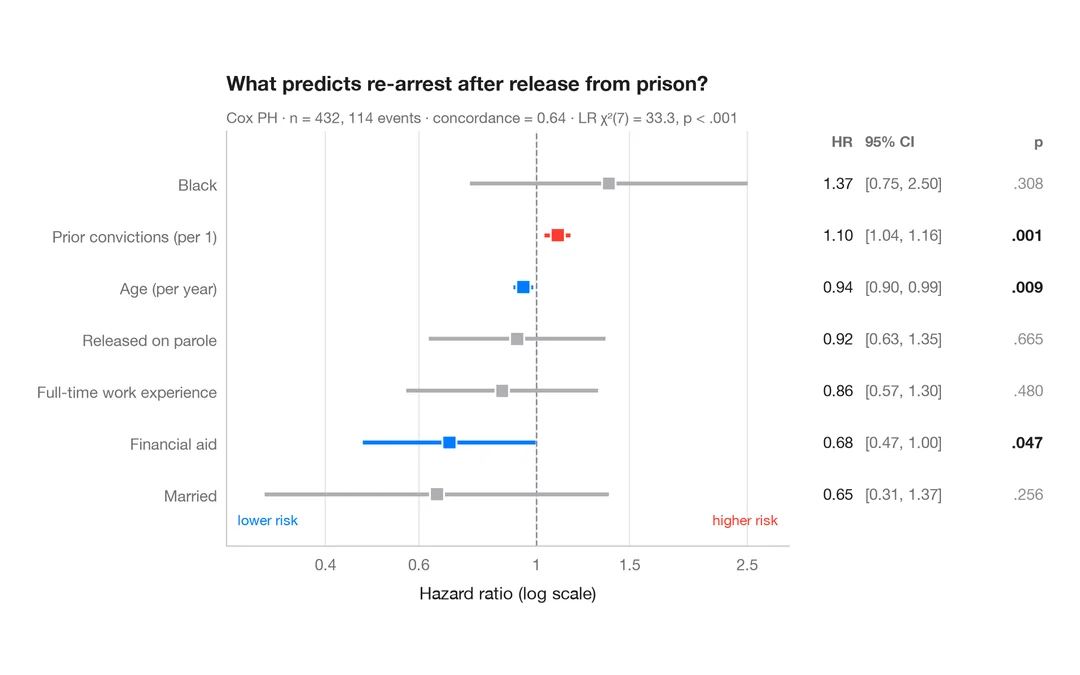
Rapports de risques de Cox
Graphique en forêt d'un modèle à risques proportionnels de Cox avec rapports de risques (HR), IC à 95 % et valeurs p.
survminer::ggforest()
Risque cumulé
Risque cumulé de Nelson–Aalen de quitter le pouvoir, avec bandes à 95 %, pour quatre régimes politiques.
survminer::ggsurvplot(fun = "cumhaz")
Courbes de survie ajustées
Survie prédite par un modèle de Cox pour plusieurs âges, les autres covariables étant fixées à leur moyenne.
survminer::ggadjustedcurves()Séries chronologiques
Décomposition, autocorrélation, prévisions avec intervalles de prédiction et évolution dans le temps.
Décomposition STL
Une série mensuelle de chiffre d'affaires industriel décomposée en tendance, saisonnalité et résidu dans des panneaux superposés.
feasts::STL() + autoplot()
ACF et PACF
Autocorrélation et autocorrélation partielle du chômage trimestriel aux États-Unis, en sucettes avec bandes de significativité à 95 %.
forecast::ggtsdisplay()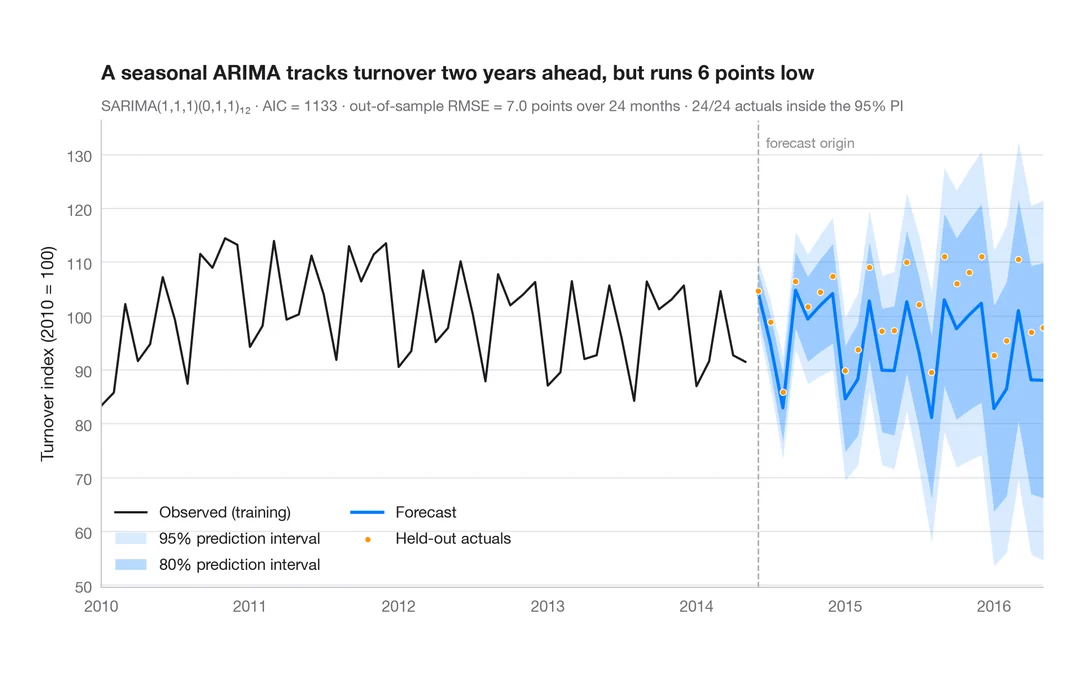
Prévision SARIMA
Prévision ARIMA saisonnière du chiffre d'affaires industriel avec intervalles de prédiction à 80 % et 95 %, confrontée aux données mises de côté.
forecast::autoplot(forecast())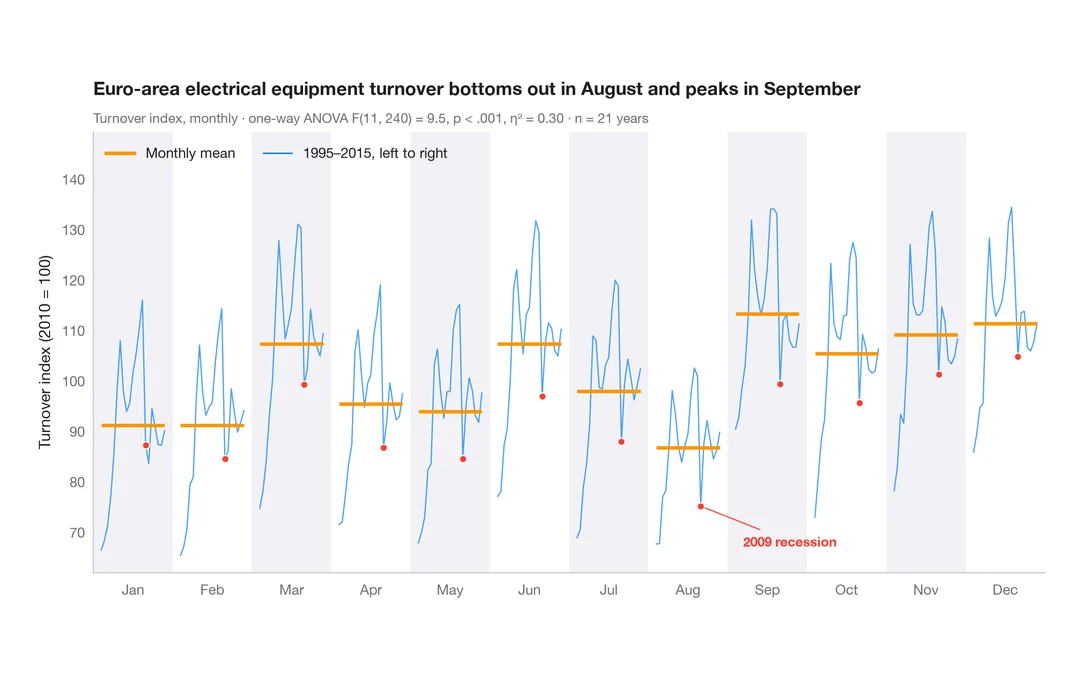
Graphique des sous-séries saisonnières
Le chiffre d'affaires industriel de chaque mois de l'année au fil des ans, avec la moyenne mensuelle comme référence.
feasts::gg_subseries()Multivarié et classification
Biplots d'ACP, diagrammes des valeurs propres, classification et cartes de chaleur pour données de grande dimension.
Biplot d'ACP
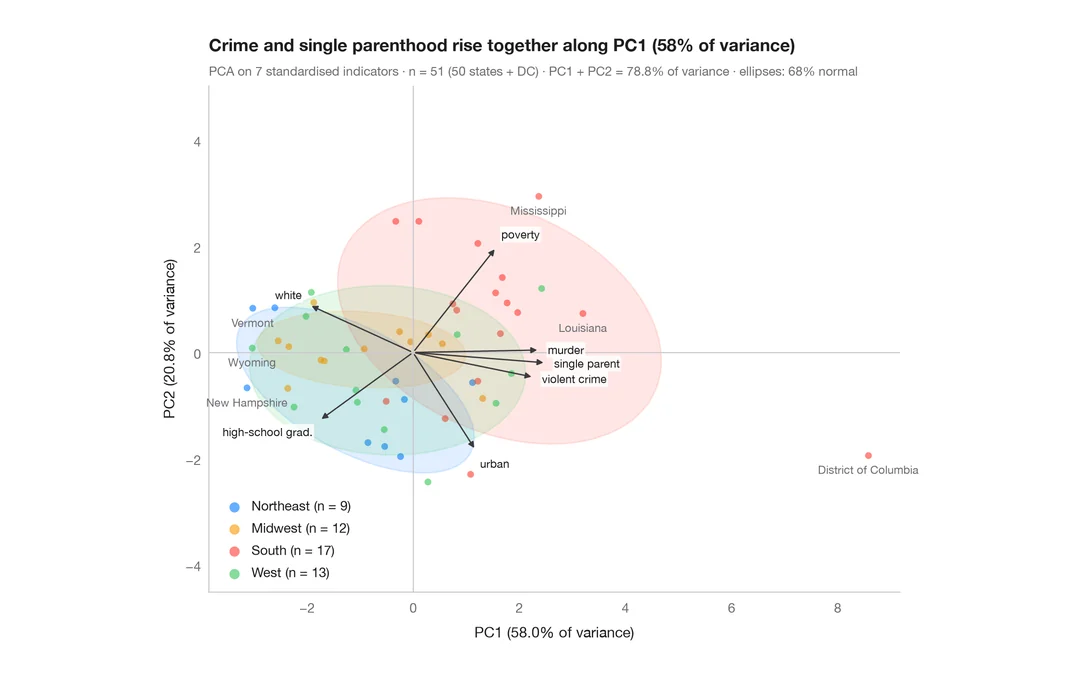
Les États américains et leurs indicateurs sociaux sur les deux premières composantes principales.
factoextra::fviz_pca_biplot()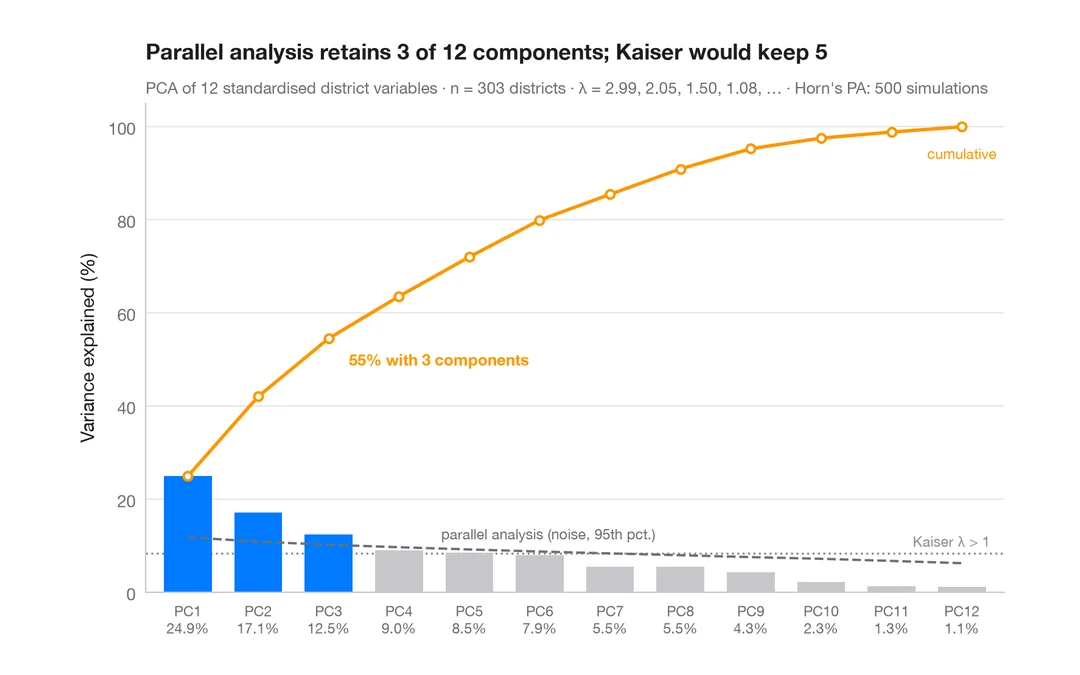
Diagramme des valeurs propres
Combien de dimensions décrivent 303 districts scolaires californiens ? Variance par composante et seuil de l'analyse parallèle.
factoextra::fviz_eig()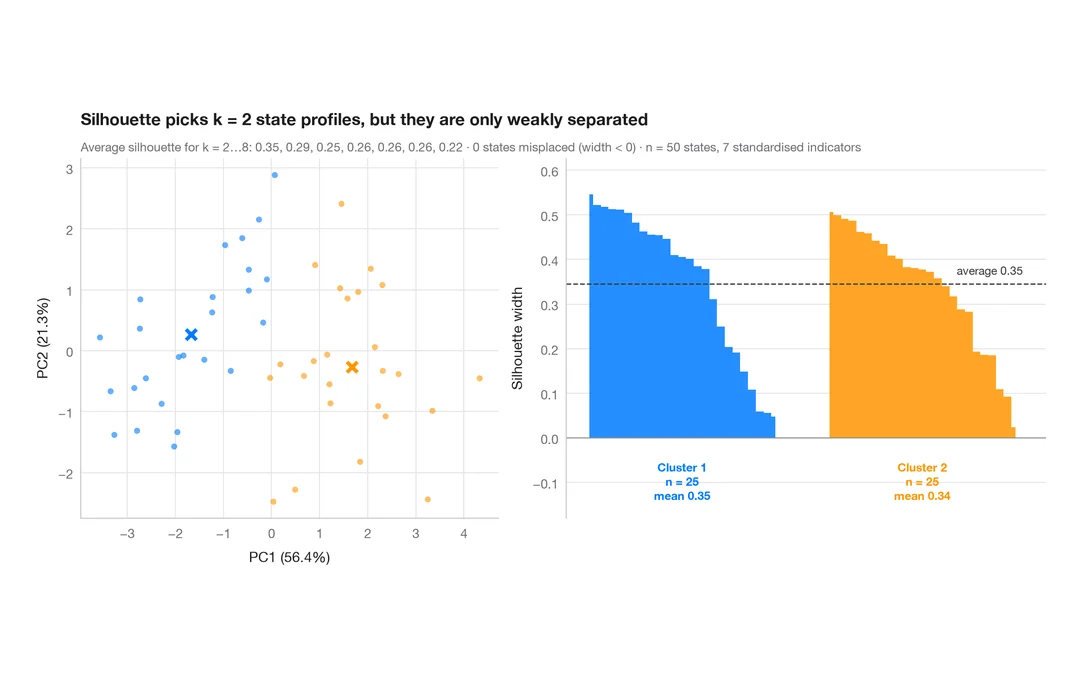
Graphique de silhouette pour les k-moyennes
Les États américains forment-ils des profils sociaux distincts ? Groupes des k-moyennes et largeurs de silhouette.
factoextra::fviz_silhouette()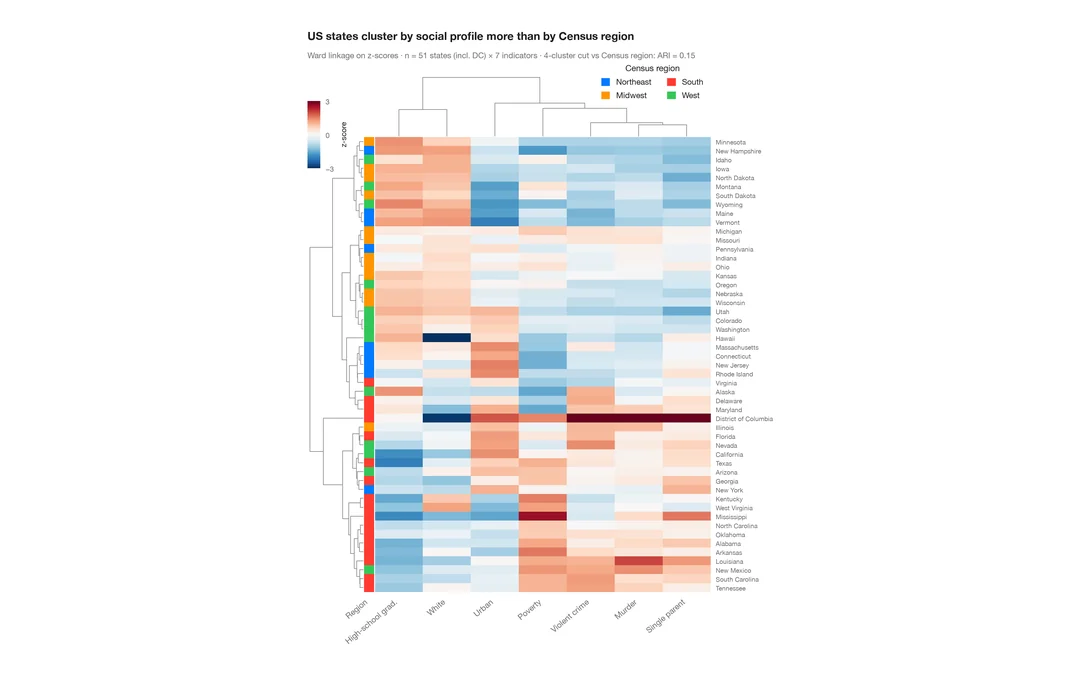
Carte de chaleur avec classification
Carte de chaleur des indicateurs sociaux des États américains en scores z, avec dendrogrammes des lignes et des colonnes et barre de couleur par région du recensement.
pheatmap::pheatmap() / ComplexHeatmap::Heatmap()Inférence et incertitude
Bootstrap, intervalles de confiance, puissance, concordance et graphiques en forêt de méta-analyse.
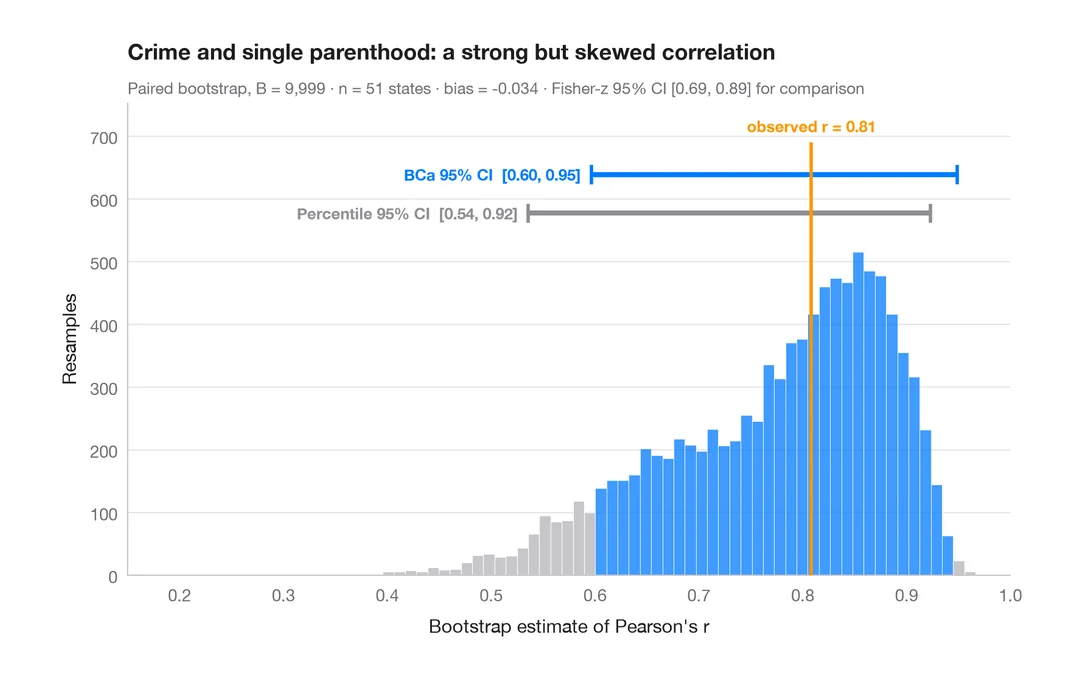
Distribution bootstrap
Corrélation rééchantillonnée avec intervalles de confiance à 95 % par percentiles et BCa.
boot::boot() + boot::boot.ci()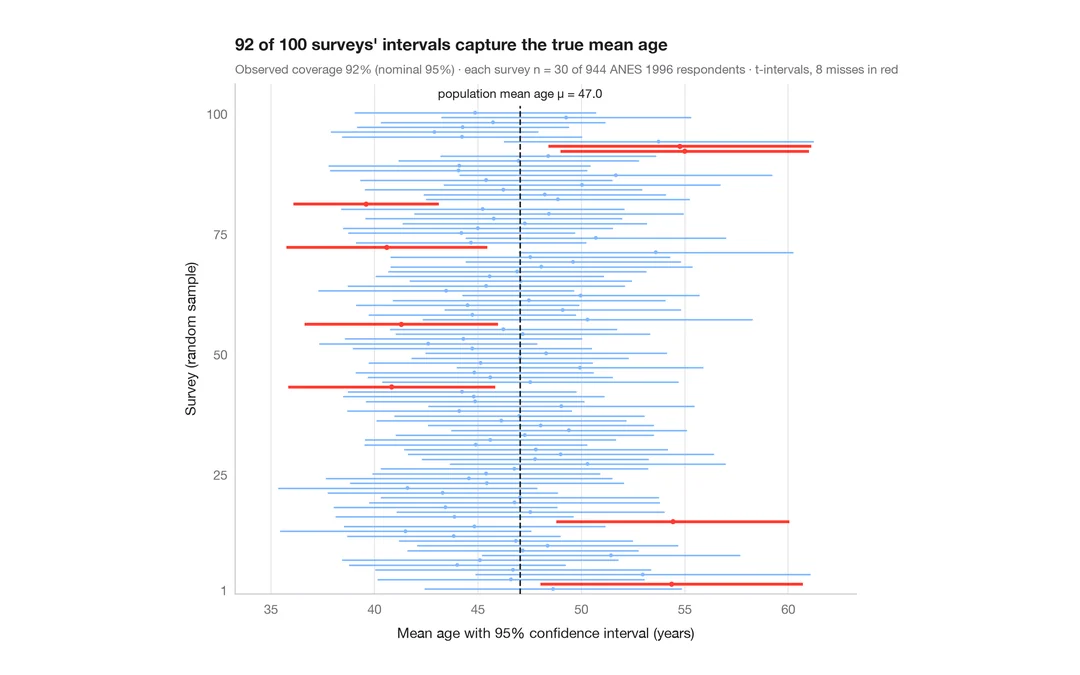
Ce que signifie un intervalle de confiance à 95 %
100 enquêtes de 30 personnes tirées parmi 944 répondants de l'ANES ; les IC à 95 % de l'âge moyen qui manquent la vraie valeur sont en rouge.
teaching classic (e.g. TeachingDemos::ci.examp())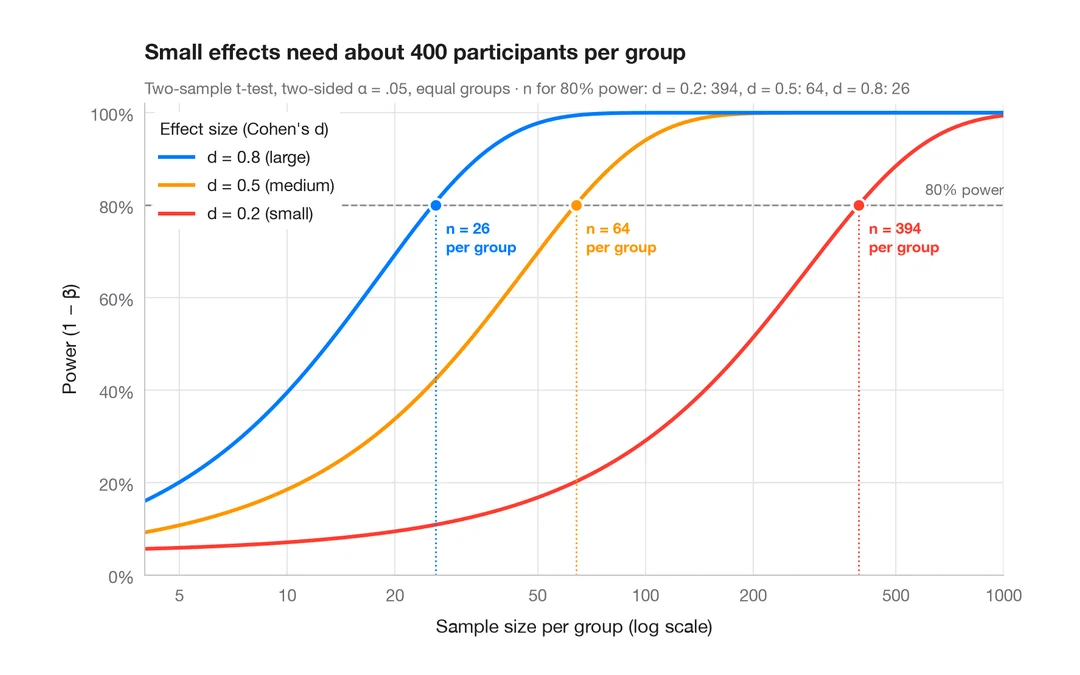
Courbe de puissance
Puissance d'un test t à deux échantillons selon la taille d'échantillon, pour des effets petits, moyens et grands.
pwr::pwr.t.test() + plot()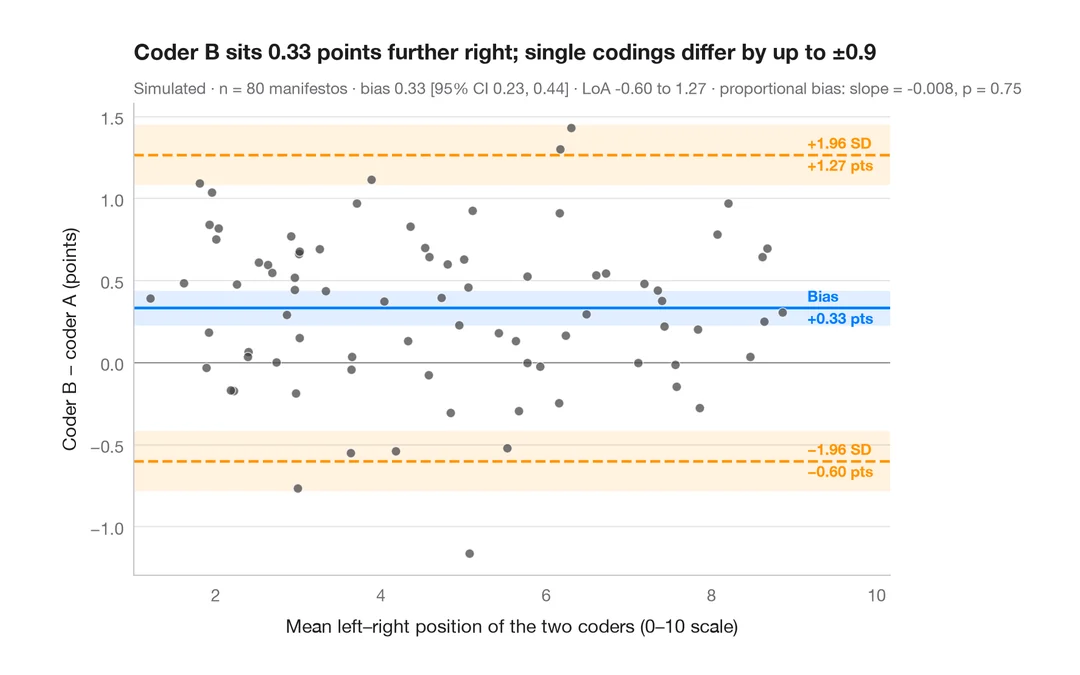
Graphique de Bland–Altman
Deux codeurs placent-ils les programmes électoraux de la même façon sur l'axe gauche–droite ? Biais et limites d'agrément à 95 %.
BlandAltmanLeh::bland.altman.plot() / blandr::blandr.draw()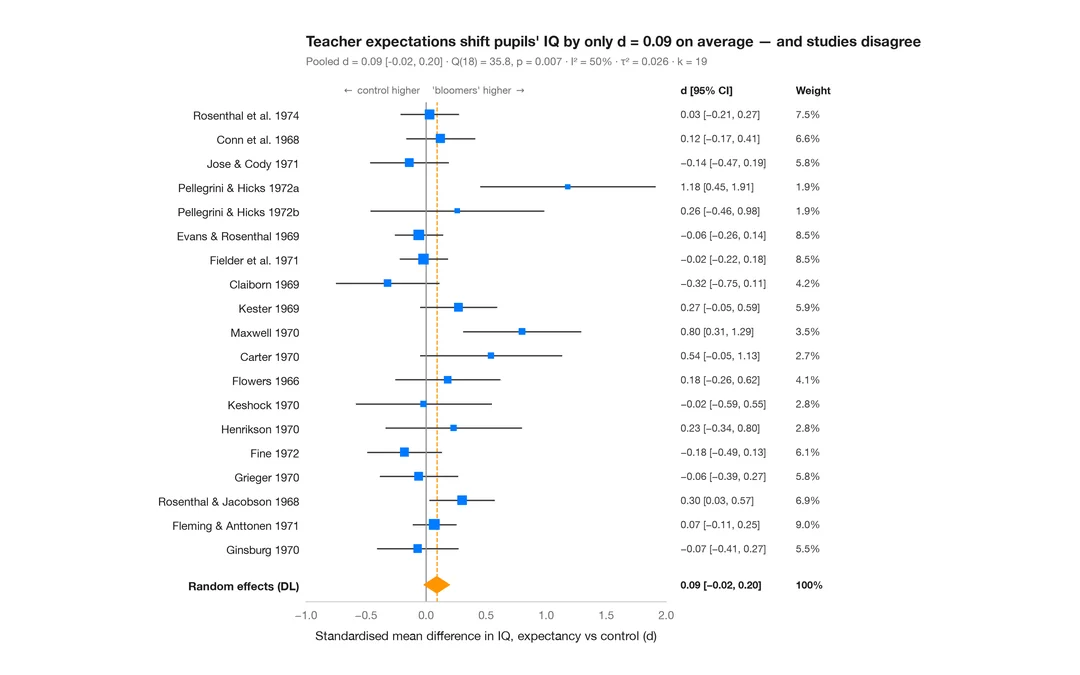
Graphique en forêt de méta-analyse
Les attentes des enseignants élèvent-elles le QI des élèves ? 19 expériences « Pygmalion », losange de l'estimation combinée à effets aléatoires et statistiques d'hétérogénéité.
meta::forest() / metafor::forest()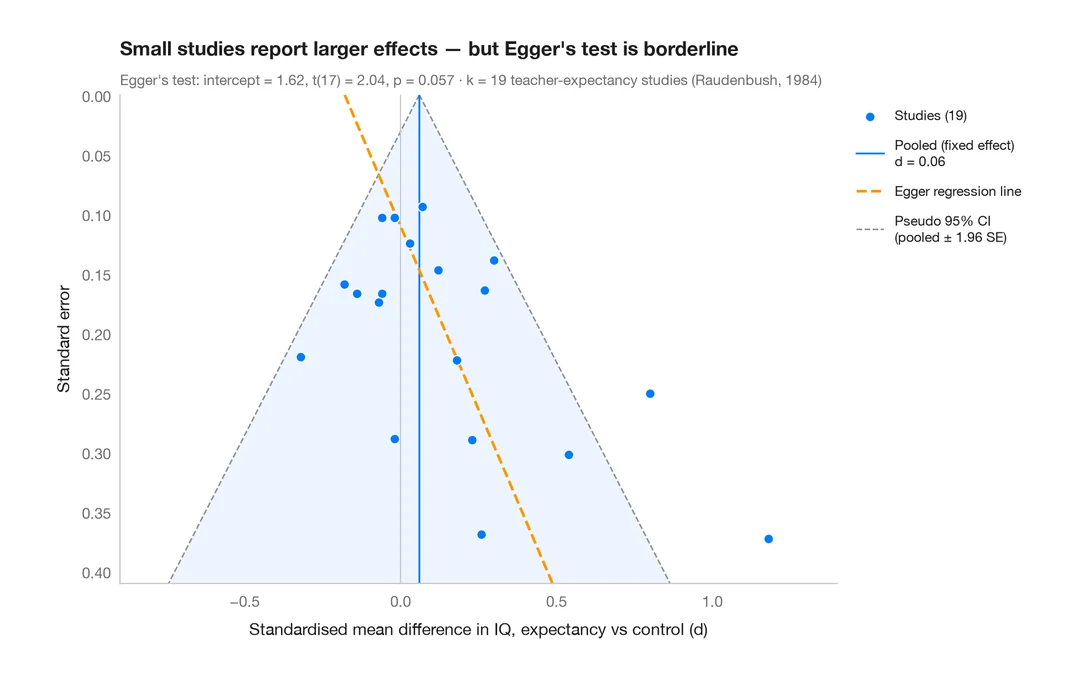
Graphique en entonnoir
Les petites études « Pygmalion » sont-elles plus optimistes ? 19 effets des attentes des enseignants en fonction de leur erreur type, avec entonnoir pseudo-95 % et test d'Egger.
metafor::funnel() + metafor::regtest()Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}