Graphique d'estimation
Données brutes de deux groupes, avec la différence de moyennes et son IC à 95 % par bootstrap.
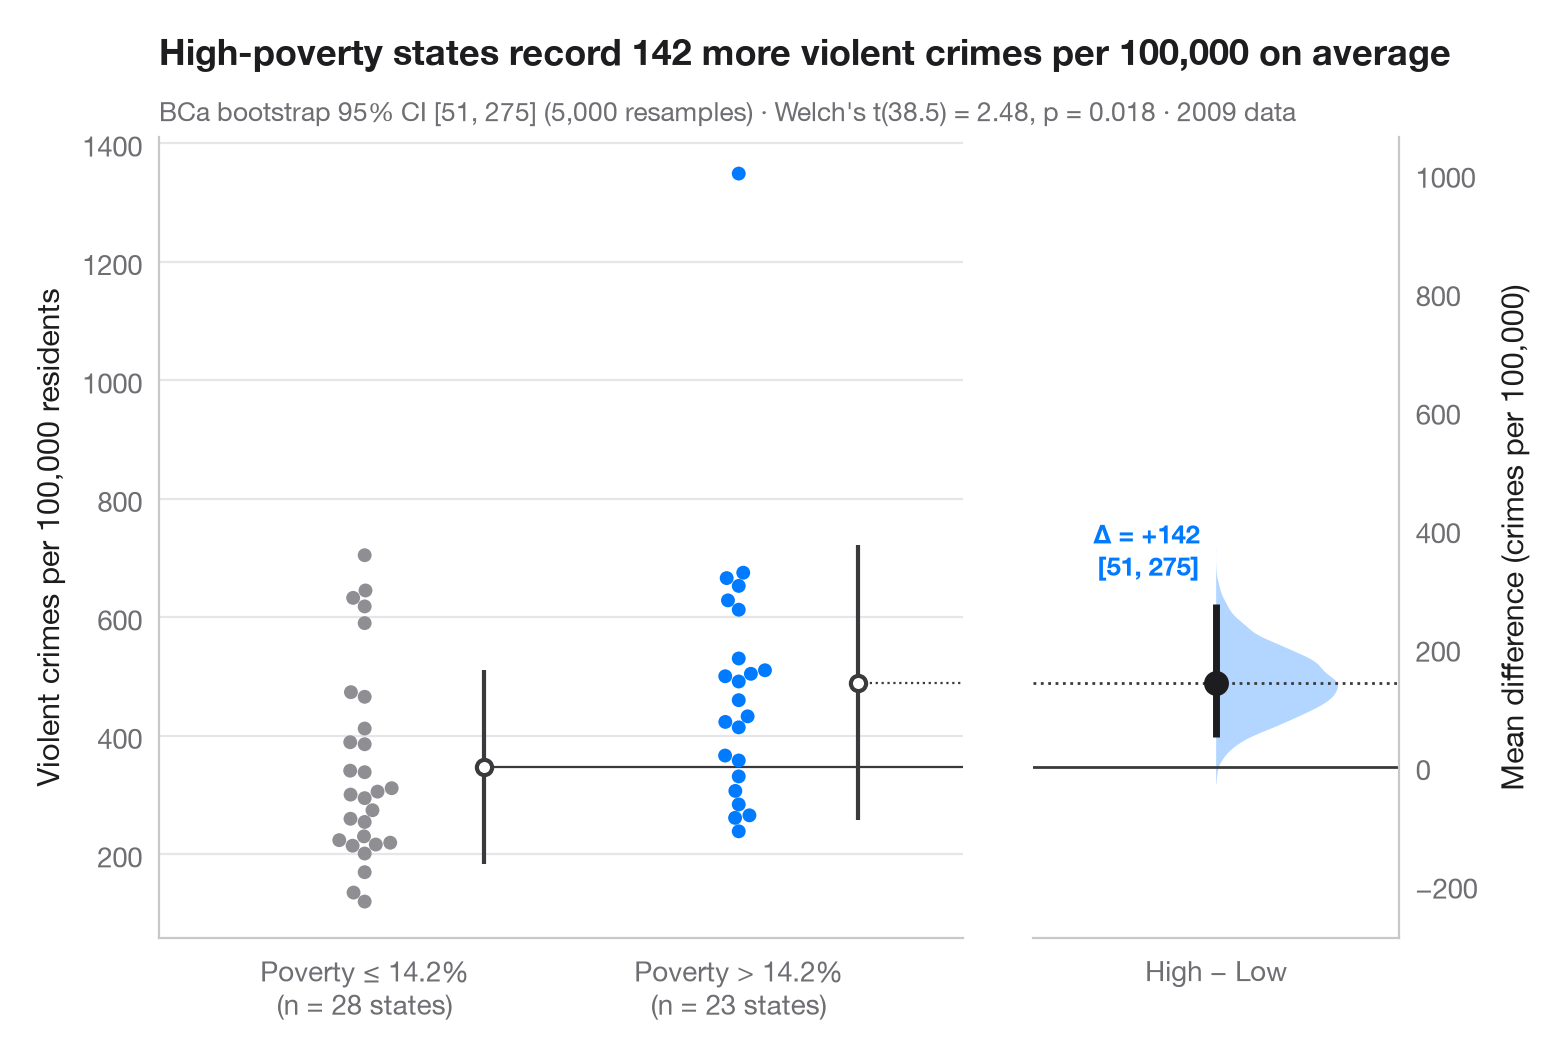
Le graphique d'estimation de Gardner–Altman place la taille d'effet, et non la valeur p, au centre. L'axe de gauche montre chaque observation des deux groupes ; l'axe flottant de droite est calé de sorte que son zéro coïncide avec la moyenne du groupe de référence. Sur cet axe, la distribution bootstrap de la différence de moyennes est tracée sous forme de demi-violon, avec l'estimation ponctuelle et son intervalle de confiance à 95 % représentés par un point et une barre.
Les données sont les 50 États américains plus le district de Columbia en 2009, fournis avec statsmodels (sm.datasets.statecrime) : le taux de crimes violents pour 100 000 habitants, pour les 23 États dont le taux de pauvreté dépasse celui de l'État médian (14,2 %) et pour les 28 qui l'égalent ou se situent en dessous. La comparaison est observationnelle, et non expérimentale : elle mesure l'ampleur de l'écart, pas sa cause. L'IC à 95 % est un bootstrap corrigé du biais et accéléré (BCa) issu de scipy.stats.bootstrap, et le sous-titre ajoute le test t de Welch (scipy.stats.ttest_ind) ; le trait vertical à côté de chaque essaim représente la moyenne du groupe ± 1 écart type, et l'essaim provient de seaborn.swarmplot. Le point isolé au-dessus de 1 300 est le district de Columbia.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns
import statsmodels.api as sm
from scipy import stats

# Data: violent crimes per 100,000 residents in 2009, by state poverty rate
df = sm.datasets.statecrime.load_pandas().data
cut = df.poverty.median()
df["group"] = np.where(df.poverty > cut, "High poverty", "Low poverty")
low = df.loc[df.group == "Low poverty", "violent"].to_numpy()
high = df.loc[df.group == "High poverty", "violent"].to_numpy()

# Mean difference with a BCa bootstrap 95% CI, and the bootstrap distribution
diff = lambda a, b, axis=-1: np.mean(b, axis=axis) - np.mean(a, axis=axis)
boot = stats.bootstrap((low, high), diff, n_resamples=5000, method="BCa",
                       random_state=np.random.default_rng(1))
lo, hi = boot.confidence_interval
delta = high.mean() - low.mean()
t = stats.ttest_ind(high, low, equal_var=False)

# Manual layout (the long subtitle would otherwise squeeze the panels apart)
fig, (ax, ax2) = plt.subplots(1, 2, figsize=(8, 5.2), width_ratios=[2.2, 1], layout="none")
fig.subplots_adjust(wspace=0.12)
palette = ["#8E8E93", "#007AFF"]
sns.swarmplot(data=df, x="group", y="violent", hue="group", palette=palette, size=5,
              order=["Low poverty", "High poverty"], hue_order=["Low poverty", "High poverty"],
              legend=False, ax=ax)
for i, d in enumerate([low, high]):            # mean ± SD as a gapped line beside the swarm
    m, s = d.mean(), d.std(ddof=1)
    ax.vlines(i + 0.32, m - s, m + s, color="#3A3A3C", lw=1.5)
    ax.scatter(i + 0.32, m, s=30, color="white", edgecolor="#3A3A3C", lw=1.5, zorder=3)
ax.set_xlabel("")
ax.set_ylabel("Violent crimes per 100,000 residents")
ax.set_xticks([0, 1], [f"Poverty ≤ {cut:.1f}%\n(n = {len(low)} states)",
                      f"Poverty > {cut:.1f}%\n(n = {len(high)} states)"])

# Floating difference axis: zero aligned with the low-poverty mean
ax.set_xlim(-0.55, 1.6)
ymin, ymax = ax.get_ylim()
ax2.set_ylim(ymin - low.mean(), ymax - low.mean())
ax2.axhline(0, color="#3A3A3C", lw=1)
ax2.axhline(delta, color="#3A3A3C", lw=1, ls=":")
ax.plot([0.32, 1.6], [low.mean()] * 2, color="#3A3A3C", lw=0.8)
ax.plot([1.32, 1.6], [high.mean()] * 2, color="#3A3A3C", lw=0.8, ls=":")
v = ax2.violinplot(boot.bootstrap_distribution, positions=[0], widths=0.8,
                   showextrema=False, side="high")
v["bodies"][0].set(facecolor="#007AFF", alpha=0.3, edgecolor="none")
ax2.vlines(0, lo, hi, color="#1D1D1F", lw=2.5)
ax2.scatter(0, delta, s=70, color="#1D1D1F", zorder=3)
ax2.annotate(f"Δ = {delta:+.0f}\n[{lo:.0f}, {hi:.0f}]", (0, hi), xytext=(-6, 8),
             textcoords="offset points", ha="right", va="bottom", fontsize=9.5,
             fontweight="semibold", color="#007AFF")
ax2.set_xlim(-0.6, 0.6)
ax2.set_xticks([0], ["High − Low"])
ax2.yaxis.tick_right(); ax2.yaxis.set_label_position("right")
ax2.spines[["left"]].set_visible(False); ax2.spines["right"].set_visible(True)
ax2.set_ylabel("Mean difference (crimes per 100,000)")
ax2.grid(False)

ax.set_title(f"High-poverty states record {delta:.0f} more violent crimes per 100,000 on average",
             pad=26)
ax.text(0, 1.02, f"BCa bootstrap 95% CI [{lo:.0f}, {hi:.0f}] (5,000 resamples) · "
        f"Welch's t({t.df:.1f}) = {t.statistic:.2f}, p = {t.pvalue:.3f} · 2009 data",
        transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- US state crime and social indicators, 2009. U.S. Census Bureau. Statistical Abstract of the United States, state tables for 2009 (crime rates from the FBI Uniform Crime Reporting program). https://www.statsmodels.org/stable/datasets/generated/statecrime.html
Compiled for statsmodels (sm.datasets.statecrime); public domain. See the statsmodels page for each variable's table and footnotes.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Estimation plot. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/group-comparisons/estimation-plot/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Comparaisons de groupes
Comparaison entre groupes
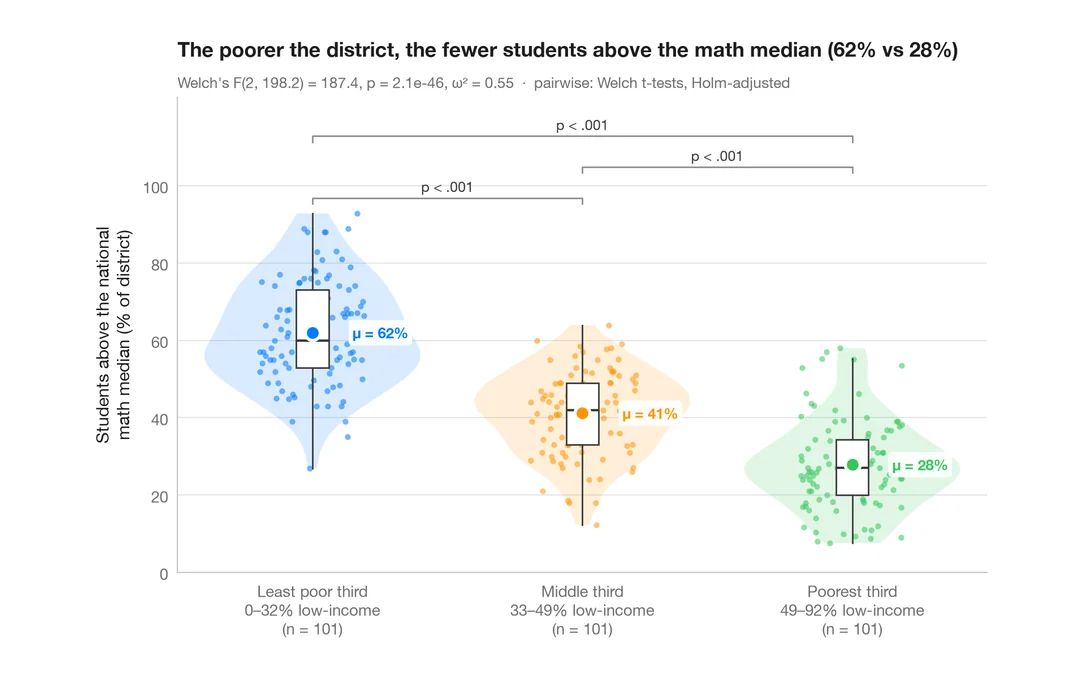
Violon, boîte et points avec ANOVA de Welch, taille d'effet et tests deux à deux.
ggstatsplot::ggbetweenstats()
Comparaison intra-sujets
Mesures répétées avec une ligne par sujet, moyennes, ANOVA à mesures répétées et tests appariés.
ggstatsplot::ggwithinstats()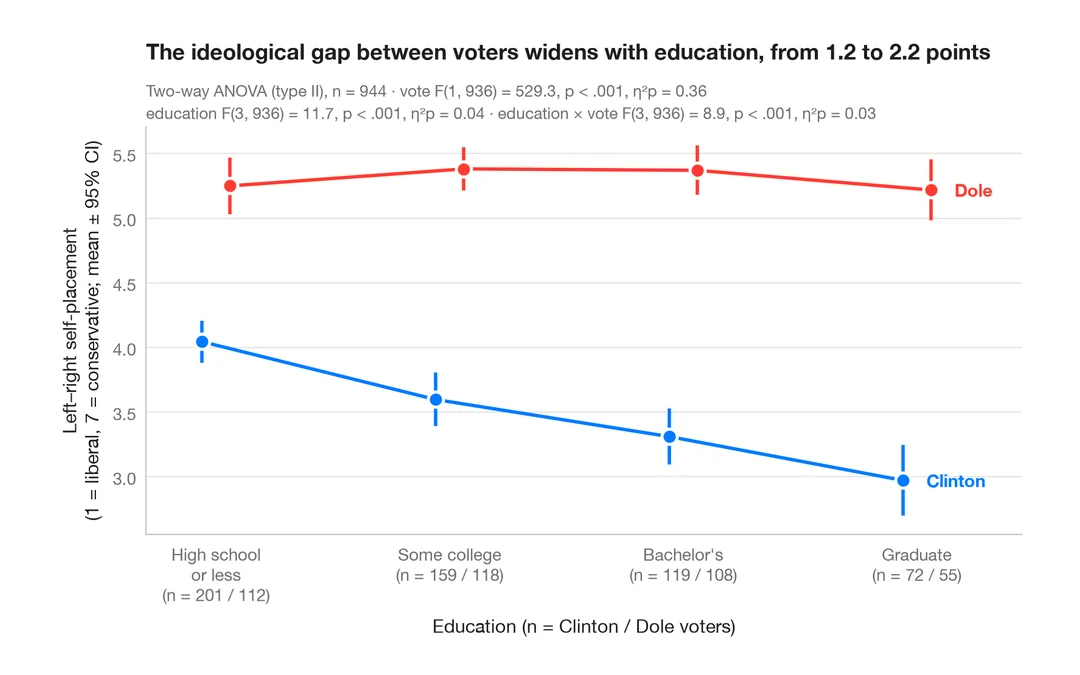
Graphique d'interaction
Moyennes de groupes avec intervalles de confiance à 95 % pour deux facteurs, avec ANOVA à deux facteurs.
ggpubr::ggline(add = "mean_ci") / ggstats