Comparaison de fonctions de répartition empiriques
Fonctions de répartition empiriques de deux groupes, avec l'écart de Kolmogorov–Smirnov.
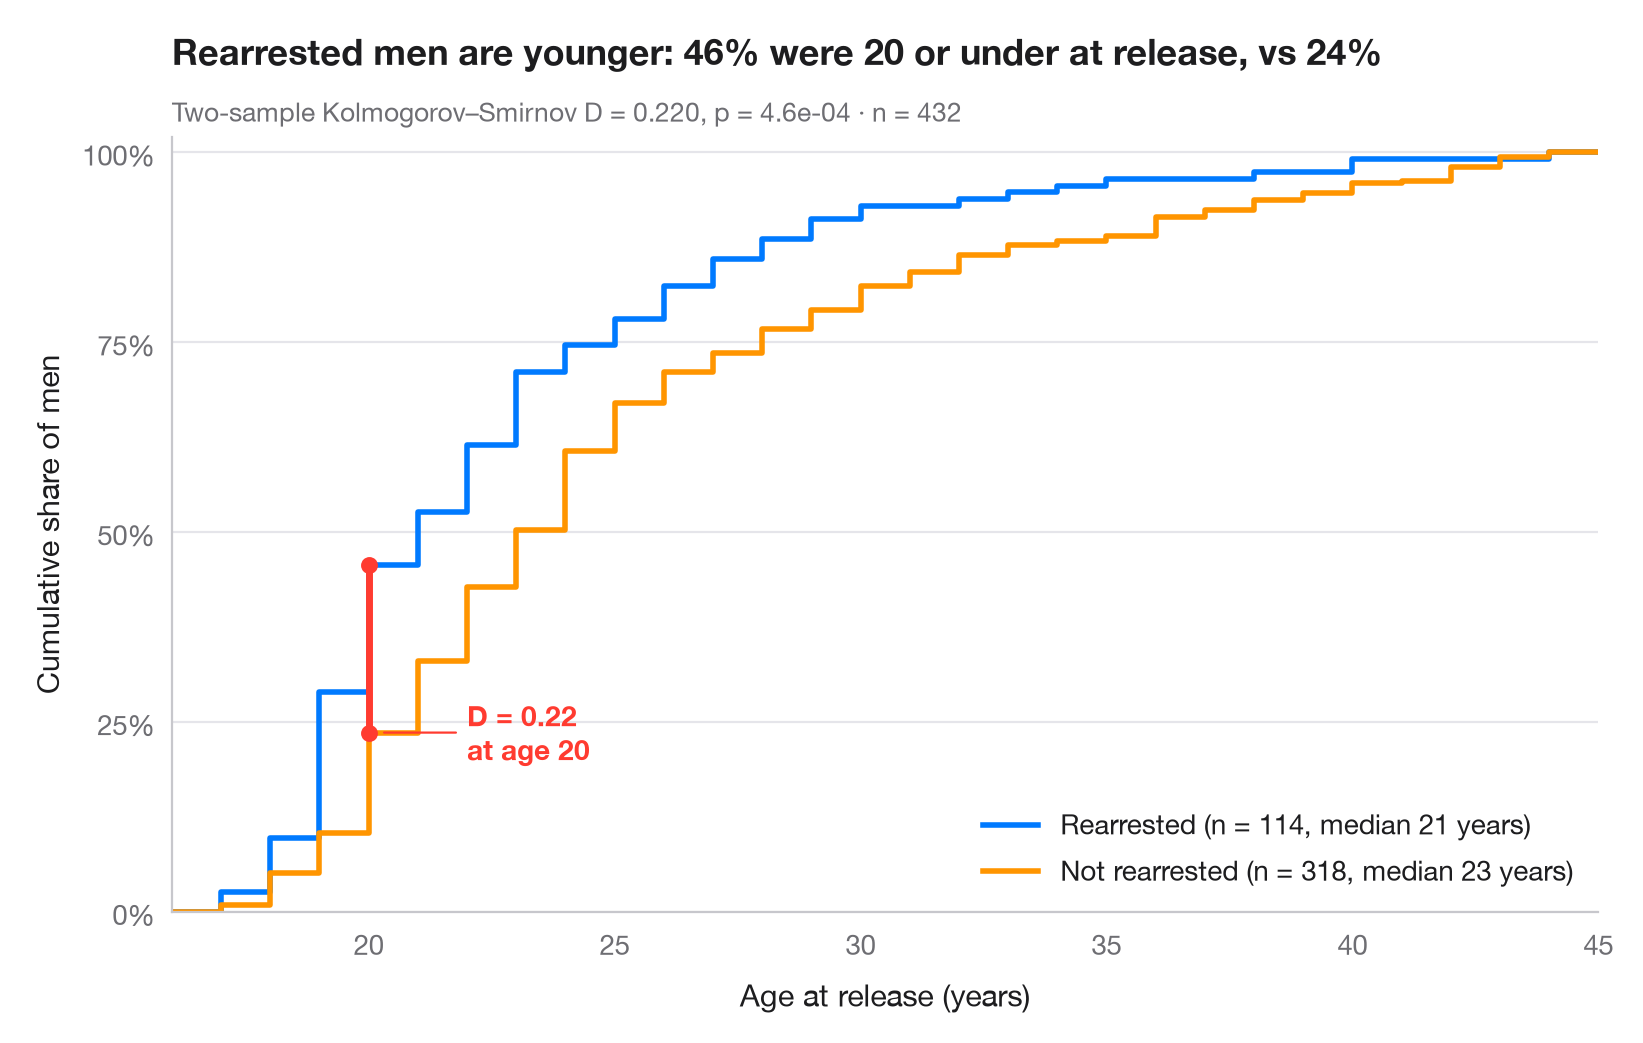
Une fonction de répartition empirique (ECDF) indique, pour chaque valeur de l'axe des x, la proportion d'observations inférieures ou égales à cette valeur. Contrairement à un histogramme, elle ne nécessite aucune classe, et chaque quantile peut être lu directement. Lorsque deux ECDF sont tracées ensemble, le plus grand écart vertical entre elles correspond exactement à la statistique D de Kolmogorov–Smirnov à deux échantillons, représentée ici par un segment rouge.
Les données sont les 432 hommes libérés des prisons d'État du Maryland dans les années 1970 et suivis pendant un an (l'expérience de Rossi, Berk et Lenihan), fournies avec lifelines (lifelines.datasets.load_rossi()) : l'âge à la libération, pour les hommes de nouveau arrêtés dans l'année et pour ceux qui ne l'ont pas été. scipy.stats.ecdf construit les courbes et scipy.stats.ks_2samp renvoie D, sa position et la valeur p.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
from lifelines.datasets import load_rossi
from scipy import stats

# Data: age at release of former prisoners, split by rearrest within one year
df = load_rossi()
groups = {"Rearrested": df.loc[df.arrest == 1, "age"].to_numpy(),
          "Not rearrested": df.loc[df.arrest == 0, "age"].to_numpy()}
palette = ["#007AFF", "#FF9500"]

# Two-sample Kolmogorov–Smirnov test: D is the largest vertical gap
ks = stats.ks_2samp(*groups.values())
x_gap = ks.statistic_location
F = [stats.ecdf(d).cdf for d in groups.values()]
y_gap = [f.evaluate(x_gap) for f in F]

lo, hi = df.age.min() - 1, df.age.max() + 1  # common x-range for both curves
fig, ax = plt.subplots(figsize=(8, 5))
for (name, d), f, c in zip(groups.items(), F, palette):
    ax.step(np.r_[lo, f.quantiles, hi], np.r_[0, f.probabilities, 1], where="post",
            color=c, lw=2, label=f"{name} (n = {len(d)}, median {np.median(d):.0f} years)")

# Mark the KS distance
ax.plot([x_gap, x_gap], y_gap, color="#FF3B30", lw=2.5, solid_capstyle="round", zorder=5)
ax.scatter([x_gap, x_gap], y_gap, color="#FF3B30", s=30, zorder=6)
ax.annotate(f"D = {ks.statistic:.2f}\nat age {x_gap:.0f}", (x_gap + 0.2, min(y_gap)),
            xytext=(x_gap + 2, min(y_gap)), ha="left", va="center", fontsize=10,
            fontweight="semibold", color="#FF3B30",
            arrowprops=dict(arrowstyle="-", color="#FF3B30", lw=0.8, shrinkB=2))

ax.set_xlim(lo, hi)
ax.set_ylim(0, 1.02)
ax.set_yticks(np.linspace(0, 1, 5), [f"{v:.0%}" for v in np.linspace(0, 1, 5)])
ax.set_xlabel("Age at release (years)")
ax.set_ylabel("Cumulative share of men")
ax.legend(loc="lower right")
ax.set_title(f"Rearrested men are younger: {y_gap[0]:.0%} were {x_gap:.0f} or under "
             f"at release, vs {y_gap[1]:.0%}", pad=26)
ax.text(0, 1.02, f"Two-sample Kolmogorov–Smirnov D = {ks.statistic:.3f}, p = {ks.pvalue:.1e}"
        f" · n = {len(df)}", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Rossi recidivism experiment (432 released prisoners). Rossi, P. H., Berk, R. A., & Lenihan, K. J. (1980). Money, Work, and Crime: Some Experimental Results. Academic Press. https://lifelines.readthedocs.io/en/latest/lifelines.datasets.html
Men released from Maryland state prisons in the 1970s, half randomly assigned to financial aid. Distributed with lifelines (lifelines.datasets.load_rossi).
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). ECDF comparison. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/distributions/ecdf-comparison/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Distributions
Histogramme avec densité
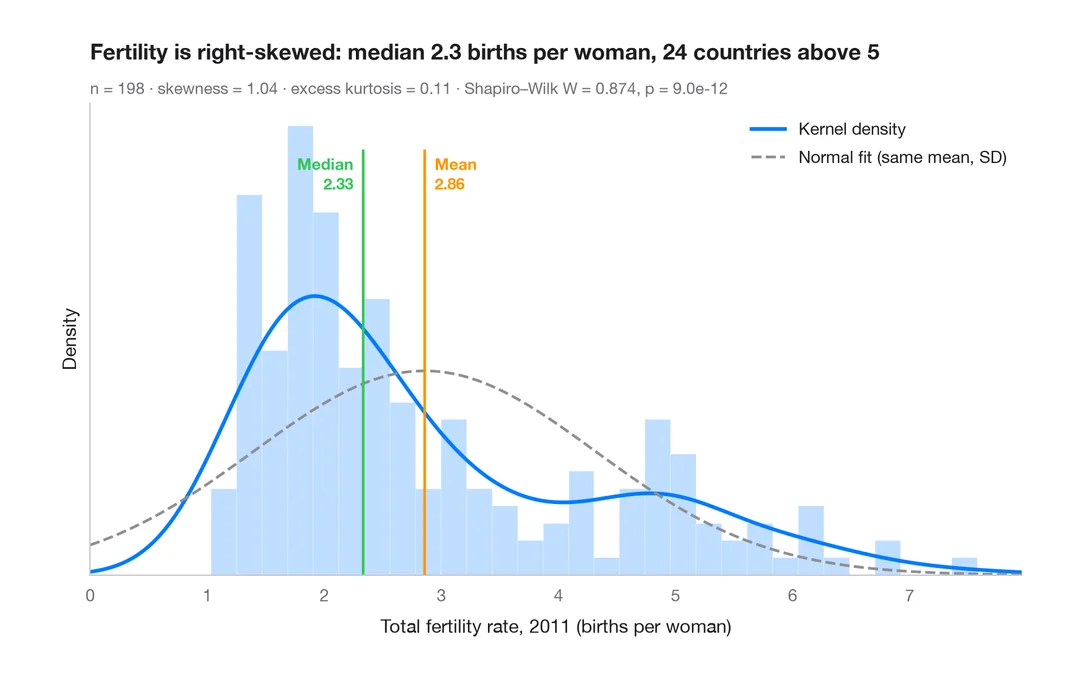
Histogramme, densité par noyau et courbe normale ajustée, avec statistiques de forme.
ggplot2::geom_histogram() + geom_density()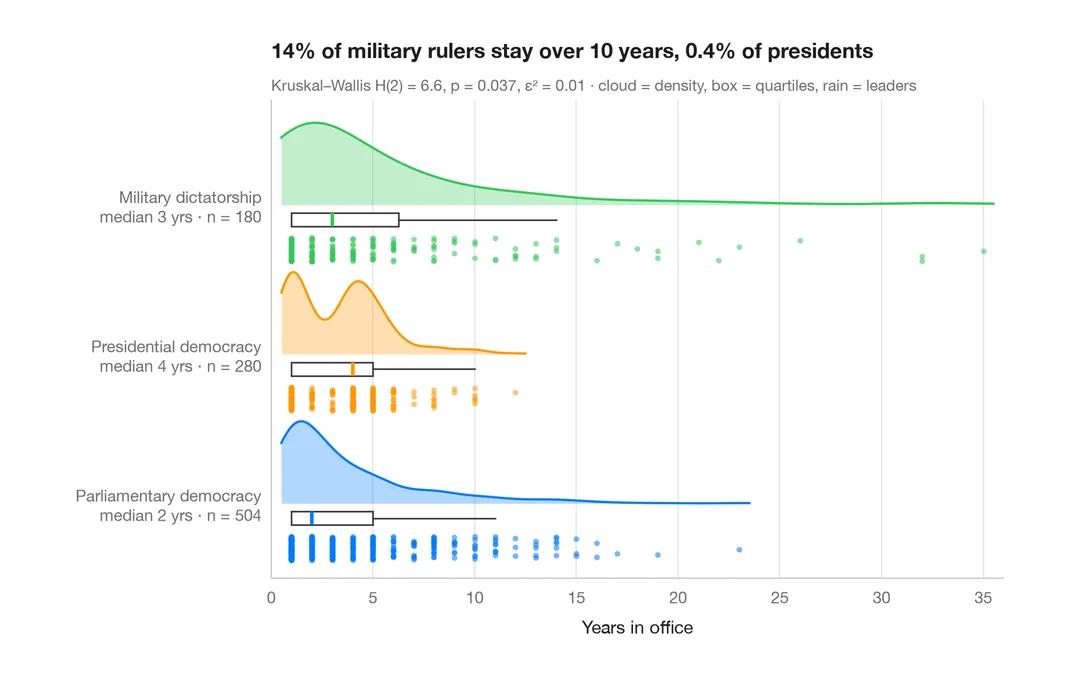
Graphique en nuage de pluie
Demi-violon, boîte à moustaches et points bruts par groupe, tracés à l'horizontale.
ggdist::stat_halfeye() / ggrain::geom_rain()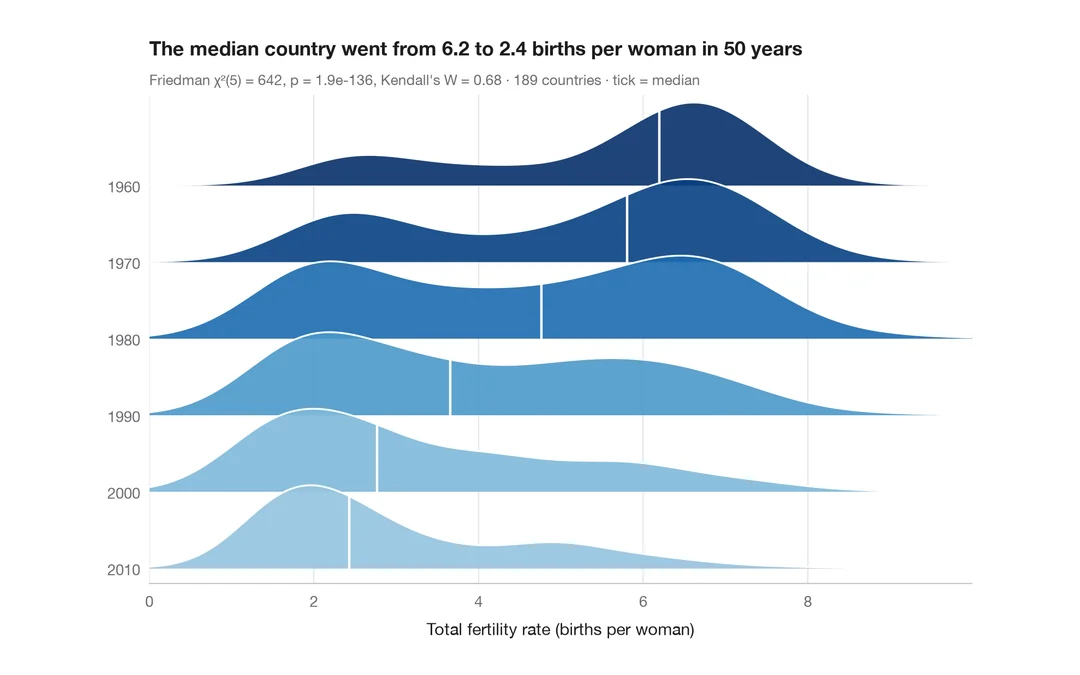
Graphique en crêtes
Courbes de densité qui se chevauchent pour comparer une distribution entre de nombreux groupes.
ggridges::geom_density_ridges()