Histogramme avec densité
Histogramme, densité par noyau et courbe normale ajustée, avec statistiques de forme.
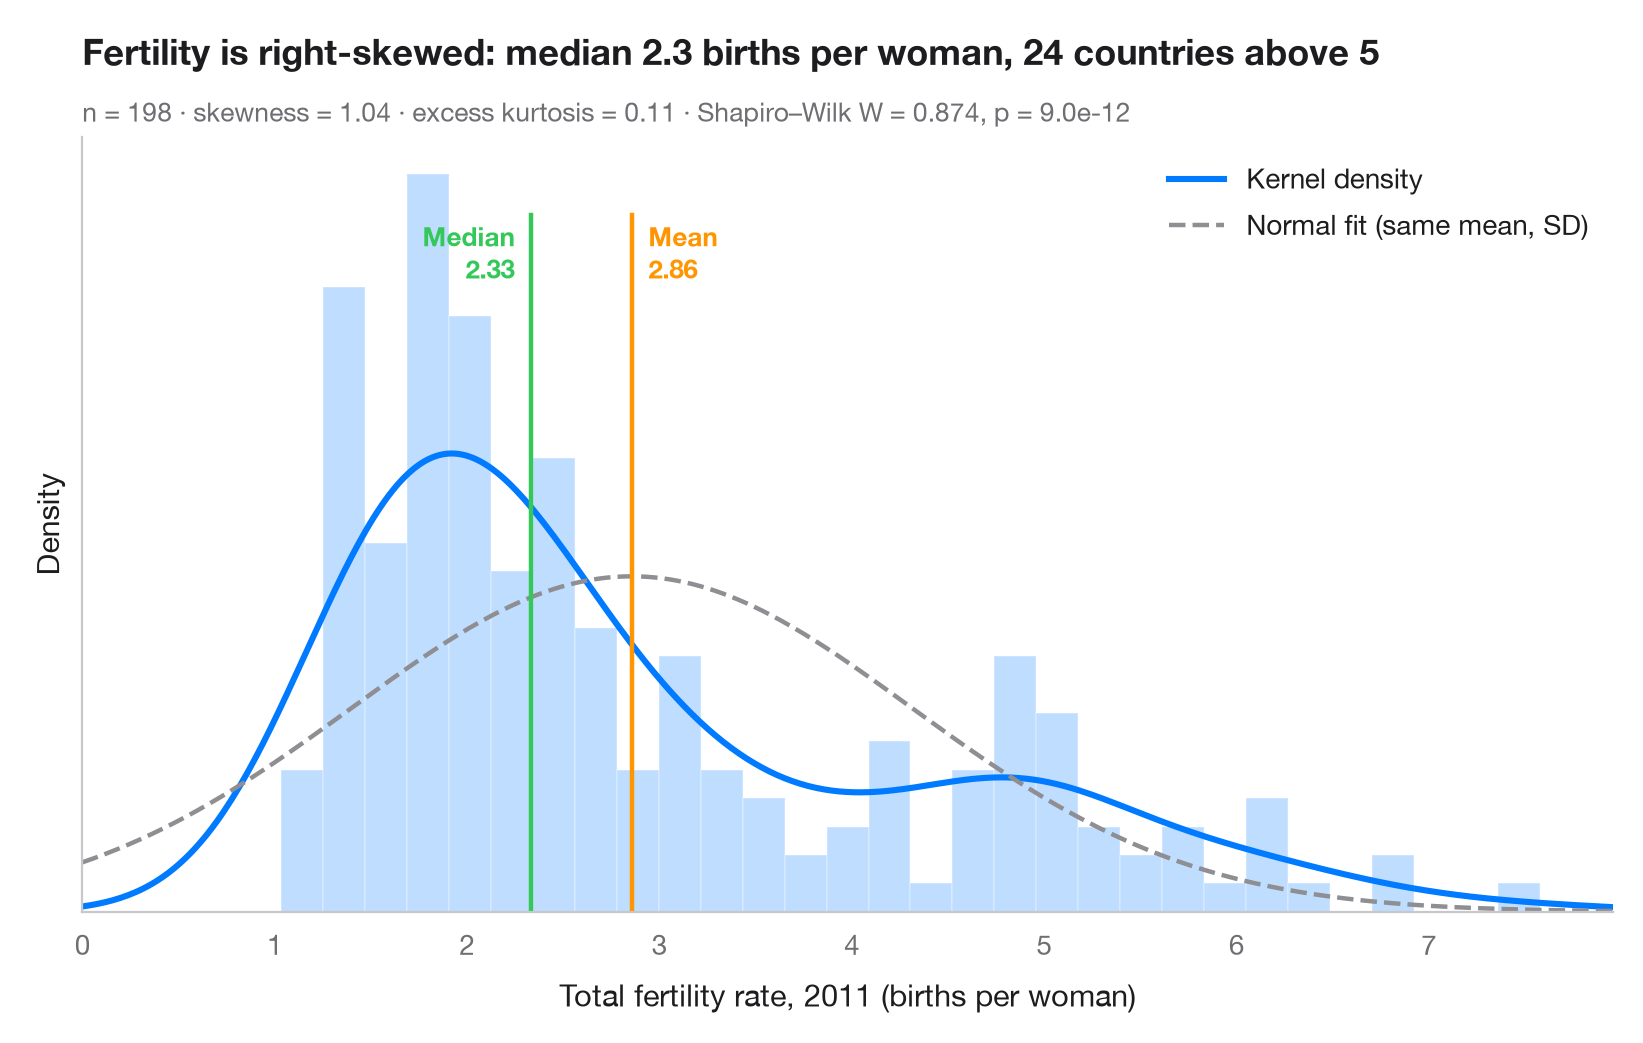
Le premier regard sur toute variable continue. Les barres montrent la distribution empirique sur une échelle de densité, la courbe pleine est une estimation de densité par noyau (KDE) et la courbe en tirets est la loi normale de même moyenne et de même écart type. Lorsque les deux courbes divergent, les données ne sont pas normales — ici, la longue queue à droite des pays à forte fécondité tire la moyenne au-dessus de la médiane.
Les données sont l'indice synthétique de fécondité de la Banque mondiale (naissances par femme) de 198 pays et territoires en 2011, dernière année disponible dans sm.datasets.fertility (statsmodels) ; les cinq agrégats régionaux sont retirés. scipy.stats.gaussian_kde trace la densité, scipy.stats.skew / kurtosis décrivent la forme et scipy.stats.shapiro teste la normalité.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from scipy import stats

# Data: total fertility rate (births per woman) of each country in 2011
wb = sm.datasets.fertility.load_pandas().data
wb = wb[~wb["Country Name"].str.contains("classification|income levels|members|small states")]  # 5 aggregates
x = wb["2011"].dropna().to_numpy()
mean, median, sd = x.mean(), np.median(x), x.std(ddof=1)

# Shape statistics and normality test
skew, kurt = stats.skew(x), stats.kurtosis(x)  # kurtosis: excess, 0 for a normal
W, p = stats.shapiro(x)

fig, ax = plt.subplots(figsize=(8, 5))
ax.hist(x, bins=30, density=True, color="#007AFF", alpha=0.25, edgecolor="white")

# Kernel density estimate and the normal curve with the same mean / SD
grid = np.linspace(0, x.max() * 1.05, 400)
ax.plot(grid, stats.gaussian_kde(x)(grid), color="#007AFF", lw=2.2, label="Kernel density")
ax.plot(grid, stats.norm.pdf(grid, mean, sd), color="#8E8E93", lw=1.6, ls="--",
        label="Normal fit (same mean, SD)")

# Mean and median markers
ymax = ax.get_ylim()[1]
for value, name, color, ha, dx in [(mean, "Mean", "#FF9500", "left", 6),
                                   (median, "Median", "#34C759", "right", -6)]:
    ax.axvline(value, color=color, lw=1.6, ymax=0.9)
    ax.annotate(f"{name}\n{value:.2f}", (value, ymax * 0.9), xytext=(dx, -2),
                textcoords="offset points", ha=ha, va="top", fontsize=9.5,
                fontweight="semibold", color=color)

ax.set_xlim(0, grid[-1])
ax.set_yticks([])
ax.set_ylabel("Density")
ax.set_xlabel("Total fertility rate, 2011 (births per woman)")
ax.legend(loc="upper right")
ax.set_title(f"Fertility is right-skewed: median {median:.1f} births per woman, "
             f"{(x > 5).sum()} countries above 5", pad=26)
ax.text(0, 1.02, f"n = {len(x)} · skewness = {skew:.2f} · excess kurtosis = {kurt:.2f} · "
        f"Shapiro–Wilk W = {W:.3f}, p = {p:.1e}", transform=ax.transAxes,
        fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- World Bank fertility rates by country, 1960–2013. World Bank. Fertility rate, total (births per woman), indicator SP.DYN.TFRT.IN. World Development Indicators. https://data.worldbank.org/indicator/SP.DYN.TFRT.IN
Primary sources: UN Population Division, UN Statistical Division, national statistical offices, Eurostat and others. Distributed with statsmodels (sm.datasets.fertility) under the World Bank terms of use.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Histogram with density. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/distributions/histogram-density/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Distributions
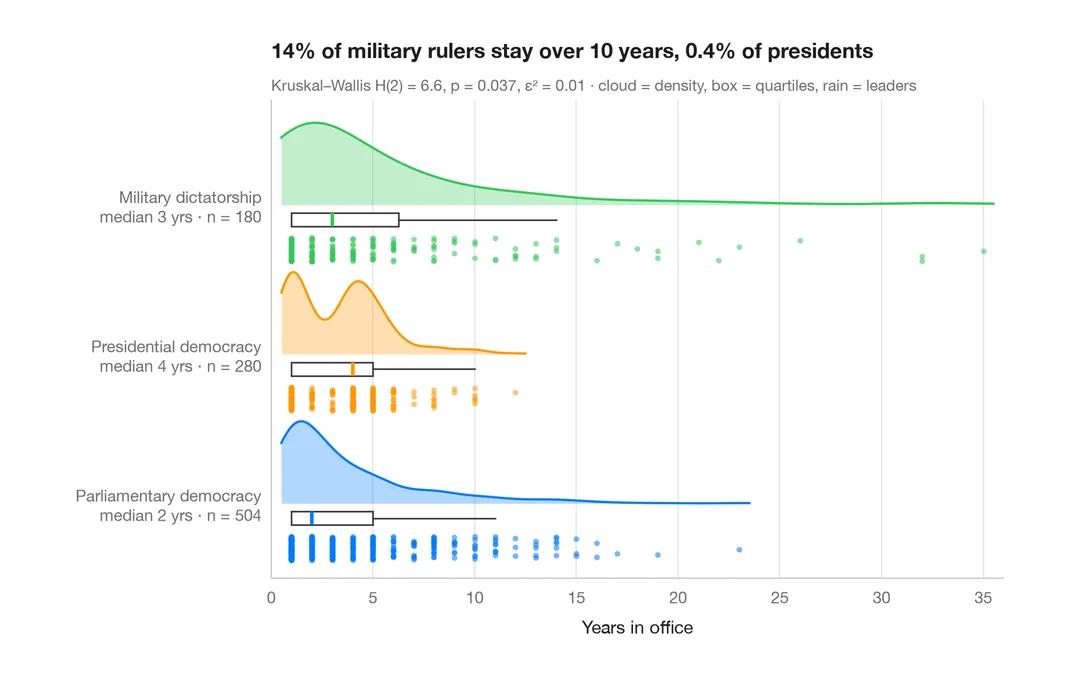
Graphique en nuage de pluie
Demi-violon, boîte à moustaches et points bruts par groupe, tracés à l'horizontale.
ggdist::stat_halfeye() / ggrain::geom_rain()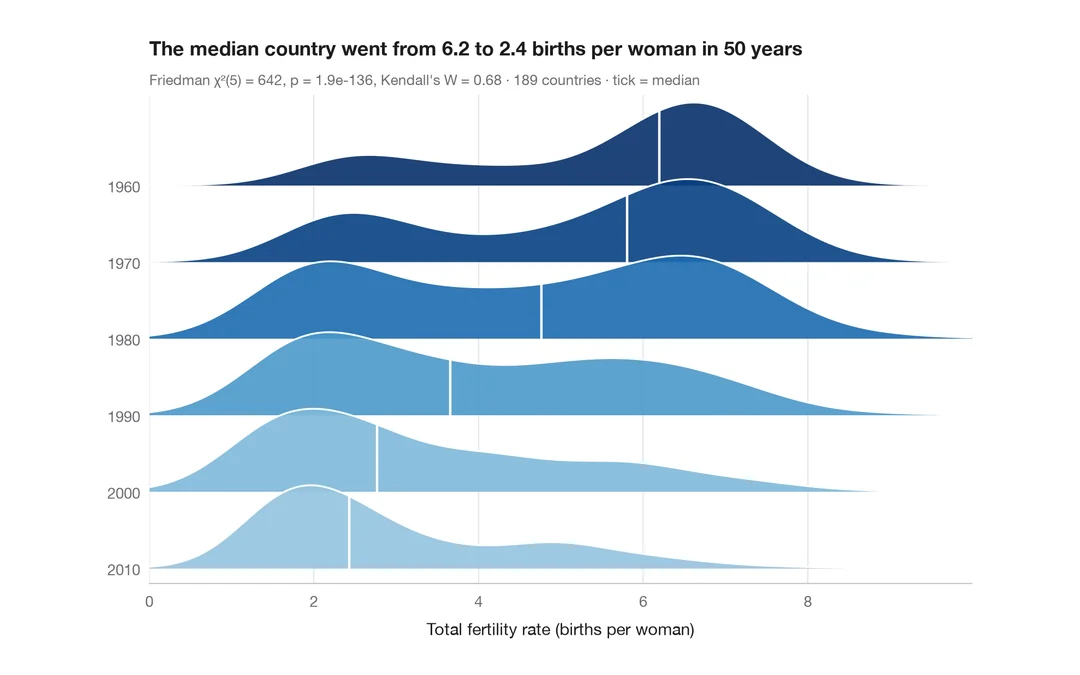
Graphique en crêtes
Courbes de densité qui se chevauchent pour comparer une distribution entre de nombreux groupes.
ggridges::geom_density_ridges()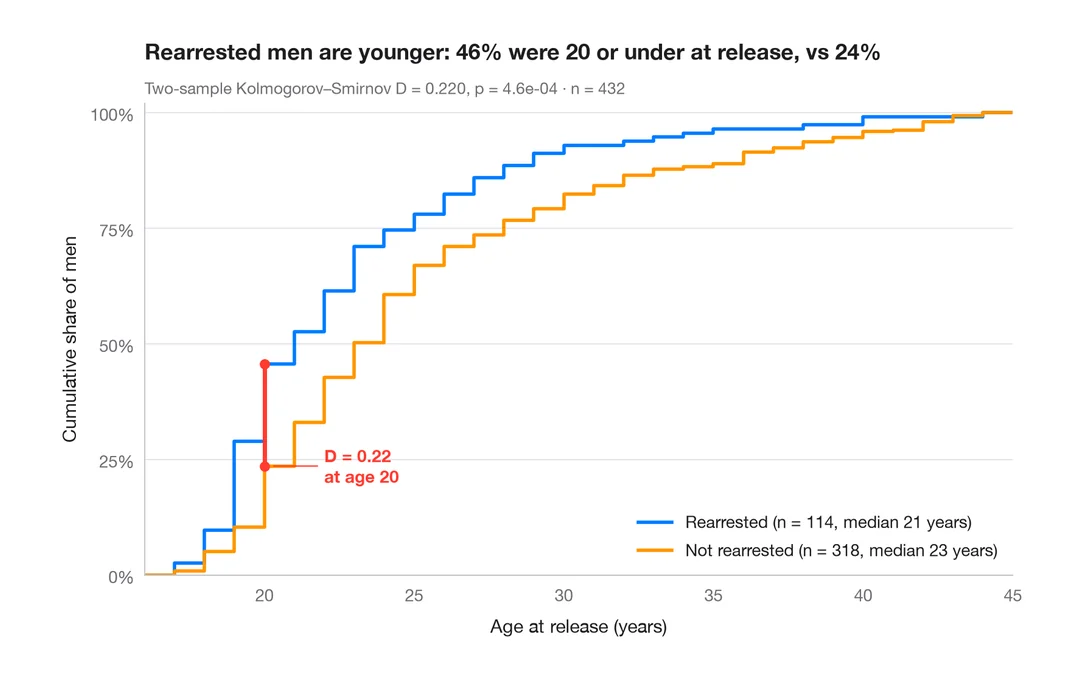
Comparaison de fonctions de répartition empiriques
Fonctions de répartition empiriques de deux groupes, avec l'écart de Kolmogorov–Smirnov.
ggplot2::stat_ecdf()