Graphique en crêtes
Courbes de densité qui se chevauchent pour comparer une distribution entre de nombreux groupes.
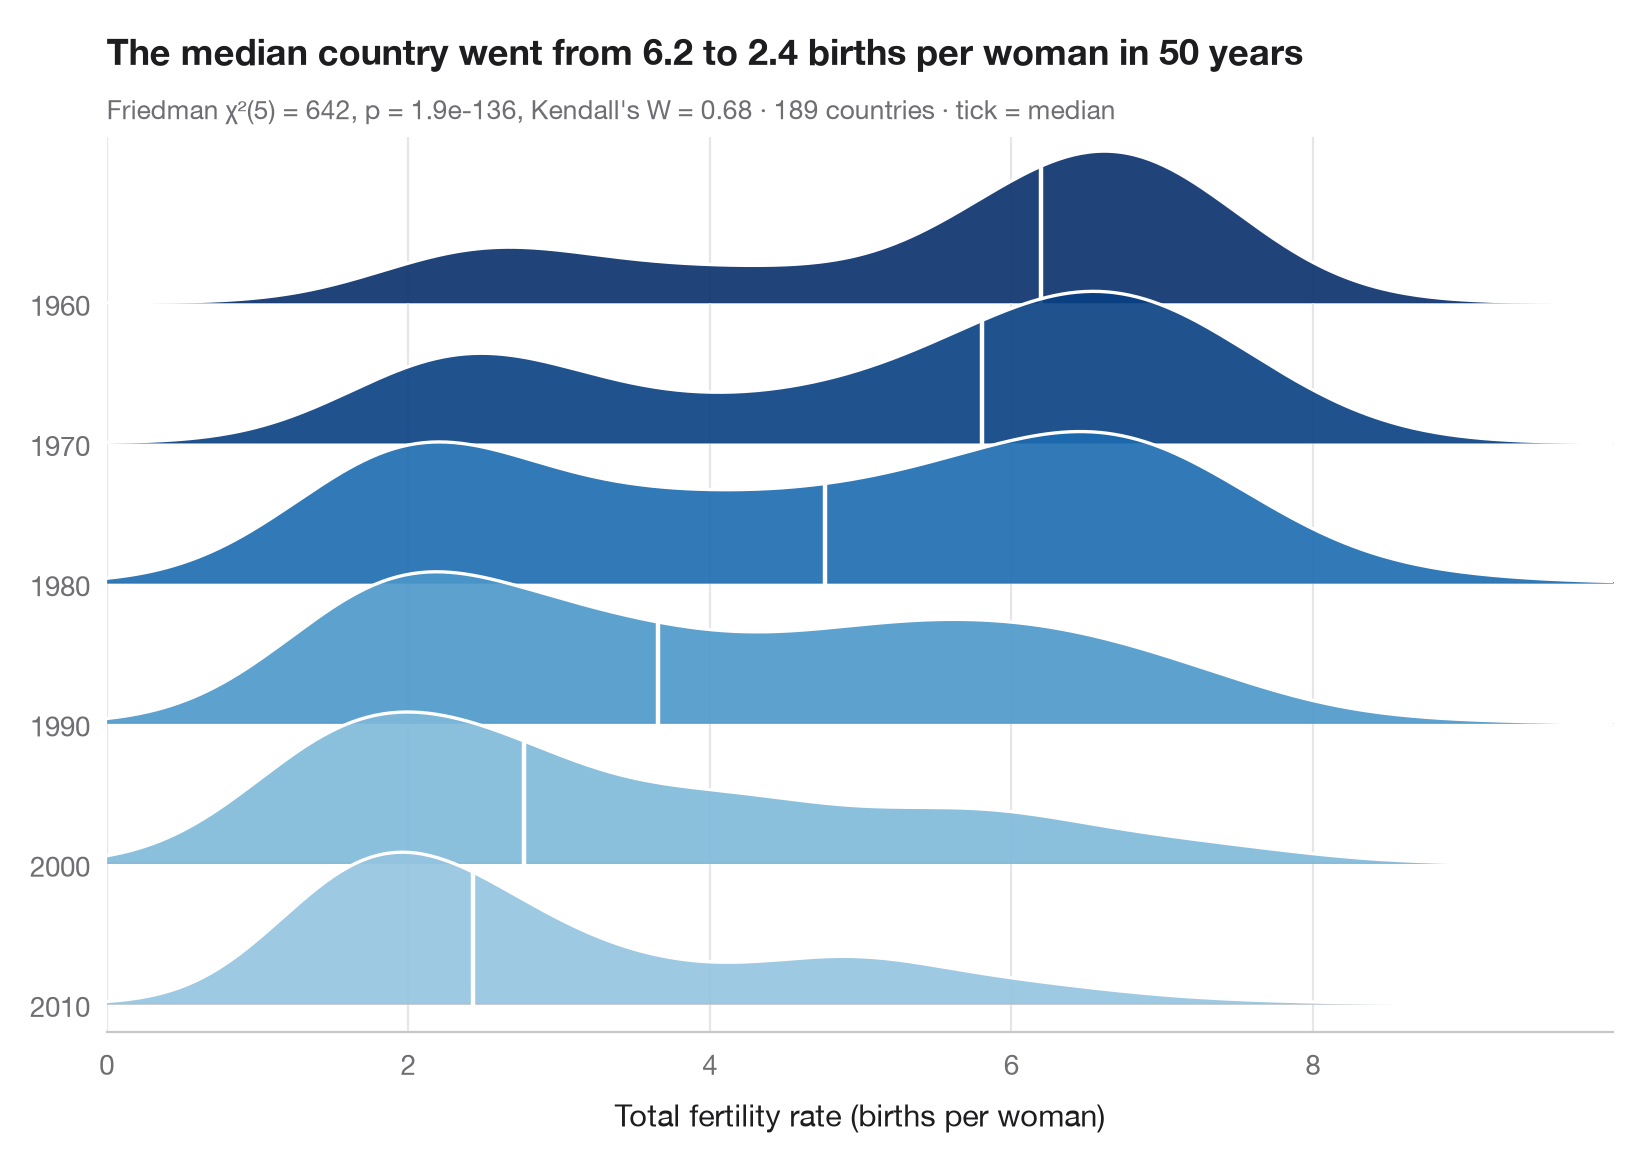
Un graphique en crêtes (ridgeline ou « joy » plot) empile une courbe de densité par groupe et les laisse se chevaucher légèrement, si bien que de nombreuses distributions tiennent dans une seule figure compacte. Ici, chaque crête est une année, tous les dix ans de 1960 à 2010, et montre comment la fécondité se répartissait entre les pays du monde ; le trait blanc marque la médiane, que la couleur encode également (plus foncé = plus de naissances), de sorte que la transition démographique — le glissement d'une fécondité élevée vers une fécondité faible, en passant par un monde à deux bosses dans les années 1970 et 1980 — se lit d'un coup d'œil.
Les données sont l'indice synthétique de fécondité de la Banque mondiale (naissances par femme) fourni avec statsmodels (sm.datasets.fertility), pour les 189 pays disposant d'une valeur en 1960, 1970, 1980, 1990, 2000 et 2010 (agrégats régionaux retirés). Les densités proviennent de scipy.stats.gaussian_kde ; comme chaque pays fournit une valeur par année, le sous-titre rapporte un test de Friedman (scipy.stats.friedmanchisquare, les pays servant de blocs) avec le W de Kendall comme taille d'effet.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from scipy import stats

# Data: one row per country, one column per decade (complete cases)
wb = sm.datasets.fertility.load_pandas().data
wb = wb[~wb["Country Name"].str.contains("classification|income levels|members|small states")]  # 5 aggregates
years = ["1960", "1970", "1980", "1990", "2000", "2010"]  # one ridge per decade
tfr = wb[years].dropna()

# Friedman test (countries are blocks) + Kendall's W
chi2, p = stats.friedmanchisquare(*[tfr[m] for m in years])
W = chi2 / (len(tfr) * (len(years) - 1))

grid = np.linspace(0, tfr.values.max() + 1, 400)
medians = tfr.median()
cmap, norm = plt.get_cmap("Blues"), plt.Normalize(medians.min() - 2.5, medians.max())

fig, ax = plt.subplots(figsize=(8, 5.6))
spacing, height = 1.0, 1.8  # vertical gap between ridges, peak height of a ridge
for i, m in enumerate(years):
    base = (len(years) - 1 - i) * spacing  # 1960 on top
    dens = stats.gaussian_kde(tfr[m])(grid)
    curve = base + height * dens / dens.max() * 0.6
    color = cmap(norm(medians[m]))
    ax.fill_between(grid, base, curve, color=color, alpha=0.9, lw=0, zorder=2 * i + 1)
    ax.plot(grid, curve, color="white", lw=1.2, zorder=2 * i + 2)
    ax.axhline(base, color="#C7C7CC", lw=0.6, zorder=2 * i)
    # White tick at the median
    y_med = base + height * stats.gaussian_kde(tfr[m])(medians[m])[0] / dens.max() * 0.6
    ax.plot([medians[m]] * 2, [base, y_med], color="white", lw=1.6, zorder=2 * i + 2)

ax.set_yticks([(len(years) - 1 - i) * spacing for i in range(len(years))], years)
ax.set_ylim(-0.2, (len(years) - 1) * spacing + height * 0.6 + 0.1)
ax.set_xlim(grid[0], grid[-1])
ax.grid(axis="x"); ax.grid(axis="y", visible=False)
ax.spines["left"].set_visible(False)
ax.set_xlabel("Total fertility rate (births per woman)")
ax.set_title(f"The median country went from {medians.iloc[0]:.1f} to {medians.iloc[-1]:.1f} "
             "births per woman in 50 years", pad=26)
ax.text(0, 1.02, f"Friedman χ²({len(years) - 1}) = {chi2:.0f}, p = {p:.1e}, Kendall's W = {W:.2f}"
        f" · {len(tfr)} countries · tick = median", transform=ax.transAxes,
        fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- World Bank fertility rates by country, 1960–2013. World Bank. Fertility rate, total (births per woman), indicator SP.DYN.TFRT.IN. World Development Indicators. https://data.worldbank.org/indicator/SP.DYN.TFRT.IN
Primary sources: UN Population Division, UN Statistical Division, national statistical offices, Eurostat and others. Distributed with statsmodels (sm.datasets.fertility) under the World Bank terms of use.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Ridgeline plot. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/distributions/ridgeline/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Distributions
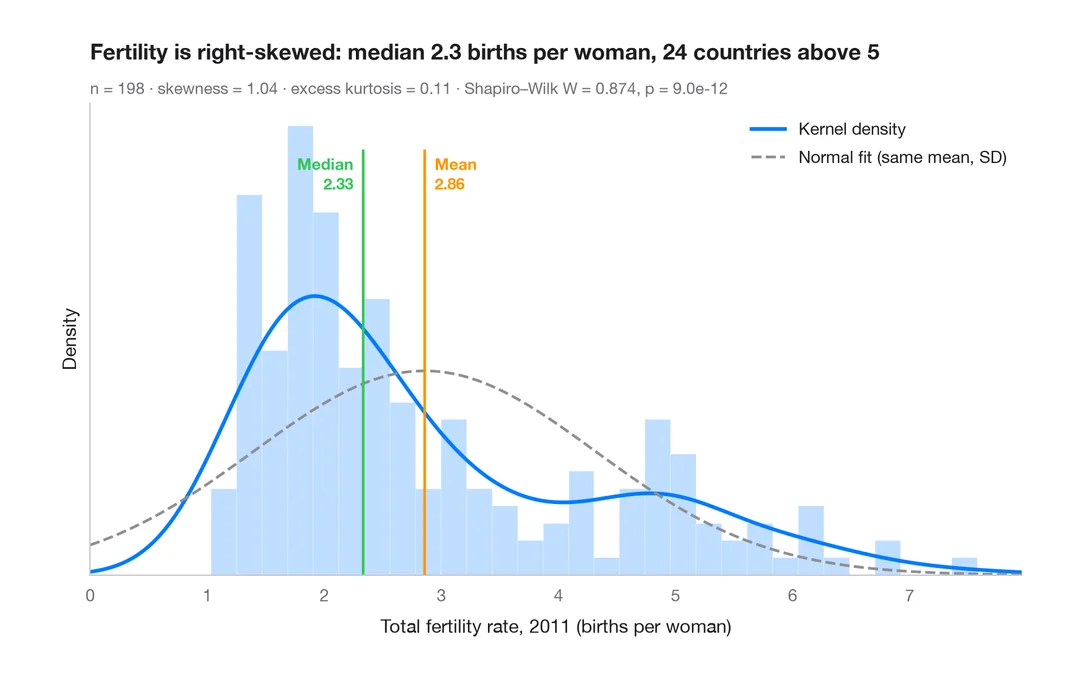
Histogramme avec densité
Histogramme, densité par noyau et courbe normale ajustée, avec statistiques de forme.
ggplot2::geom_histogram() + geom_density()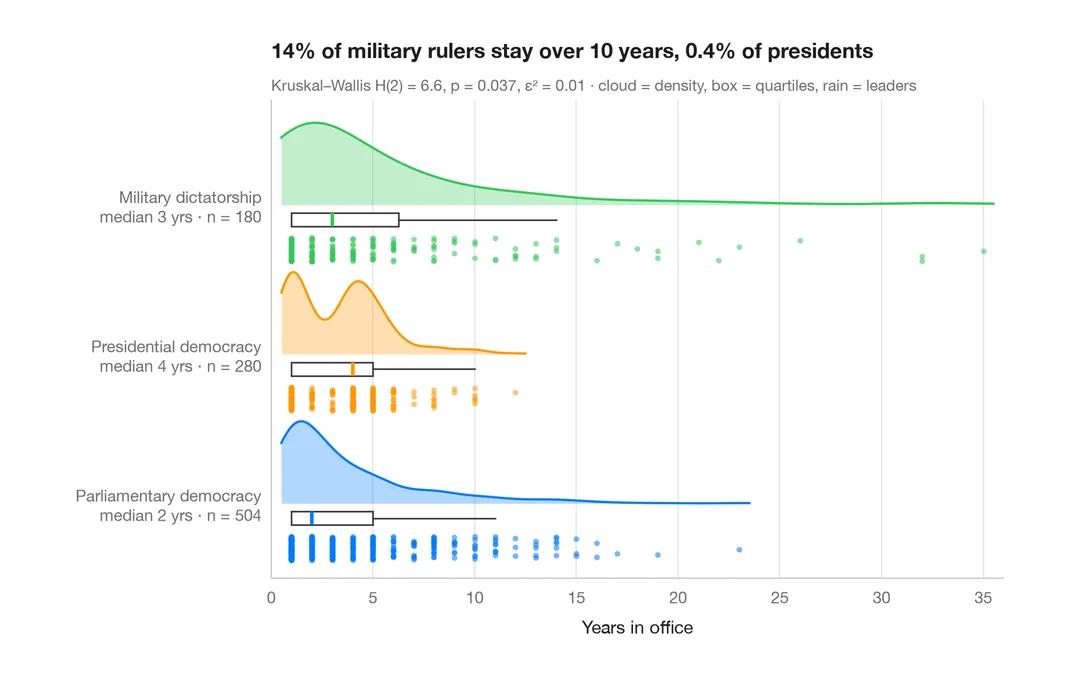
Graphique en nuage de pluie
Demi-violon, boîte à moustaches et points bruts par groupe, tracés à l'horizontale.
ggdist::stat_halfeye() / ggrain::geom_rain()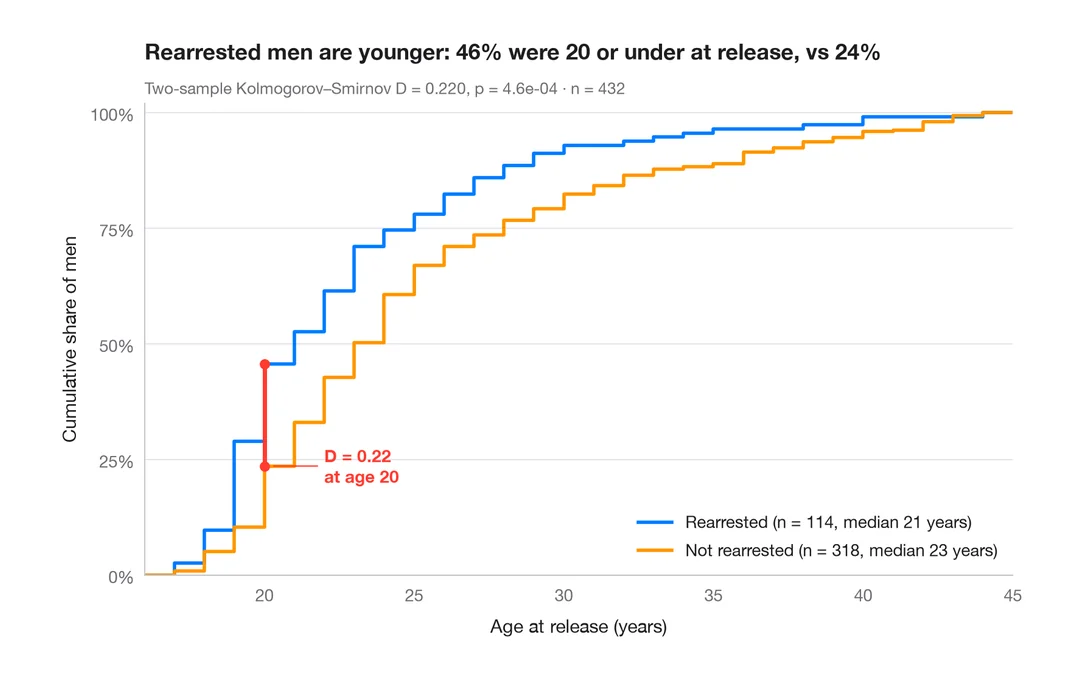
Comparaison de fonctions de répartition empiriques
Fonctions de répartition empiriques de deux groupes, avec l'écart de Kolmogorov–Smirnov.
ggplot2::stat_ecdf()