Matrice de corrélation
Carte de chaleur triangulaire des corrélations de Pearson ; les cellules non significatives (Holm) sont barrées.
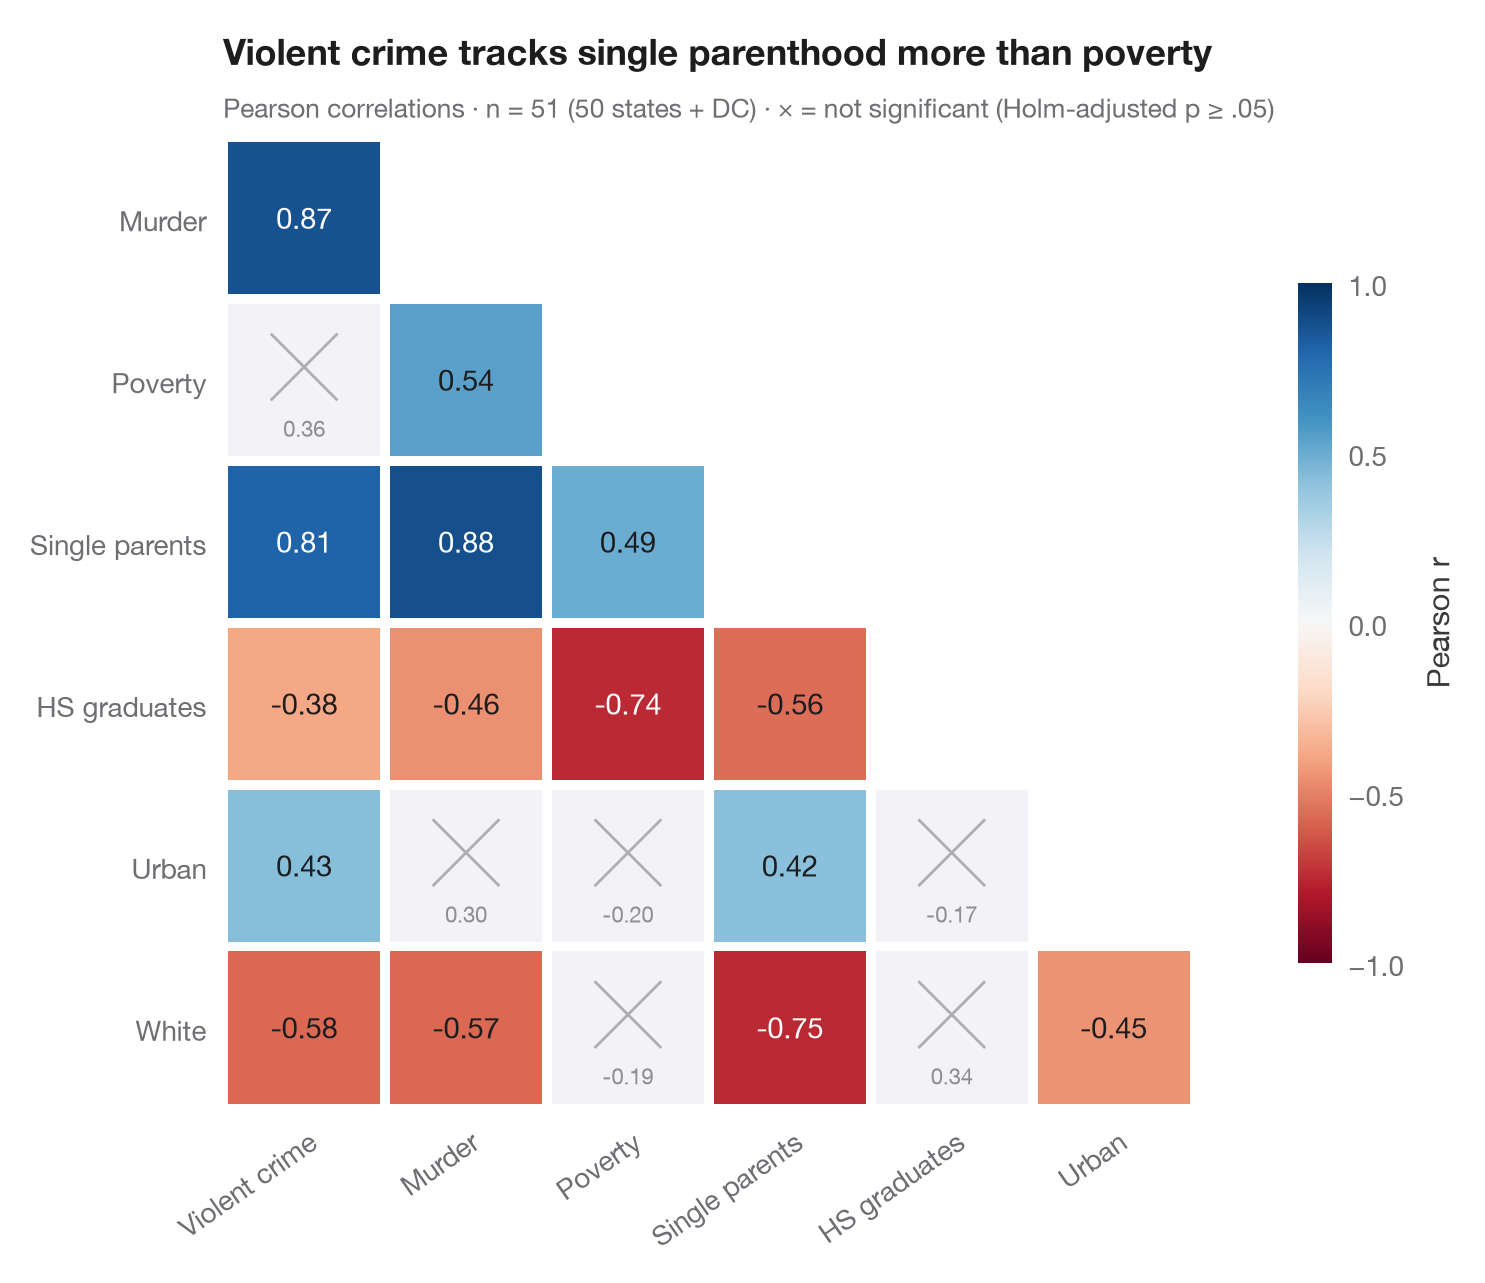
L'équivalent Python de ggcorrmat(). Seul le triangle inférieur est tracé, puisqu'une matrice de corrélation est symétrique ; chaque tuile affiche le r de Pearson, coloré sur une échelle divergente allant de −1 (rouge) à +1 (bleu). Comme 21 corrélations sont testées simultanément, les valeurs p sont ajustées selon Holm, et les paires non significatives au seuil α = .05 après ajustement sont grisées et barrées, pour que l'œil les ignore.
Les données sont les statistiques sur la criminalité des États américains fournies avec statsmodels (sm.datasets.statecrime, 50 États + DC). Les corrélations et les valeurs p proviennent de scipy.stats.pearsonr, l'ajustement de statsmodels.stats.multitest.multipletests(method="holm").
Le code et le texte à l'intérieur des figures sont en anglais.
from itertools import combinations

import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from scipy import stats
from statsmodels.stats.multitest import multipletests

# Data: US state crime statistics (bundled with statsmodels)
df = sm.datasets.statecrime.load_pandas().data
names = {"violent": "Violent crime", "murder": "Murder", "poverty": "Poverty",
         "single": "Single parents", "hs_grad": "HS graduates", "urban": "Urban", "white": "White"}
df = df[list(names)].rename(columns=names)
k = df.shape[1]

# Pearson r and Holm-adjusted p-values for every pair
pairs = list(combinations(range(k), 2))
tests = [stats.pearsonr(df.iloc[:, i], df.iloc[:, j]) for i, j in pairs]
p_adj = multipletests([t.pvalue for t in tests], method="holm")[1]

fig, ax = plt.subplots(figsize=(7.6, 6.2))
cmap, norm = plt.get_cmap("RdBu"), plt.Normalize(-1, 1)
for (i, j), t, p in zip(pairs, tests, p_adj):
    row, col = j, i                                    # lower triangle: row > column
    sig = p < 0.05
    ax.add_patch(plt.Rectangle((col - 0.5 + 0.03, row - 0.5 + 0.03), 0.94, 0.94,
                               color=cmap(norm(t.statistic)) if sig else "#F2F2F7", lw=0))
    if sig:
        ax.text(col, row, f"{t.statistic:.2f}", ha="center", va="center", fontsize=10.5,
                color="white" if abs(t.statistic) > 0.6 else "#1D1D1F")
    else:
        ax.plot([col - 0.2, col + 0.2], [row - 0.28, row + 0.12], color="#AEAEB2", lw=1)
        ax.plot([col - 0.2, col + 0.2], [row + 0.12, row - 0.28], color="#AEAEB2", lw=1)
        ax.text(col, row + 0.3, f"{t.statistic:.2f}", ha="center", va="center", fontsize=8, color="#8E8E93")

ax.set_xlim(-0.5, k - 1.5)
ax.set_ylim(k - 0.5, 0.5)
ax.set_xticks(range(k - 1), df.columns[:-1], rotation=35, ha="right", rotation_mode="anchor")
ax.set_yticks(range(1, k), df.columns[1:])
ax.set_aspect("equal")
ax.grid(False)
for s in ax.spines.values():
    s.set_visible(False)

cb = fig.colorbar(plt.cm.ScalarMappable(norm=norm, cmap=cmap), ax=ax, shrink=0.7, pad=0.02,
                  ticks=[-1, -0.5, 0, 0.5, 1])
cb.set_label("Pearson r", color="#3A3A3C")
cb.outline.set_visible(False)
ax.set_title("Violent crime tracks single parenthood more than poverty", pad=26)
ax.text(0, 1.02, f"Pearson correlations · n = {len(df)} (50 states + DC) · "
        f"× = not significant (Holm-adjusted p ≥ .05)", transform=ax.transAxes,
        fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- US state crime and social indicators, 2009. U.S. Census Bureau. Statistical Abstract of the United States, state tables for 2009 (crime rates from the FBI Uniform Crime Reporting program). https://www.statsmodels.org/stable/datasets/generated/statecrime.html
Compiled for statsmodels (sm.datasets.statecrime); public domain. See the statsmodels page for each variable's table and footnotes.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Correlation matrix. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/correlation/correlation-matrix/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Corrélation et association
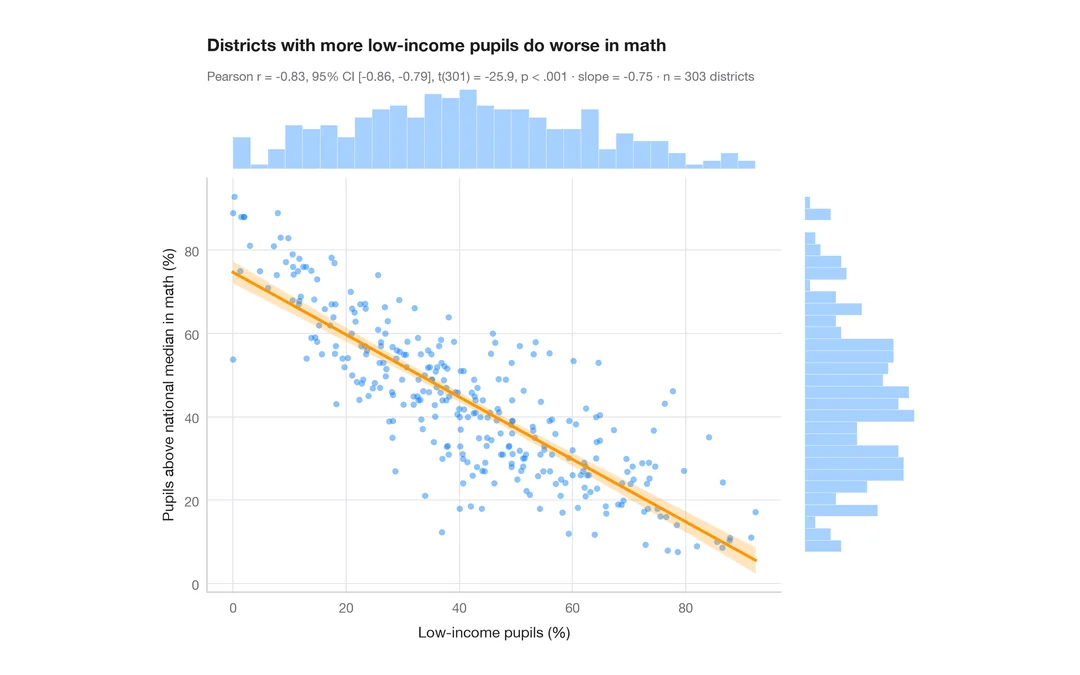
Nuage de points avec statistiques
Part d'élèves à faible revenu et résultats en mathématiques dans 303 districts californiens — nuage de points, droite des MCO avec bande à 95 %, histogrammes marginaux et r de Pearson.
ggstatsplot::ggscatterstats()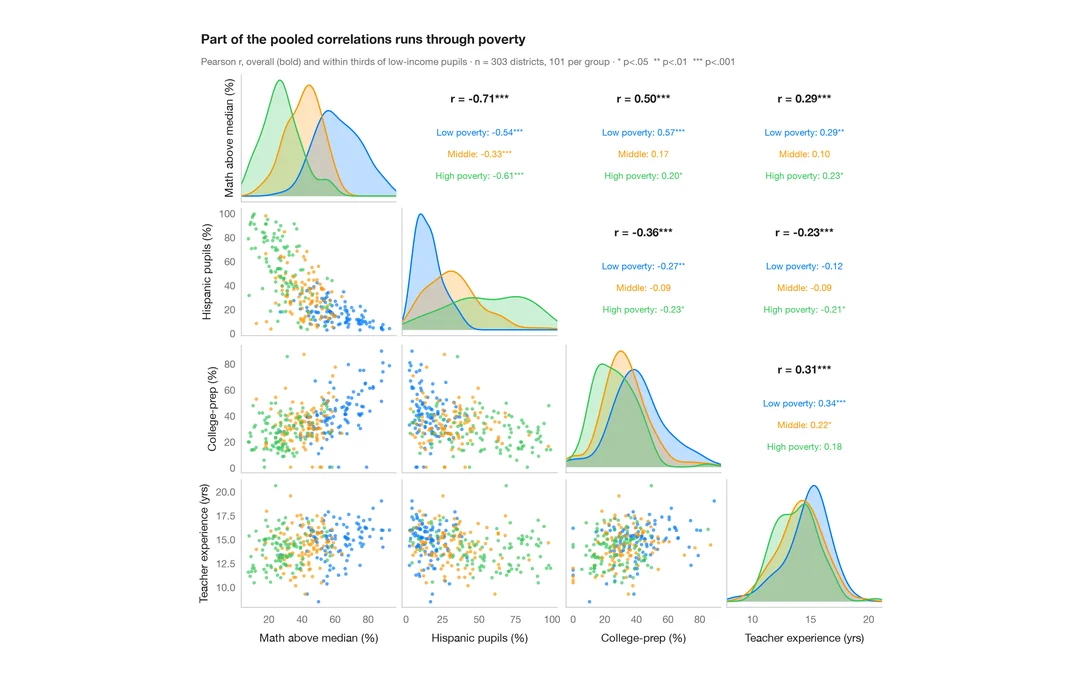
Matrice de nuages de points avec corrélations
Matrice de nuages de points de quatre variables de districts scolaires, avec densités par groupe sur la diagonale et corrélations globales et intragroupes au-dessus.
GGally::ggpairs()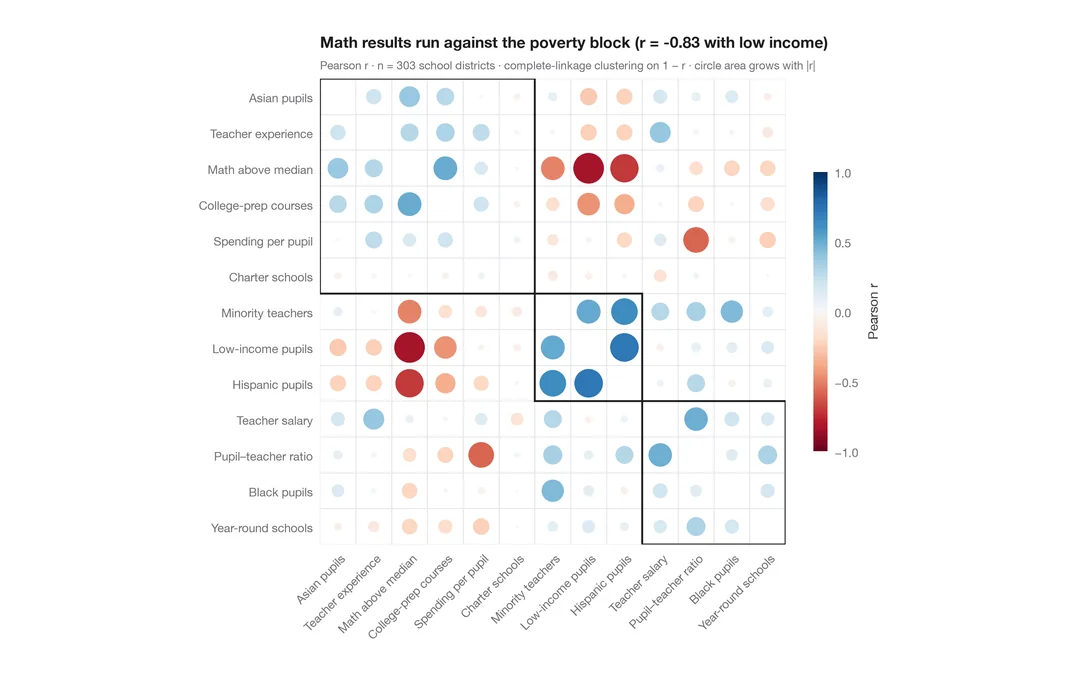
Corrélogramme avec classification
Cercles à la corrplot, dimensionnés et colorés selon r pour 13 indicateurs de districts scolaires, ordonnés par classification hiérarchique.
corrplot::corrplot(order = "hclust", addrect = 3)