Matrice de nuages de points avec corrélations
Matrice de nuages de points de quatre variables de districts scolaires, avec densités par groupe sur la diagonale et corrélations globales et intragroupes au-dessus.
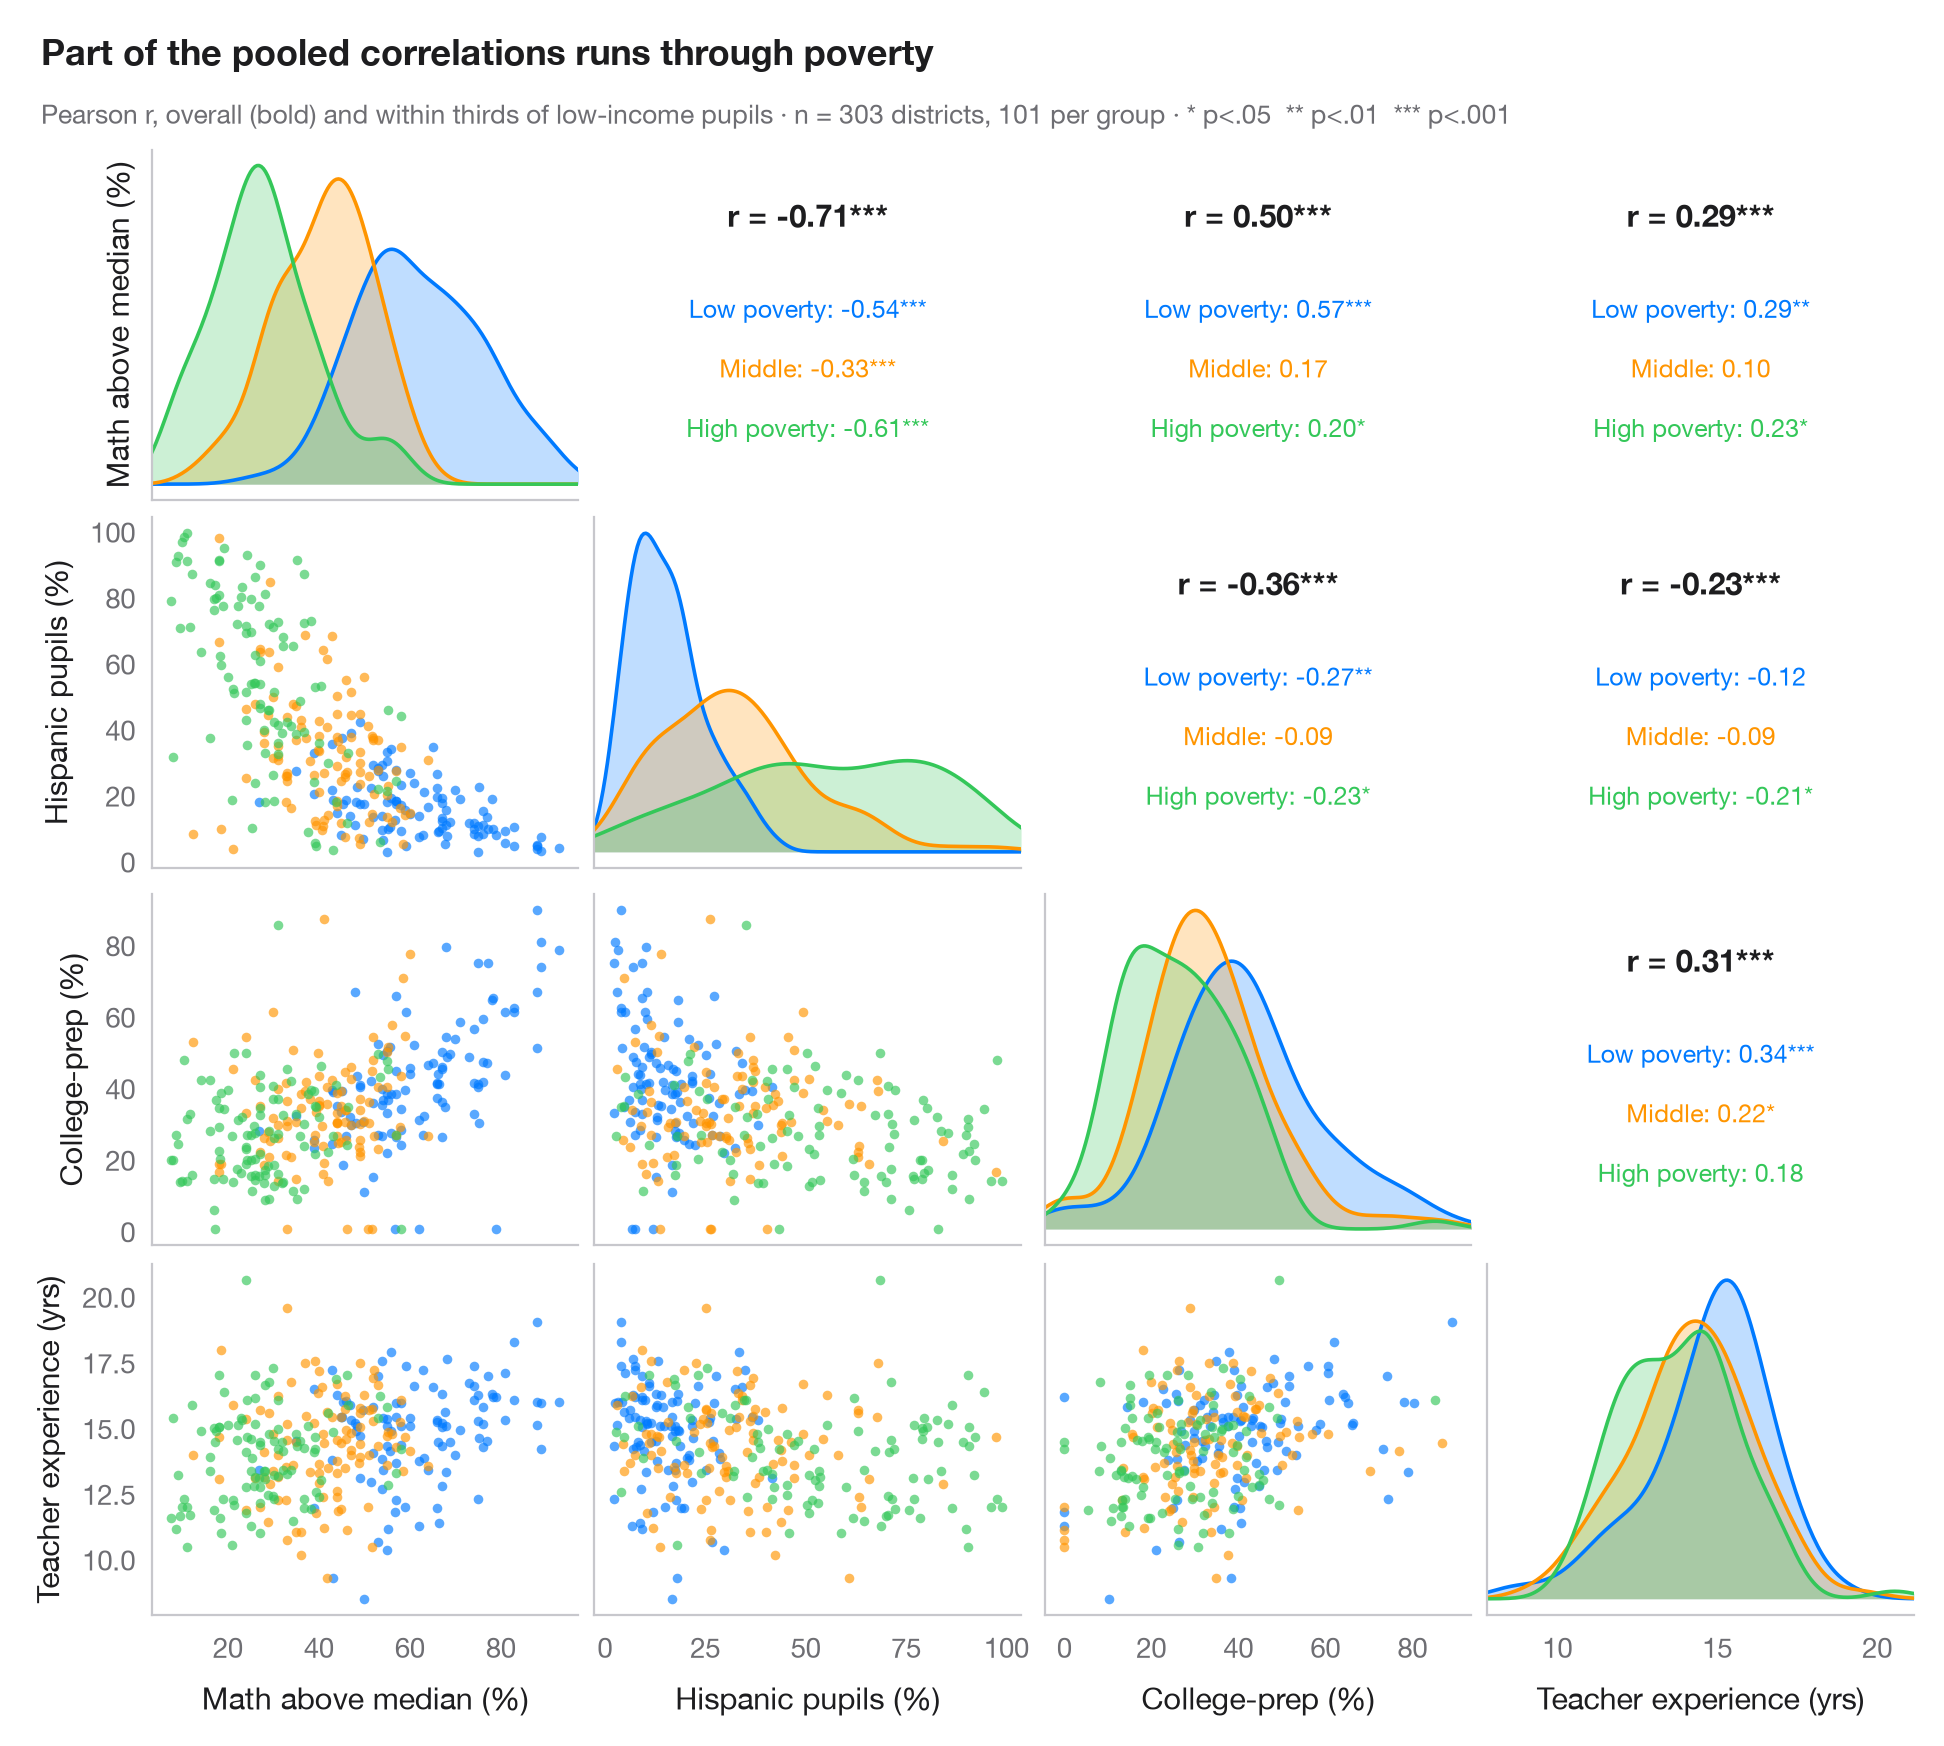
L'équivalent Python de GGally::ggpairs(). Chaque paire de variables obtient un nuage de points sous la diagonale, coloré par groupe ; la diagonale montre la densité de chaque variable par groupe ; et la cellule symétrique au-dessus de la diagonale affiche le r de Pearson, global (en gras) et au sein de chaque groupe, avec des étoiles de significativité. Tout l'intérêt est de comparer les deux : les corrélations globales et intragroupes peuvent différer fortement — jusqu'à changer de signe — lorsque les groupes occupent des régions différentes du graphique.
Les données sont les 303 districts scolaires californiens du test STAR98 fournis avec statsmodels (sm.datasets.star98) : la part d'élèves au-dessus de la médiane nationale en mathématiques, les parts d'élèves hispaniques et d'élèves inscrits en cours préparatoires à l'université (UC/CSU), et l'expérience moyenne des enseignants en années. Les districts sont répartis en tiers selon leur part d'élèves à faible revenu (pd.qcut, 101 chacun), de sorte que les coefficients intragroupes tiennent la pauvreté à peu près constante : le lien entre part d'élèves hispaniques et résultats en mathématiques, −0,71 au total, est plus faible dans chaque groupe de pauvreté. Les densités utilisent scipy.stats.gaussian_kde et les corrélations scipy.stats.pearsonr ; la grille est un simple plt.subplots(4, 4).
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import statsmodels.api as sm
from scipy import stats

# Data: 303 California school districts (STAR98), grouped by thirds of low-income pupils
raw = sm.datasets.star98.load_pandas().data
df = pd.DataFrame({"Math above median (%)": 100 * raw.NABOVE / (raw.NABOVE + raw.NBELOW),
                   "Hispanic pupils (%)": raw.PERHISP, "College-prep (%)": raw.PCTAF,
                   "Teacher experience (yrs)": raw.AVYRSEXP})
groups = ["Low poverty", "Middle", "High poverty"]
df["group"] = pd.qcut(raw.LOWINC, 3, labels=groups).astype(str)
cols = df.columns[:4]
palette = ["#007AFF", "#FF9500", "#34C759"]
stars = lambda p: "***" if p < .001 else "**" if p < .01 else "*" if p < .05 else ""

fig, axes = plt.subplots(4, 4, figsize=(9.5, 8.6), sharex="col")
lims = {c: (df[c].min() - 0.05 * np.ptp(df[c]), df[c].max() + 0.05 * np.ptp(df[c])) for c in cols}
fig.get_layout_engine().set(rect=(0, 0, 1, 0.92), w_pad=0.04, h_pad=0.04)
for i, yv in enumerate(cols):
    for j, xv in enumerate(cols):
        ax = axes[i, j]
        ax.grid(False)
        if i == j:                                       # diagonal: KDE per group
            grid = np.linspace(*lims[xv], 200)
            for s, c in zip(groups, palette):
                dens = stats.gaussian_kde(df.loc[df.group == s, xv])(grid)
                ax.fill_between(grid, dens, color=c, alpha=0.25, lw=0)
                ax.plot(grid, dens, color=c, lw=1.3)
            ax.set_yticks([])
        elif i > j:                                      # lower: scatter by group
            for s, c in zip(groups, palette):
                d = df[df.group == s]
                ax.scatter(d[xv], d[yv], s=12, color=c, alpha=0.65, lw=0)
            ax.set_ylim(lims[yv])
        else:                                            # upper: correlation coefficients
            r, p = stats.pearsonr(df[xv], df[yv])
            ax.text(0.5, 0.78, f"r = {r:.2f}{stars(p)}", ha="center", fontsize=11,
                    fontweight="semibold", transform=ax.transAxes)
            for k, (s, c) in enumerate(zip(groups, palette)):
                d = df[df.group == s]
                rs, ps = stats.pearsonr(d[xv], d[yv])
                ax.text(0.5, 0.52 - k * 0.17, f"{s}: {rs:.2f}{stars(ps)}", ha="center",
                        fontsize=9, color=c, transform=ax.transAxes)
            ax.tick_params(labelbottom=False, labelleft=False)
            for sp in ax.spines.values():
                sp.set_visible(False)
        if i < 3:
            ax.tick_params(labelbottom=False)
        if j > 0 or i == 0:
            ax.tick_params(labelleft=False)
        if i == 3:
            ax.set_xlabel(xv)
            ax.set_xlim(lims[xv])
        if j == 0:
            ax.set_ylabel(yv)

fig.text(0.01, 0.985, "Part of the pooled correlations runs through poverty", fontsize=13,
         fontweight="semibold", va="top")
fig.text(0.01, 0.945, f"Pearson r, overall (bold) and within thirds of low-income pupils · n = {len(df)} "
         "districts, 101 per group · * p<.05  ** p<.01  *** p<.001", fontsize=9.5, color="#6E6E73", va="top")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- California STAR test results, 1998 (303 school districts). Gill, J. (2001). Generalized Linear Models: A Unified Approach (Quantitative Applications in the Social Sciences, No. 134). Sage. https://www.statsmodels.org/stable/datasets/generated/star98.html
Original data from the California Department of Education's Standardized Testing and Reporting (STAR) program, 1998. Subset distributed with statsmodels (sm.datasets.star98) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Pairs plot with correlations. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/correlation/pairs-plot/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Corrélation et association
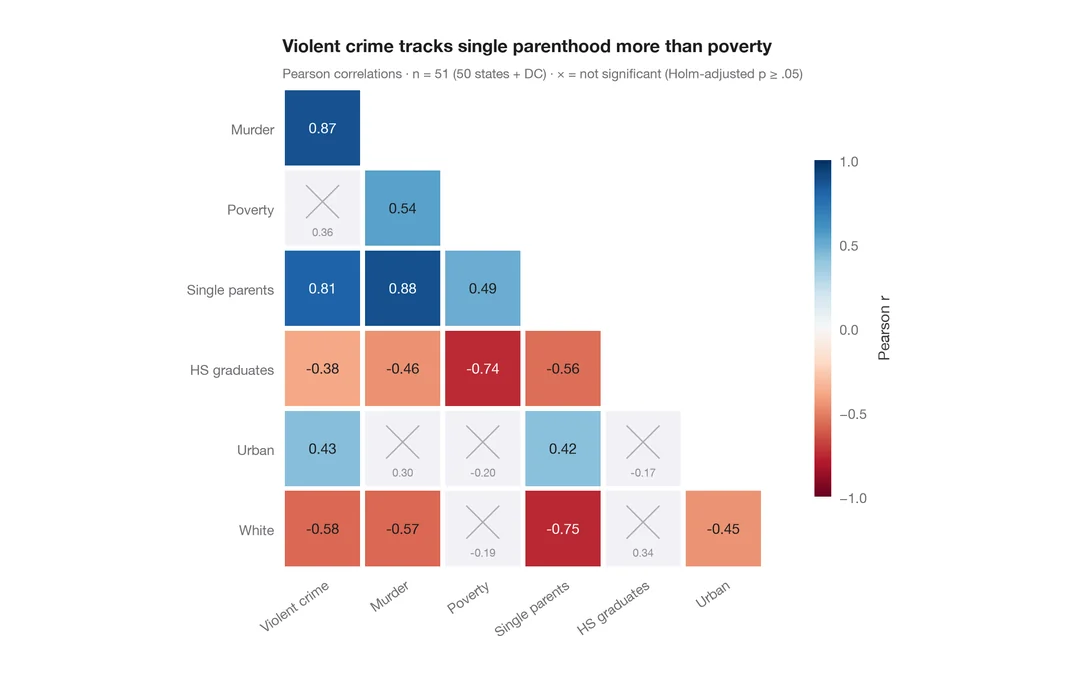
Matrice de corrélation
Carte de chaleur triangulaire des corrélations de Pearson ; les cellules non significatives (Holm) sont barrées.
ggstatsplot::ggcorrmat()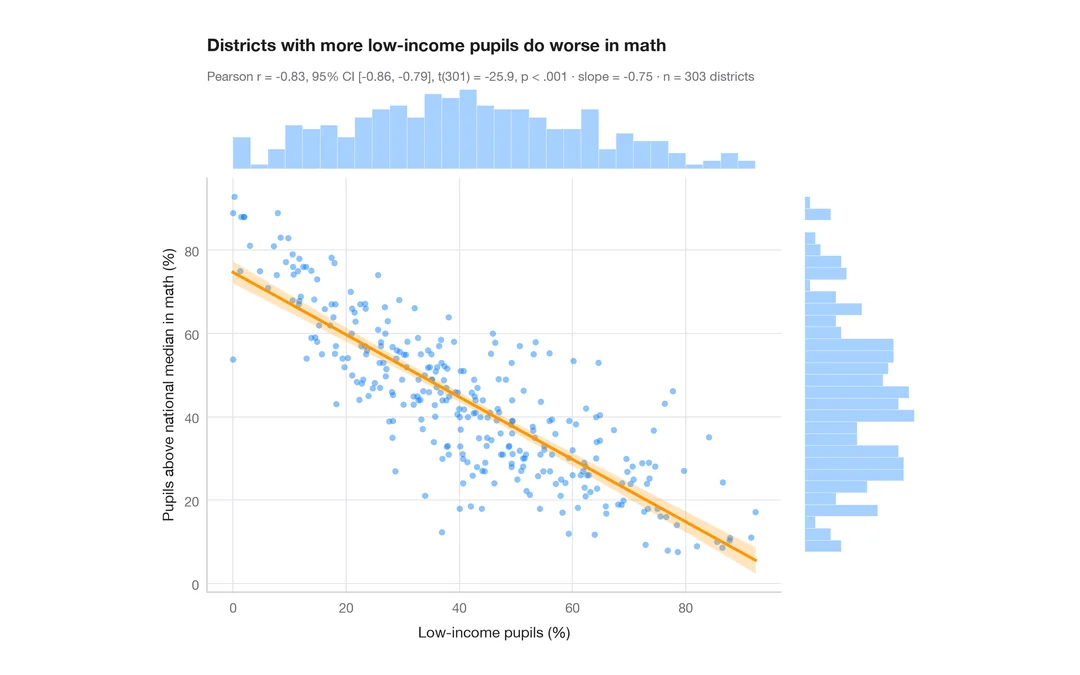
Nuage de points avec statistiques
Part d'élèves à faible revenu et résultats en mathématiques dans 303 districts californiens — nuage de points, droite des MCO avec bande à 95 %, histogrammes marginaux et r de Pearson.
ggstatsplot::ggscatterstats()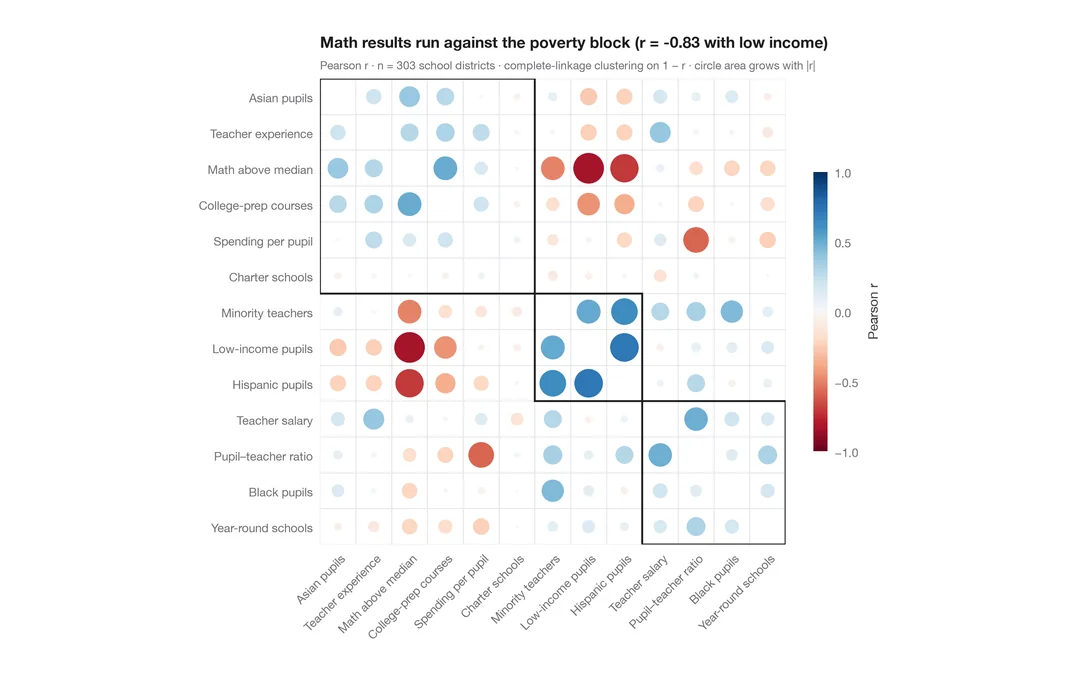
Corrélogramme avec classification
Cercles à la corrplot, dimensionnés et colorés selon r pour 13 indicateurs de districts scolaires, ordonnés par classification hiérarchique.
corrplot::corrplot(order = "hclust", addrect = 3)