Nuage de points avec statistiques
Part d'élèves à faible revenu et résultats en mathématiques dans 303 districts californiens — nuage de points, droite des MCO avec bande à 95 %, histogrammes marginaux et r de Pearson.
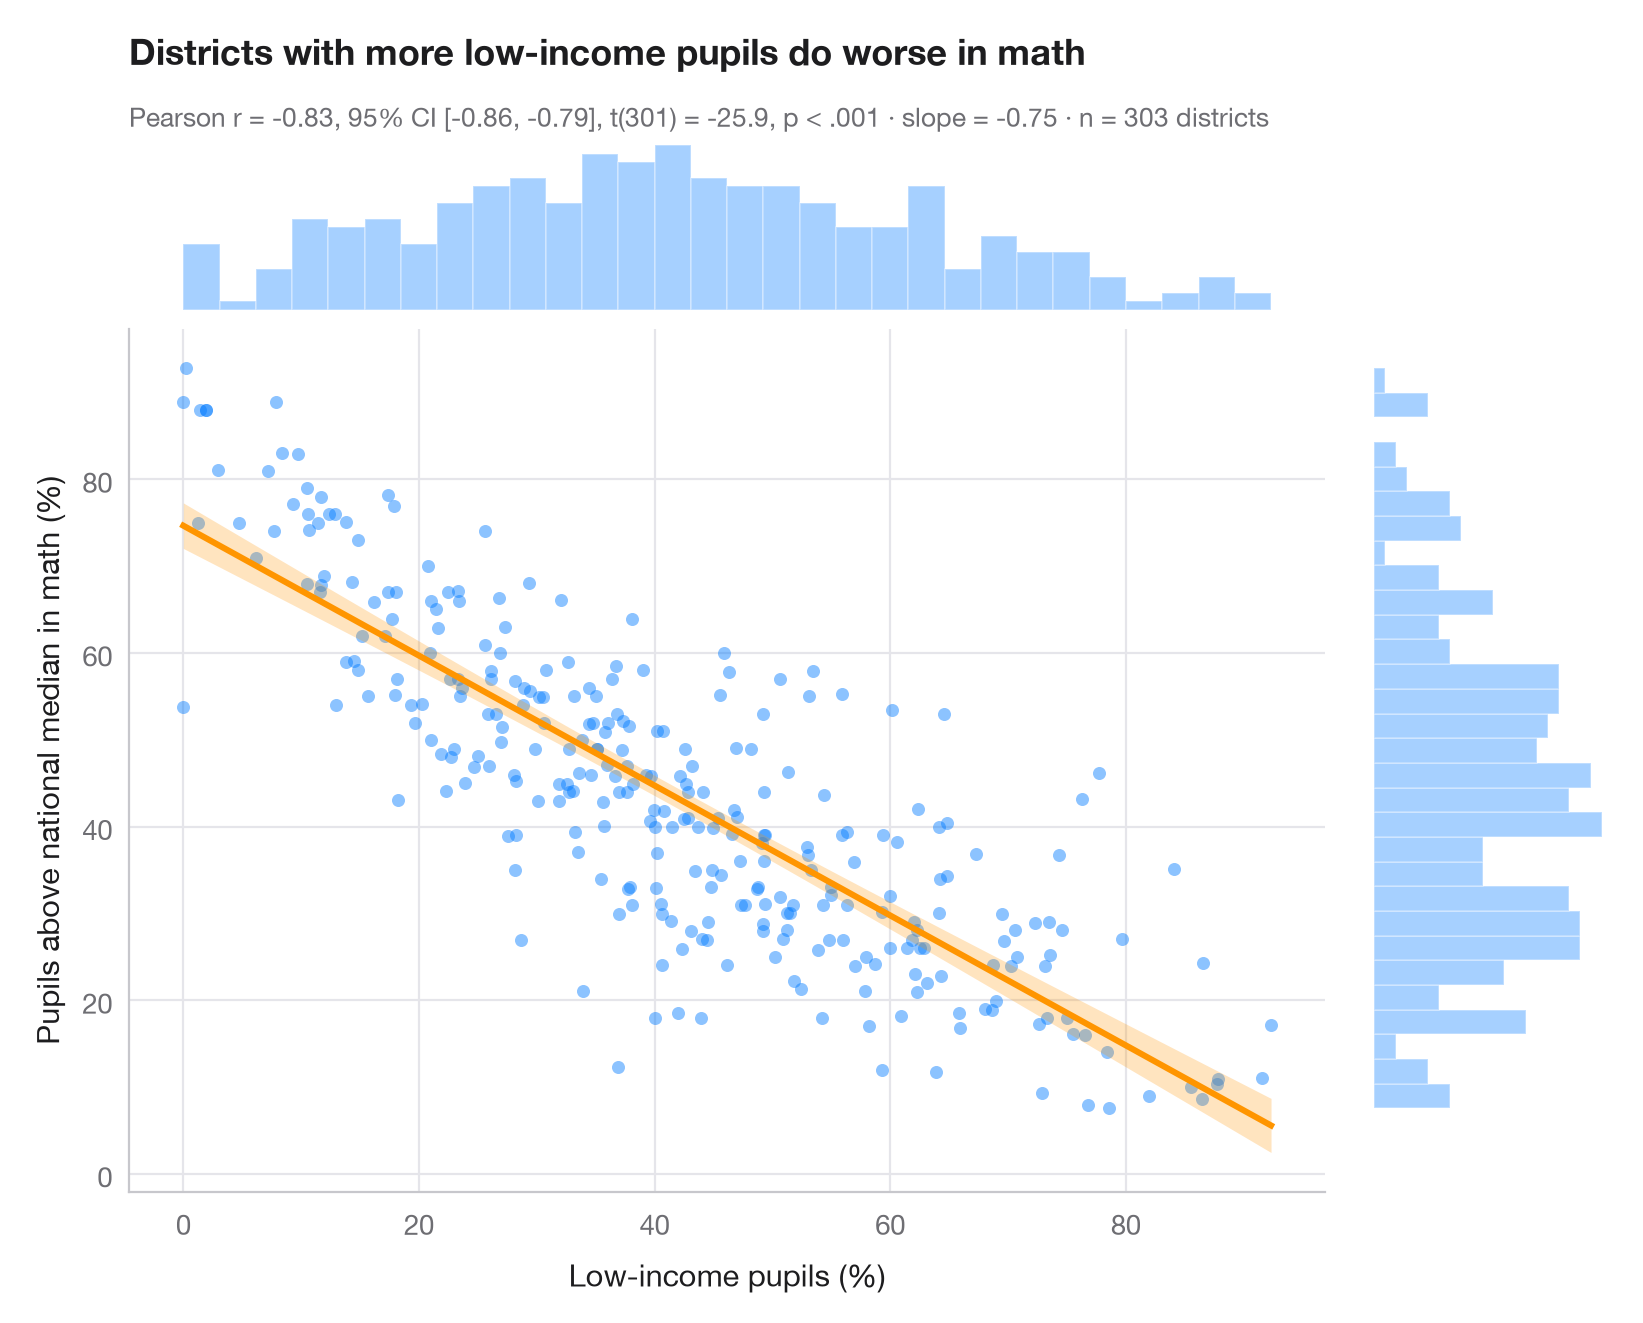
L'équivalent Python de ggscatterstats(). Le panneau central montre chaque observation avec la droite des moindres carrés et sa bande de confiance à 95 % (l'incertitude porte sur la moyenne de y pour chaque x, et non sur les points individuels). Les histogrammes marginaux, en haut et à droite, révèlent la forme de chaque variable, que le coefficient de corrélation suppose tacitement raisonnable. Le sous-titre rapporte le r de Pearson avec son intervalle de confiance à 95 %, le test t, la pente des MCO et la taille de l'échantillon.
Les données sont les 303 districts scolaires californiens du test STAR98 fournis avec statsmodels (sm.datasets.star98) : la part d'élèves issus de familles à faible revenu en regard de la part d'élèves testés au-dessus de la médiane nationale en mathématiques, calculée comme NABOVE / (NABOVE + NBELOW). Une pente de −0,75 signifie environ 7,5 points d'élèves en moins au-dessus de la médiane pour 10 points d'élèves à faible revenu en plus — une association entre districts, pas un effet. Le test provient de scipy.stats.pearsonr, la droite et la bande de get_prediction().conf_int() des MCO de statsmodels.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from scipy import stats

# Data: low-income pupils and math results in 303 California school districts
data = sm.datasets.star98.load_pandas().data
x = data["LOWINC"].to_numpy()
y = (100 * data["NABOVE"] / (data["NABOVE"] + data["NBELOW"])).to_numpy()
n = len(x)

# Pearson correlation with its 95% CI
res = stats.pearsonr(x, y)
ci = res.confidence_interval(0.95)

# OLS fit and 95% confidence band for the mean
fit = sm.OLS(y, sm.add_constant(x)).fit()
grid = np.linspace(x.min(), x.max(), 200)
band = fit.get_prediction(sm.add_constant(grid)).conf_int(alpha=0.05)

fig = plt.figure(figsize=(8, 6.4))
gs = fig.add_gridspec(2, 2, width_ratios=(5, 1), height_ratios=(1, 5), wspace=0.03, hspace=0.03)
ax = fig.add_subplot(gs[1, 0])
ax_top = fig.add_subplot(gs[0, 0], sharex=ax)
ax_right = fig.add_subplot(gs[1, 1], sharey=ax)

ax.scatter(x, y, s=22, color="#007AFF", alpha=0.45, lw=0)
ax.fill_between(grid, band[:, 0], band[:, 1], color="#FF9500", alpha=0.25, lw=0)
ax.plot(grid, fit.params[0] + fit.params[1] * grid, color="#FF9500", lw=2.2)
ax.set_xlabel("Low-income pupils (%)")
ax.set_ylabel("Pupils above national median in math (%)")
ax.grid(axis="x")

# Marginal histograms
ax_top.hist(x, bins=30, color="#007AFF", alpha=0.35, edgecolor="white")
ax_right.hist(y, bins=30, color="#007AFF", alpha=0.35, edgecolor="white", orientation="horizontal")
for a in (ax_top, ax_right):
    a.axis("off")

ax_top.set_title("Districts with more low-income pupils do worse in math", pad=26)
p_txt = "p < .001" if res.pvalue < 0.001 else f"p = {res.pvalue:.3f}"
ax_top.text(0, 1.06, f"Pearson r = {res.statistic:.2f}, 95% CI [{ci.low:.2f}, {ci.high:.2f}], "
            f"t({n - 2}) = {fit.tvalues[1]:.1f}, {p_txt} · slope = {fit.params[1]:.2f} · n = {n} districts",
            transform=ax_top.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- California STAR test results, 1998 (303 school districts). Gill, J. (2001). Generalized Linear Models: A Unified Approach (Quantitative Applications in the Social Sciences, No. 134). Sage. https://www.statsmodels.org/stable/datasets/generated/star98.html
Original data from the California Department of Education's Standardized Testing and Reporting (STAR) program, 1998. Subset distributed with statsmodels (sm.datasets.star98) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Scatterplot with statistics. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/correlation/scatter-with-stats/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Corrélation et association
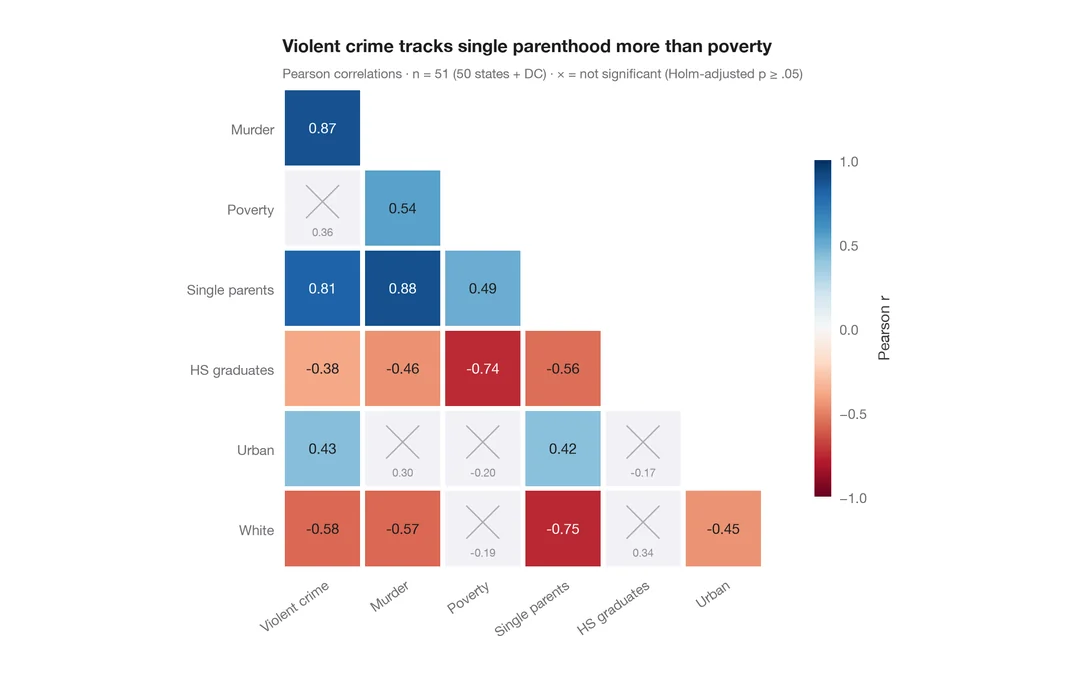
Matrice de corrélation
Carte de chaleur triangulaire des corrélations de Pearson ; les cellules non significatives (Holm) sont barrées.
ggstatsplot::ggcorrmat()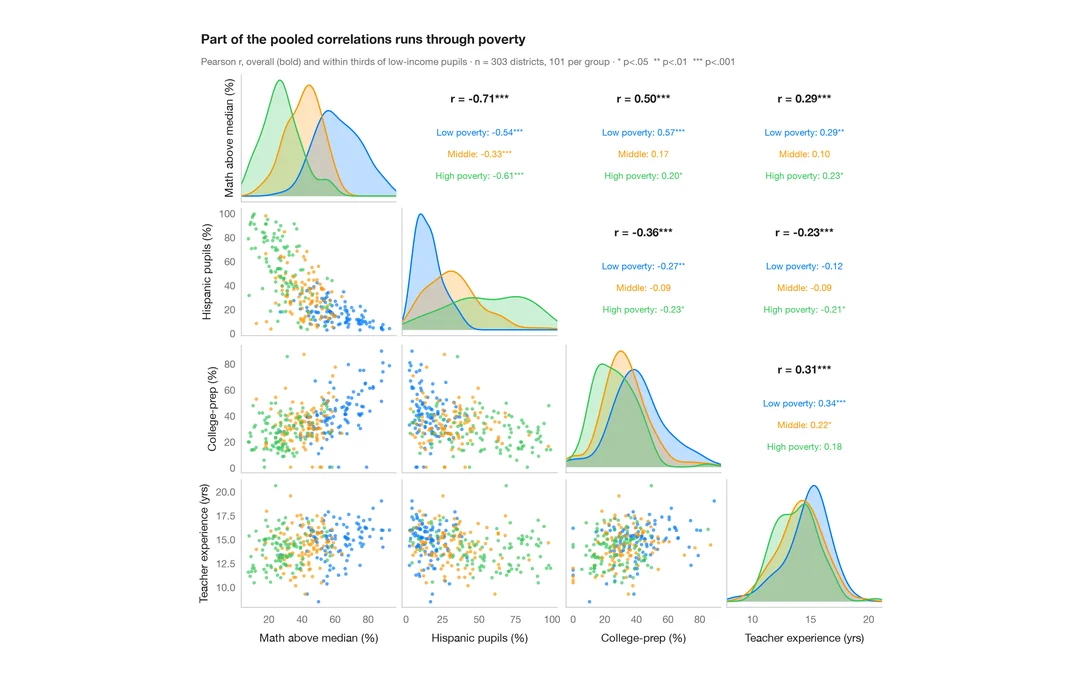
Matrice de nuages de points avec corrélations
Matrice de nuages de points de quatre variables de districts scolaires, avec densités par groupe sur la diagonale et corrélations globales et intragroupes au-dessus.
GGally::ggpairs()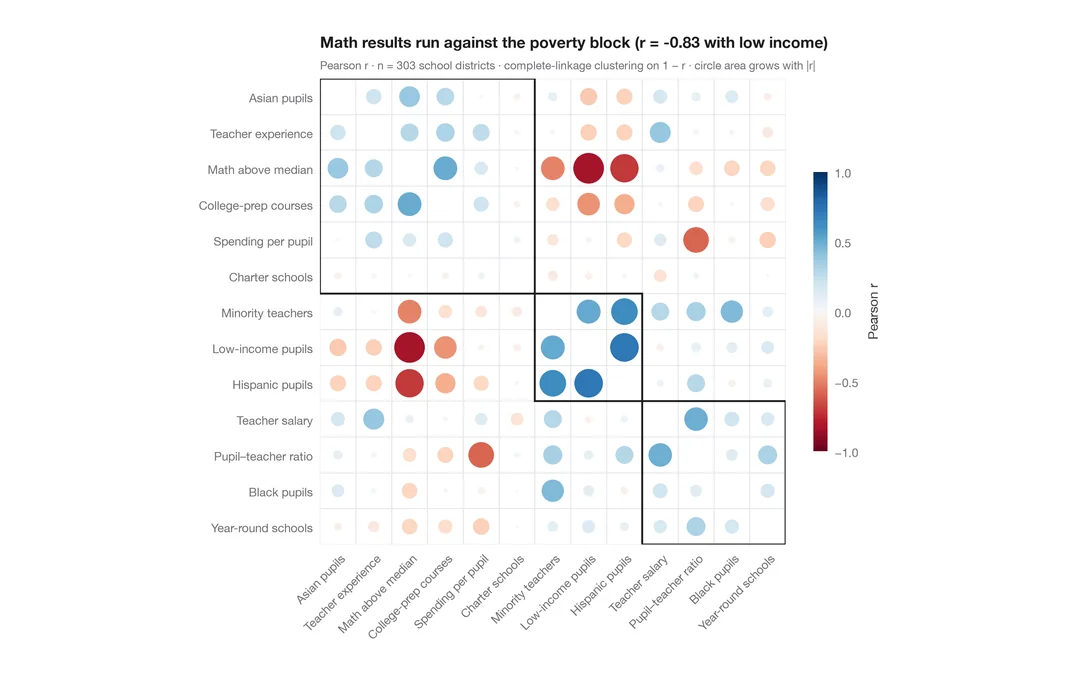
Corrélogramme avec classification
Cercles à la corrplot, dimensionnés et colorés selon r pour 13 indicateurs de districts scolaires, ordonnés par classification hiérarchique.
corrplot::corrplot(order = "hclust", addrect = 3)