Carte des regroupements LISA (autocorrélation locale)
Où se trouvent les regroupements et les valeurs atypiques spatiales — I de Moran local pour chaque zone, cartographié avec sa significativité par permutation.
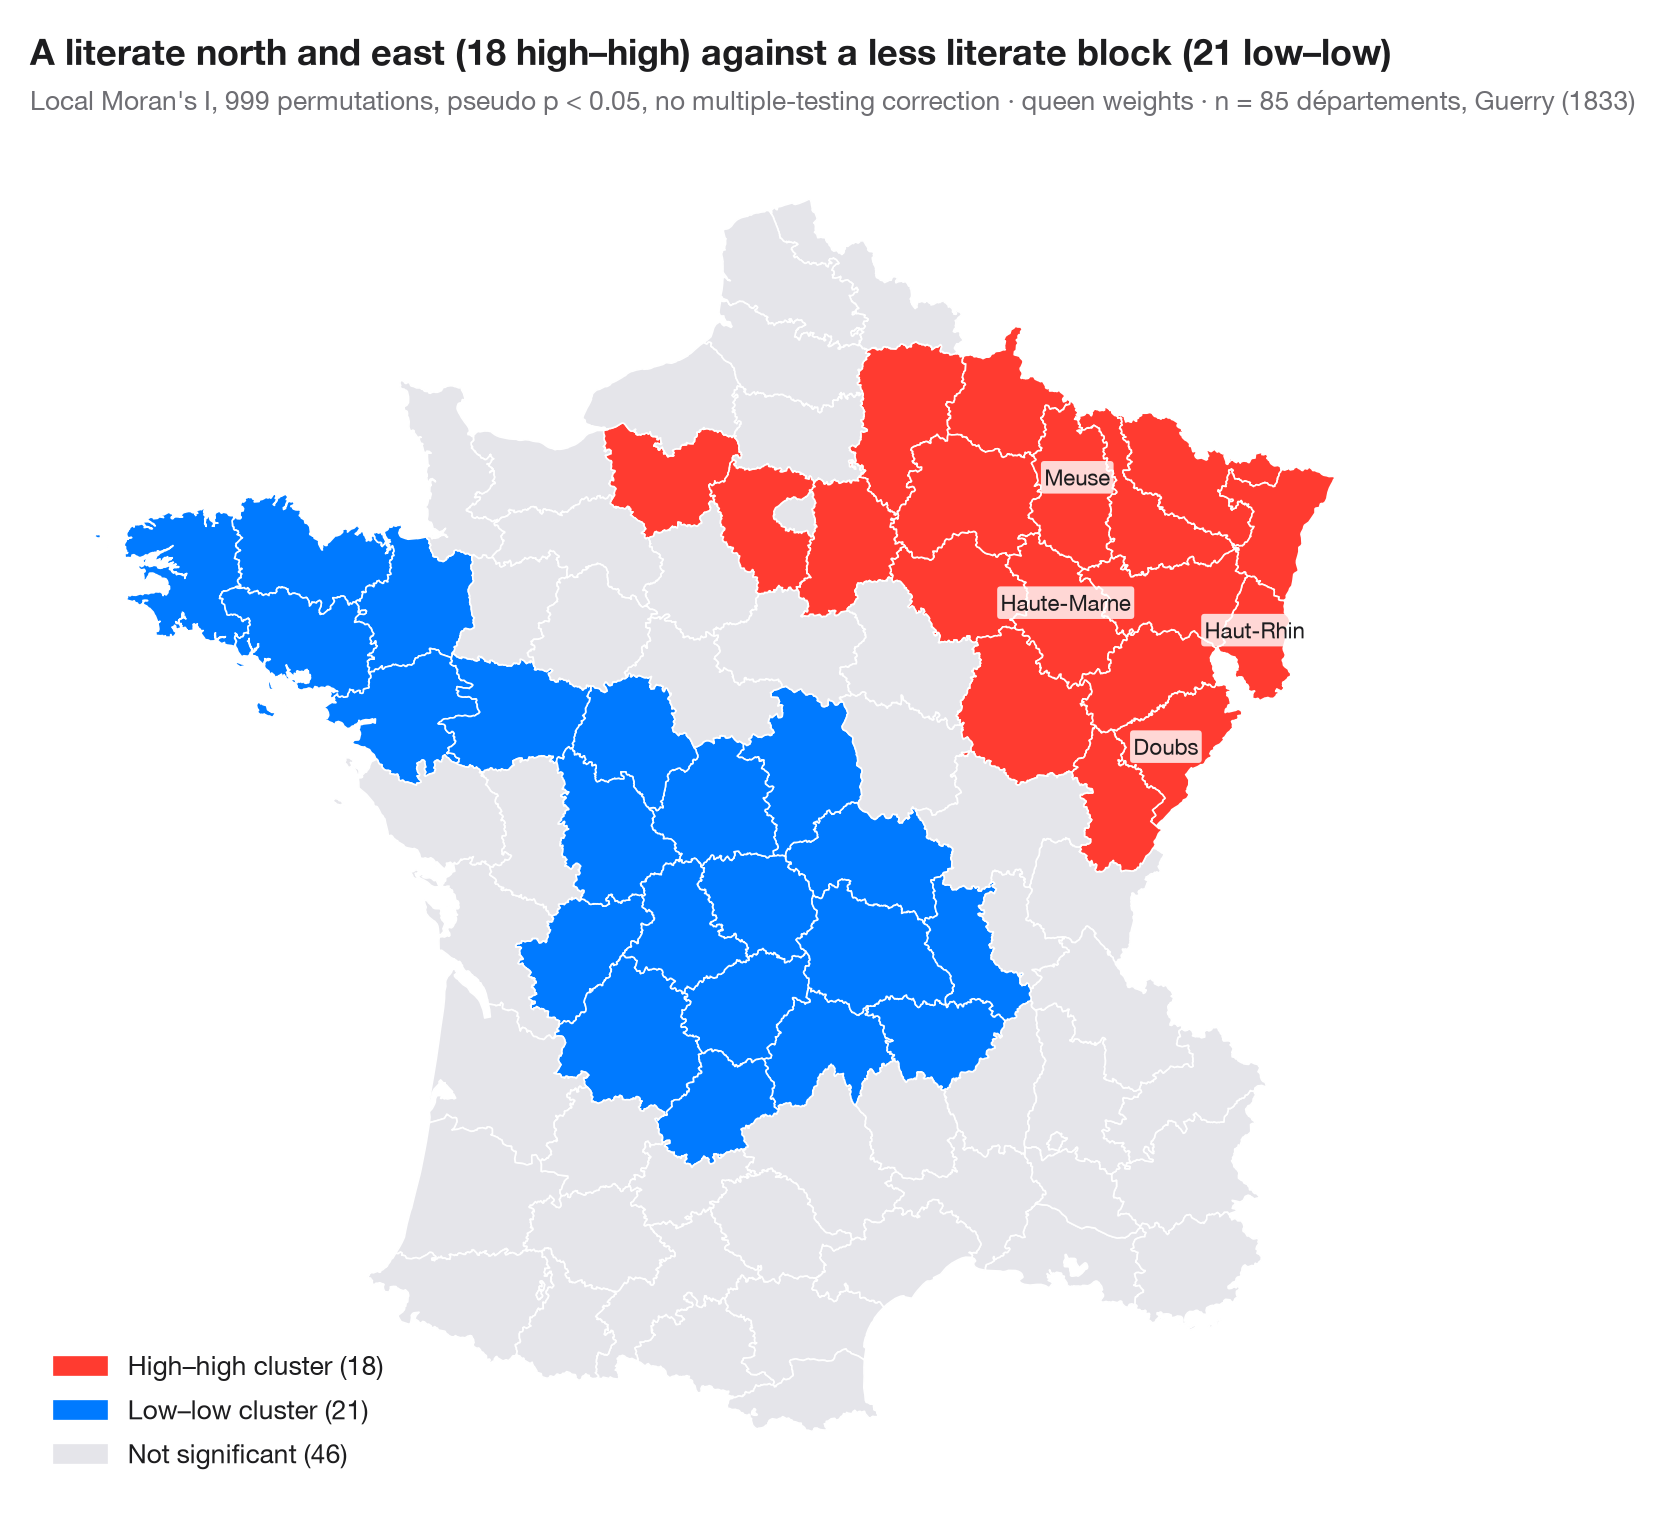
Une statistique globale dit si une carte est regroupée ; un indicateur local d'association spatiale (LISA ; Anselin, 1995) dit où. Le I de Moran local se calcule pour chaque zone à partir de sa propre valeur et de celles de ses voisines. Les zones dont la statistique locale est significative (pseudo p < 0,05, 999 permutations conditionnelles) sont colorées selon leur quadrant du diagramme de Moran : regroupements haut–haut et bas–bas, valeurs atypiques haut–bas ou bas–haut. Tout le reste est en gris.
Deux précautions accompagnent toute carte LISA. Les 85 tests ne sont pas indépendants et ne sont pas corrigés pour les comparaisons multiples : quelques zones significatives sont attendues par le seul hasard. Et une zone significative marque le cœur d'un regroupement, qui s'étend généralement à ses voisines. Les données sont les taux d'alphabétisation de Guerry (1833) pour 85 départements, chargés avec libpysal ; la statistique vient de esda.Moran_Local et la carte de GeoPandas.
Le code et le texte à l'intérieur des figures sont en anglais.
import geopandas as gpd
import matplotlib.pyplot as plt
import numpy as np
from esda.moran import Moran_Local
from libpysal import examples, weights
from matplotlib.patches import Patch

# Data: literacy of military conscripts in 85 départements, c. 1830 (Guerry, 1833)
g = gpd.read_file(examples.load_example("Guerry").get_path("guerry.shp"))
y = g["Litercy"].to_numpy(dtype=float)

w = weights.Queen.from_dataframe(g, use_index=False)
w.transform = "r"
lisa = Moran_Local(y, w, permutations=999, seed=1)

# Quadrants: 1 high–high, 2 low–high, 3 low–low, 4 high–low; grey if not significant
labels = {1: "High–high cluster", 3: "Low–low cluster", 2: "Low–high outlier", 4: "High–low outlier"}
colors = {1: "#FF3B30", 3: "#007AFF", 2: "#9FCBFF", 4: "#FFA8A2"}
sig = lisa.p_sim < 0.05
g["cluster"] = np.where(sig, lisa.q, 0)
counts = {k: int((g["cluster"] == k).sum()) for k in labels}

fig, ax = plt.subplots(figsize=(8, 7.4))
g.plot(color=[colors.get(c, "#E5E5EA") for c in g["cluster"]], edgecolor="white", linewidth=0.6, ax=ax)
handles = [Patch(color=colors[k], label=f"{labels[k]} ({counts[k]})") for k in labels if counts[k]]
handles.append(Patch(color="#E5E5EA", label=f"Not significant ({int((~sig).sum())})"))
ax.legend(handles=handles, loc="lower left", fontsize=9.5)
ax.set_axis_off()

# Name the strongest cluster cores
for _, r in g.assign(p=lisa.p_sim, Is=lisa.Is)[sig].nlargest(4, "Is").iterrows():
    c = r.geometry.representative_point()
    ax.annotate(r["Dprtmnt"], (c.x, c.y), fontsize=8, ha="center", color="#1D1D1F",
                bbox=dict(boxstyle="round,pad=0.15", fc="white", ec="none", alpha=0.8))

north = g.centroid.y[g["cluster"] == 1].mean() > g.centroid.y[g["cluster"] == 3].mean()
where = "north and east" if north else "south"
ax.set_title(f"A literate {where} ({counts[1]} high–high) against a less literate "
             f"block ({counts[3]} low–low)", pad=26)
ax.text(0, 1.02, f"Local Moran's I, 999 permutations, pseudo p < 0.05, no multiple-testing correction · "
        f"queen weights · n = {w.n} départements, Guerry (1833)",
        transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Guerry's moral statistics of France, c. 1830 (85 départements). Guerry, A.-M. (1833). Essai sur la statistique morale de la France. Crochard. Data as compiled in Friendly, M. (2007). A.-M. Guerry's moral statistics of France: Challenges for multivariable spatial analysis. Statistical Science, 22(3), 368–399. https://doi.org/10.1214/07-STS241
Prepared by the Center for Spatial Data Science (University of Chicago) from the R package Guerry (Friendly and Dray), provided “as is”. Fetched once and cached by libpysal (examples.load_example("Guerry")). Variables come from Guerry's tables as translated by Whitt and Reinking (2002).
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). LISA cluster map (local autocorrelation). In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/spatial-data/lisa-cluster-map/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Données spatiales
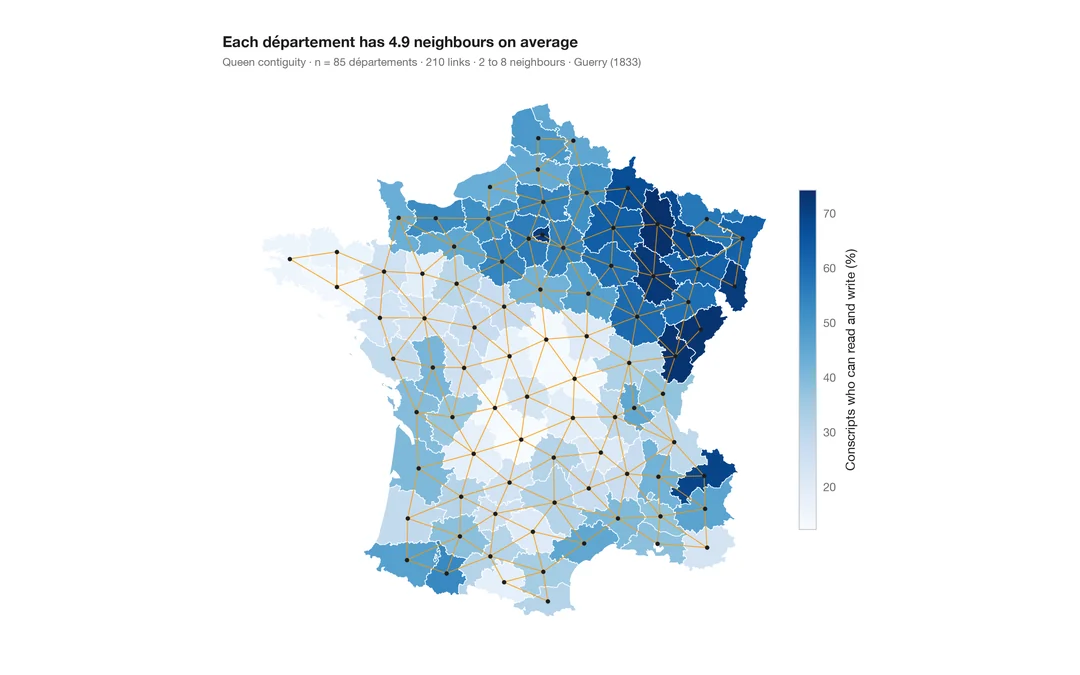
Carte choroplèthe avec pondérations spatiales
Une carte d'une variable avec, par-dessus, le réseau des voisins — la structure sur laquelle repose toute statistique spatiale.
spdep::poly2nb() + plot(nb, coords)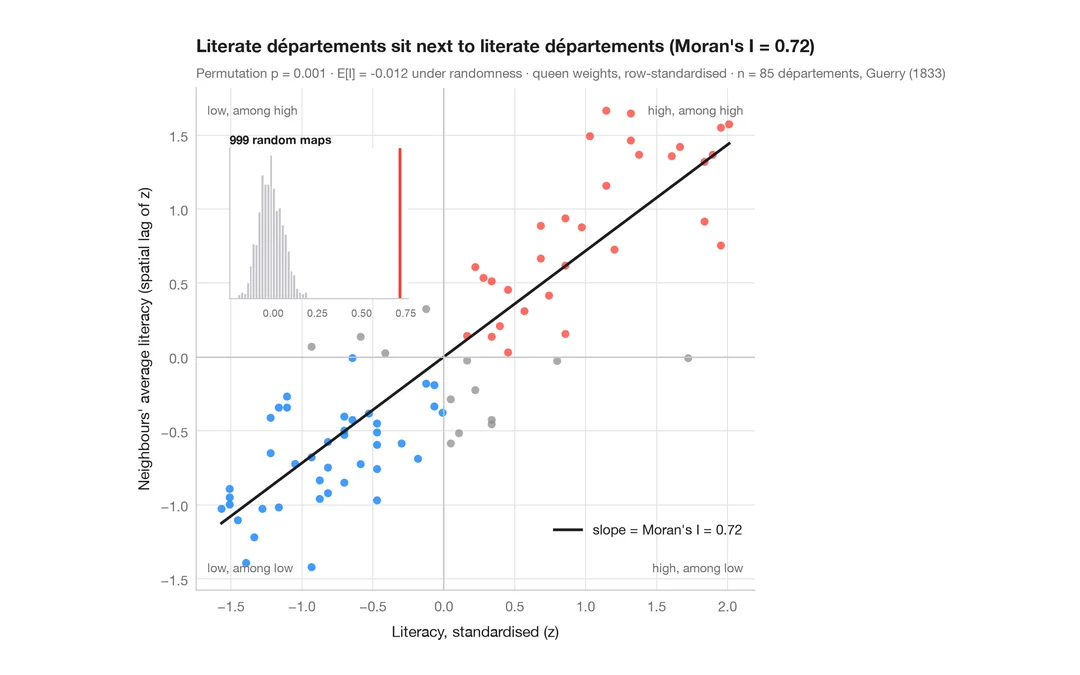
Diagramme de Moran (autocorrélation globale)
Chaque zone face à la moyenne de ses voisines, avec le I de Moran, son test par permutation et la distribution de référence.
spdep::moran.plot() + spdep::moran.mc()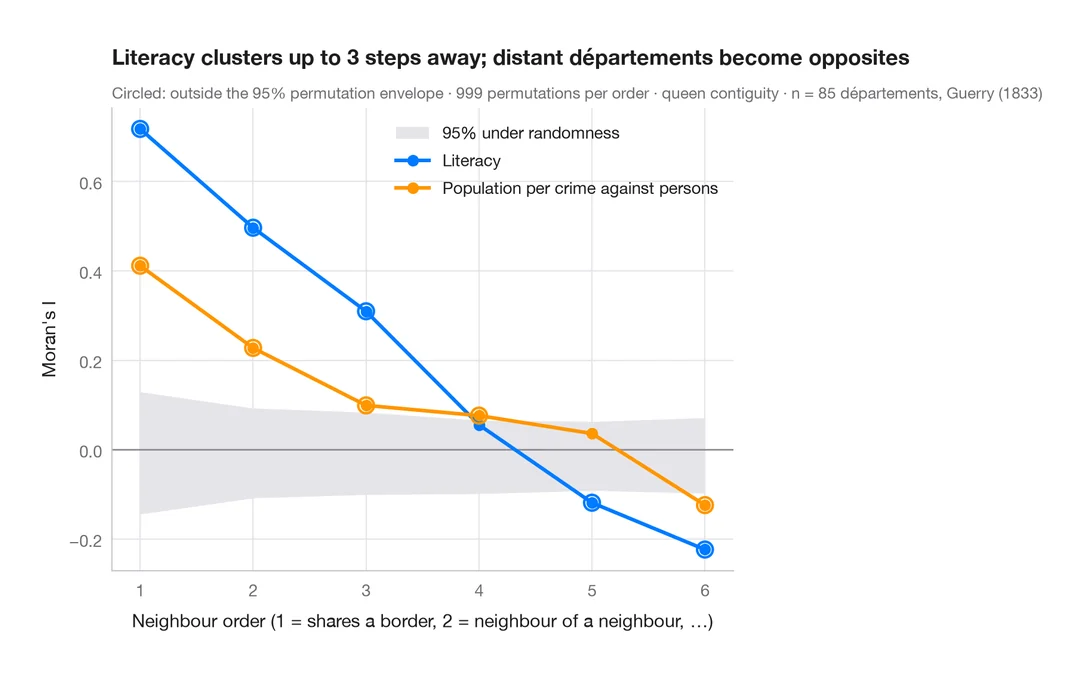
Corrélogramme spatial
Le I de Moran à des ordres de voisinage croissants, avec une enveloppe de permutation — jusqu'où porte le regroupement spatial.
spdep::sp.correlogram(method = "I")