Diagramme des valeurs propres
Combien de dimensions décrivent 303 districts scolaires californiens ? Variance par composante et seuil de l'analyse parallèle.
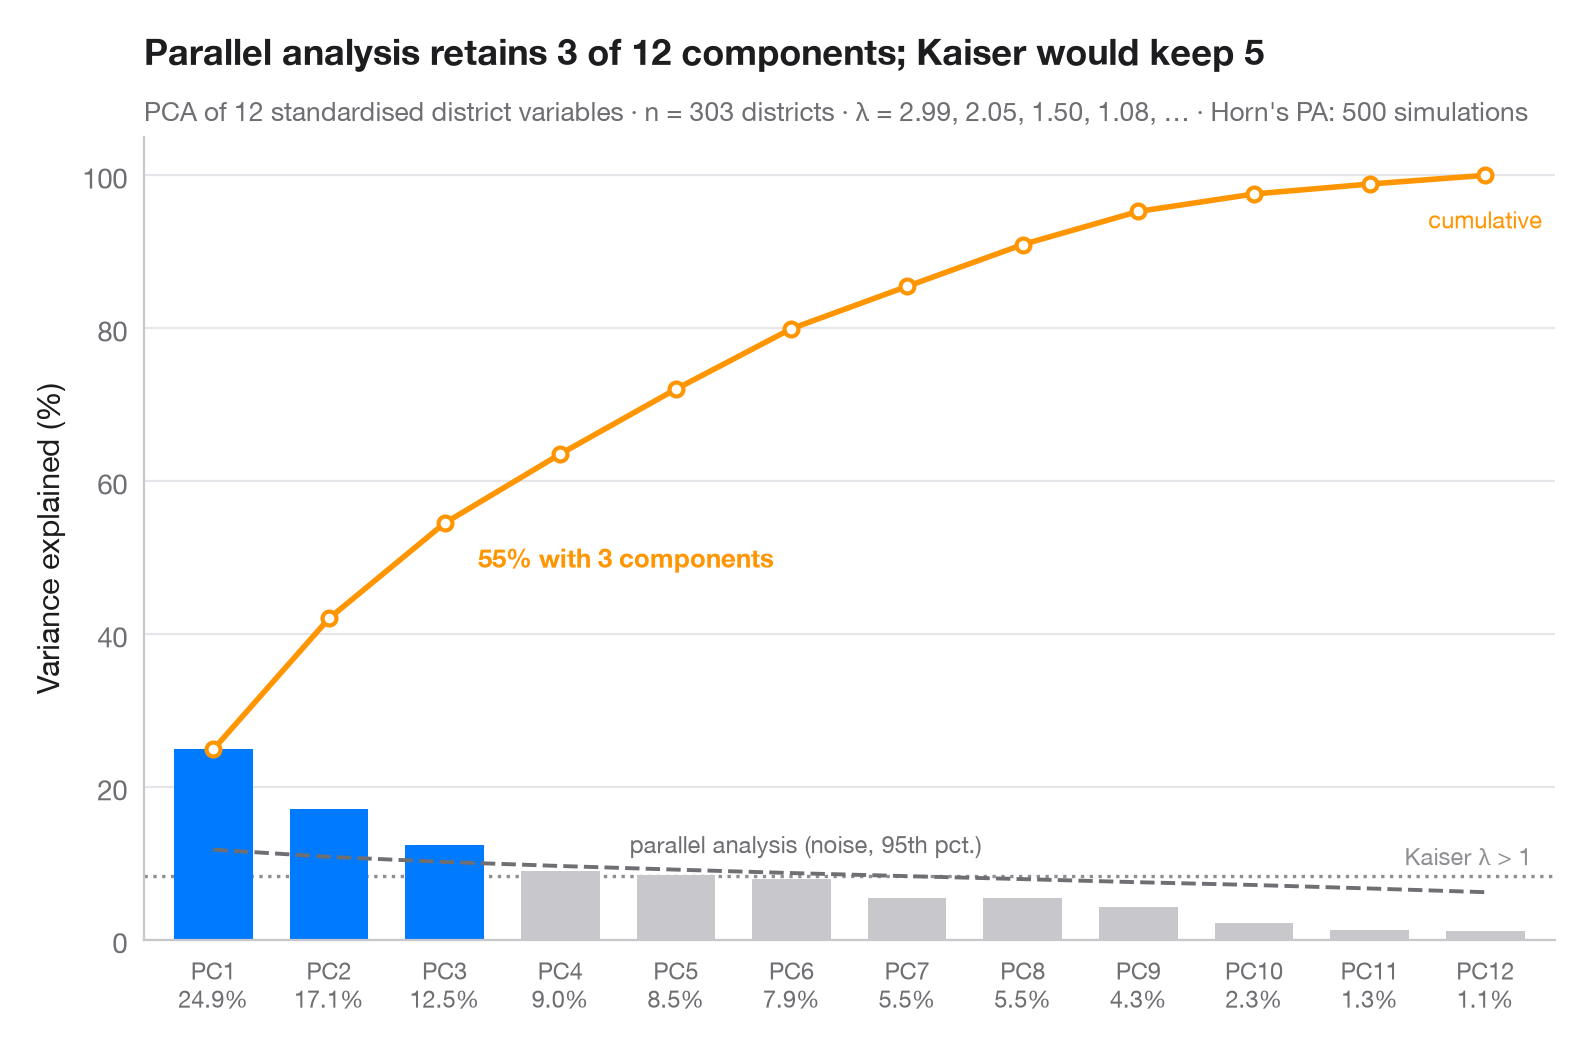
Combien de composantes principales vaut-il la peine de conserver ? Les barres montrent la part de variance portée par chaque composante, la ligne orange le cumul. La ligne grise en tirets correspond à l'analyse parallèle de Horn : le 95e centile des mêmes valeurs propres calculées sur des données aléatoires non corrélées de même taille. Une composante n'est retenue (en bleu) que si elle dépasse ce plancher de bruit ; la ligne pointillée indique l'ancienne règle de Kaiser (valeur propre > 1).
Les données sont 303 districts scolaires californiens du jeu de données star98 de statsmodels (programme Standardized Testing and Reporting de 1998) : 12 caractéristiques par district — % d'élèves de familles à faible revenu, % d'élèves asiatiques, noirs et hispaniques, % d'enseignants issus de minorités, ancienneté et salaire moyens des enseignants, dépense par élève, nombre d'élèves par enseignant, % suivant des cours préparatoires à l'université, % d'écoles à charte et % d'écoles à calendrier annuel —, chacune standardisée. Les valeurs propres de la matrice de corrélation (les variances de l'ACP) proviennent de numpy.linalg.eigvalsh ; l'analyse parallèle repose sur 500 simulations à graine fixe. Notez qu'ici l'analyse parallèle retient moins de composantes que la règle de Kaiser.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from sklearn.preprocessing import StandardScaler

# PCA on 12 standardised characteristics of California school districts
X = StandardScaler().fit_transform(sm.datasets.star98.load_pandas().data.loc[:, "LOWINC":"PCTYRRND"])
n, p = X.shape
eig = np.sort(np.linalg.eigvalsh(np.corrcoef(X.T)))[::-1]  # PCA eigenvalues
pct = 100 * eig / eig.sum()

# Horn's parallel analysis: eigenvalues of pure noise, 95th percentile
rng = np.random.default_rng(42)
sims = [np.sort(np.linalg.eigvalsh(np.corrcoef(rng.normal(size=(n, p)).T)))[::-1]
        for _ in range(500)]
pa = np.percentile(sims, 95, axis=0)
keep = eig > pa
k = np.arange(1, p + 1)

fig, ax = plt.subplots(figsize=(8, 5))
ax.bar(k, pct, width=0.68, color=np.where(keep, "#007AFF", "#C7C7CC"), zorder=2)

# Cumulative share, parallel-analysis floor and Kaiser threshold (all in % of variance)
cum = np.cumsum(pct)
ax.plot(k, cum, color="#FF9500", marker="o", ms=5, mfc="white", mew=1.5, zorder=3)
ax.annotate(f"{cum[keep.sum() - 1]:.0f}% with {keep.sum()} components",
            (keep.sum(), cum[keep.sum() - 1]), xytext=(12, -16), textcoords="offset points",
            fontsize=9.5, color="#FF9500", fontweight="semibold")
ax.text(p, cum[-1] - 4, "cumulative", fontsize=8.5, color="#FF9500", ha="center", va="top")
ax.plot(k, 100 * pa / p, color="#6E6E73", ls="--", lw=1.4, zorder=3)
ax.text(4.6, 100 * pa[4] / p + 1.5, "parallel analysis (noise, 95th pct.)", fontsize=8.5,
        color="#6E6E73", va="bottom")
ax.axhline(100 / p, color="#8E8E93", ls=":", lw=1.2, zorder=1)
ax.text(p + 0.4, 100 / p + 0.8, "Kaiser λ > 1", fontsize=8.5, color="#8E8E93", ha="right", va="bottom")

ax.set_xticks(k, [f"PC{i}\n{v:.1f}%" for i, v in zip(k, pct)], fontsize=8.5)
ax.set_xlim(0.4, p + 0.6)
ax.set_ylim(0, 105)
ax.set_ylabel("Variance explained (%)")
ax.set_title(f"Parallel analysis retains {keep.sum()} of {p} components; Kaiser would keep "
             f"{(eig > 1).sum()}", pad=26)
ax.text(0, 1.02, f"PCA of {p} standardised district variables · n = {n} districts · λ = "
        f"{', '.join(f'{e:.2f}' for e in eig[:4])}, … · Horn's PA: 500 simulations",
        transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- California STAR test results, 1998 (303 school districts). Gill, J. (2001). Generalized Linear Models: A Unified Approach (Quantitative Applications in the Social Sciences, No. 134). Sage. https://www.statsmodels.org/stable/datasets/generated/star98.html
Original data from the California Department of Education's Standardized Testing and Reporting (STAR) program, 1998. Subset distributed with statsmodels (sm.datasets.star98) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Scree plot. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/multivariate/scree-plot/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Multivarié et classification
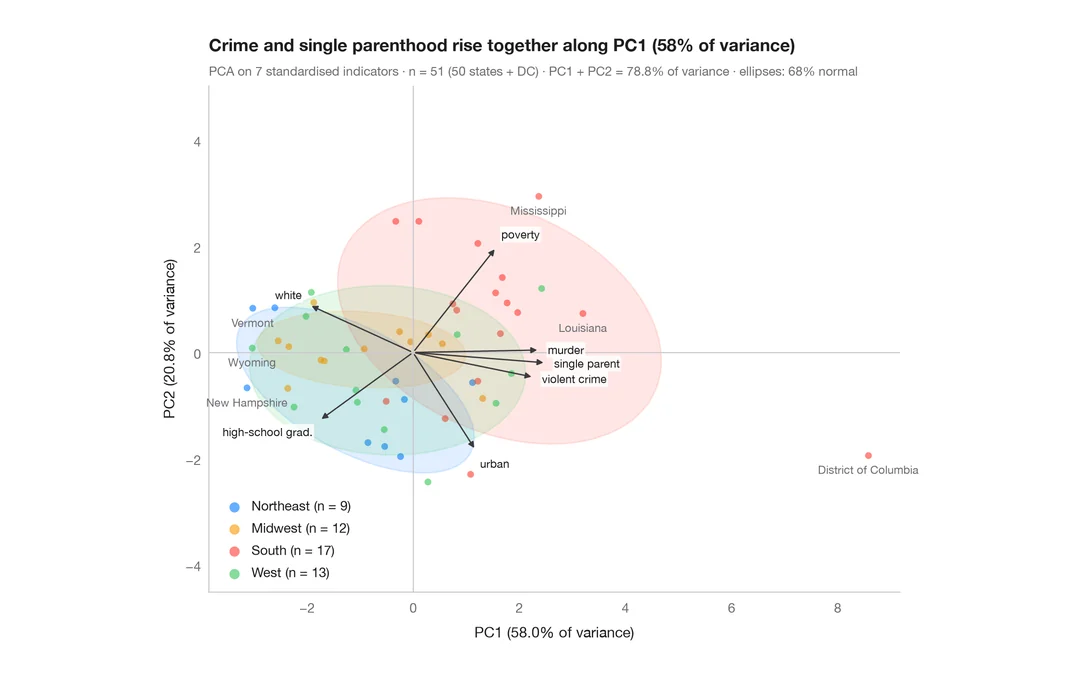
Biplot d'ACP
Les États américains et leurs indicateurs sociaux sur les deux premières composantes principales.
factoextra::fviz_pca_biplot()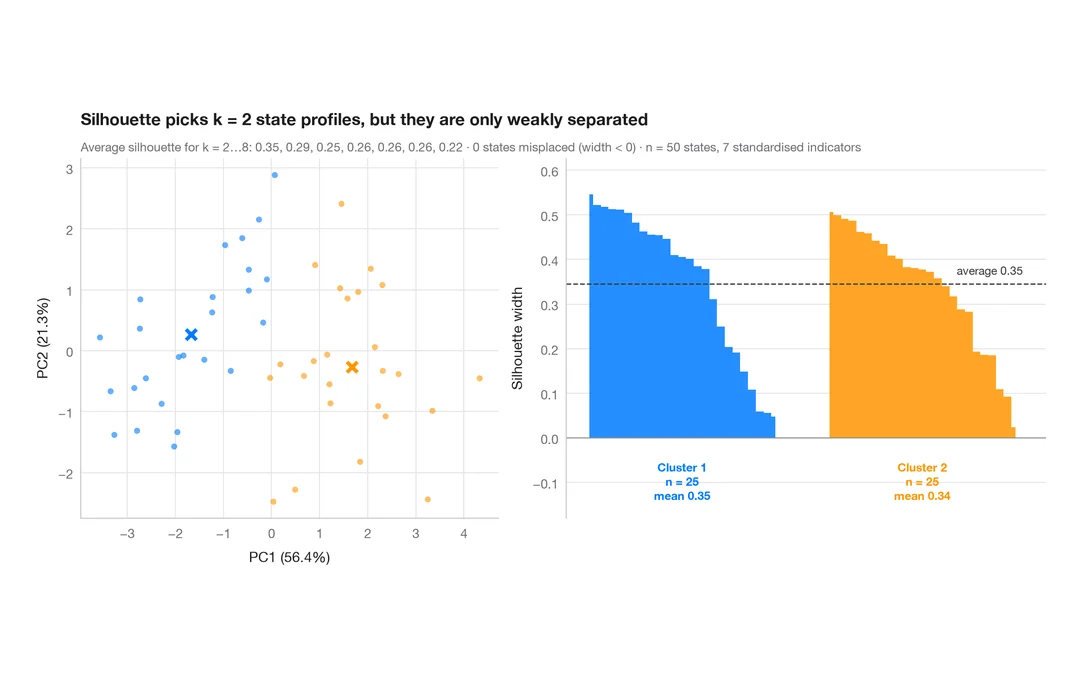
Graphique de silhouette pour les k-moyennes
Les États américains forment-ils des profils sociaux distincts ? Groupes des k-moyennes et largeurs de silhouette.
factoextra::fviz_silhouette()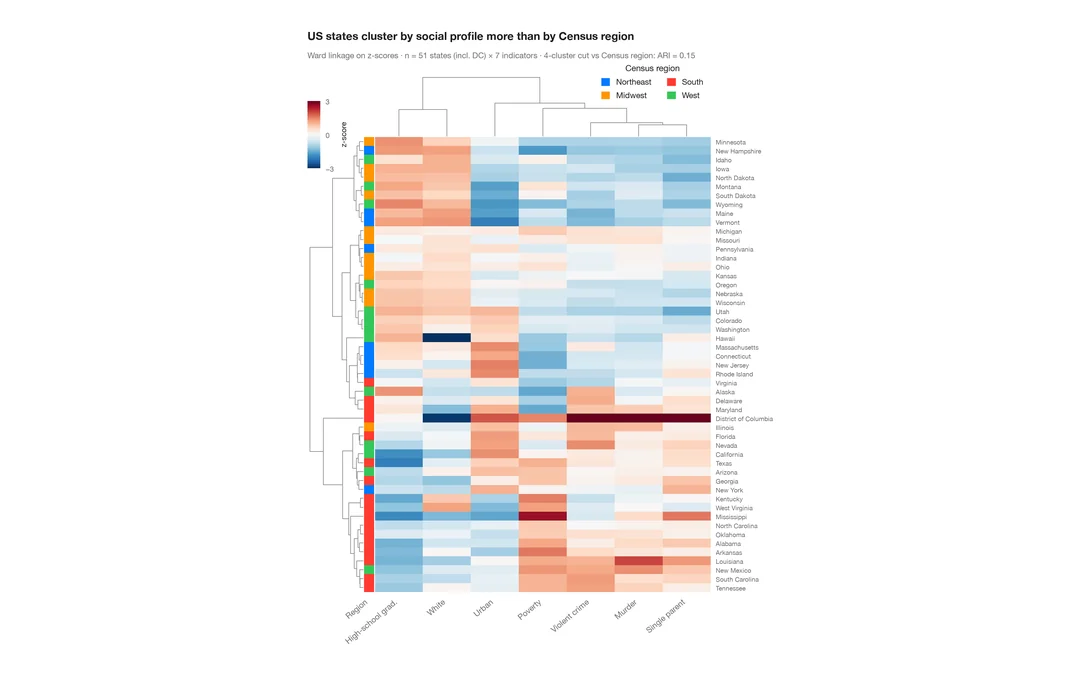
Carte de chaleur avec classification
Carte de chaleur des indicateurs sociaux des États américains en scores z, avec dendrogrammes des lignes et des colonnes et barre de couleur par région du recensement.
pheatmap::pheatmap() / ComplexHeatmap::Heatmap()