Carte de chaleur avec classification
Carte de chaleur des indicateurs sociaux des États américains en scores z, avec dendrogrammes des lignes et des colonnes et barre de couleur par région du recensement.
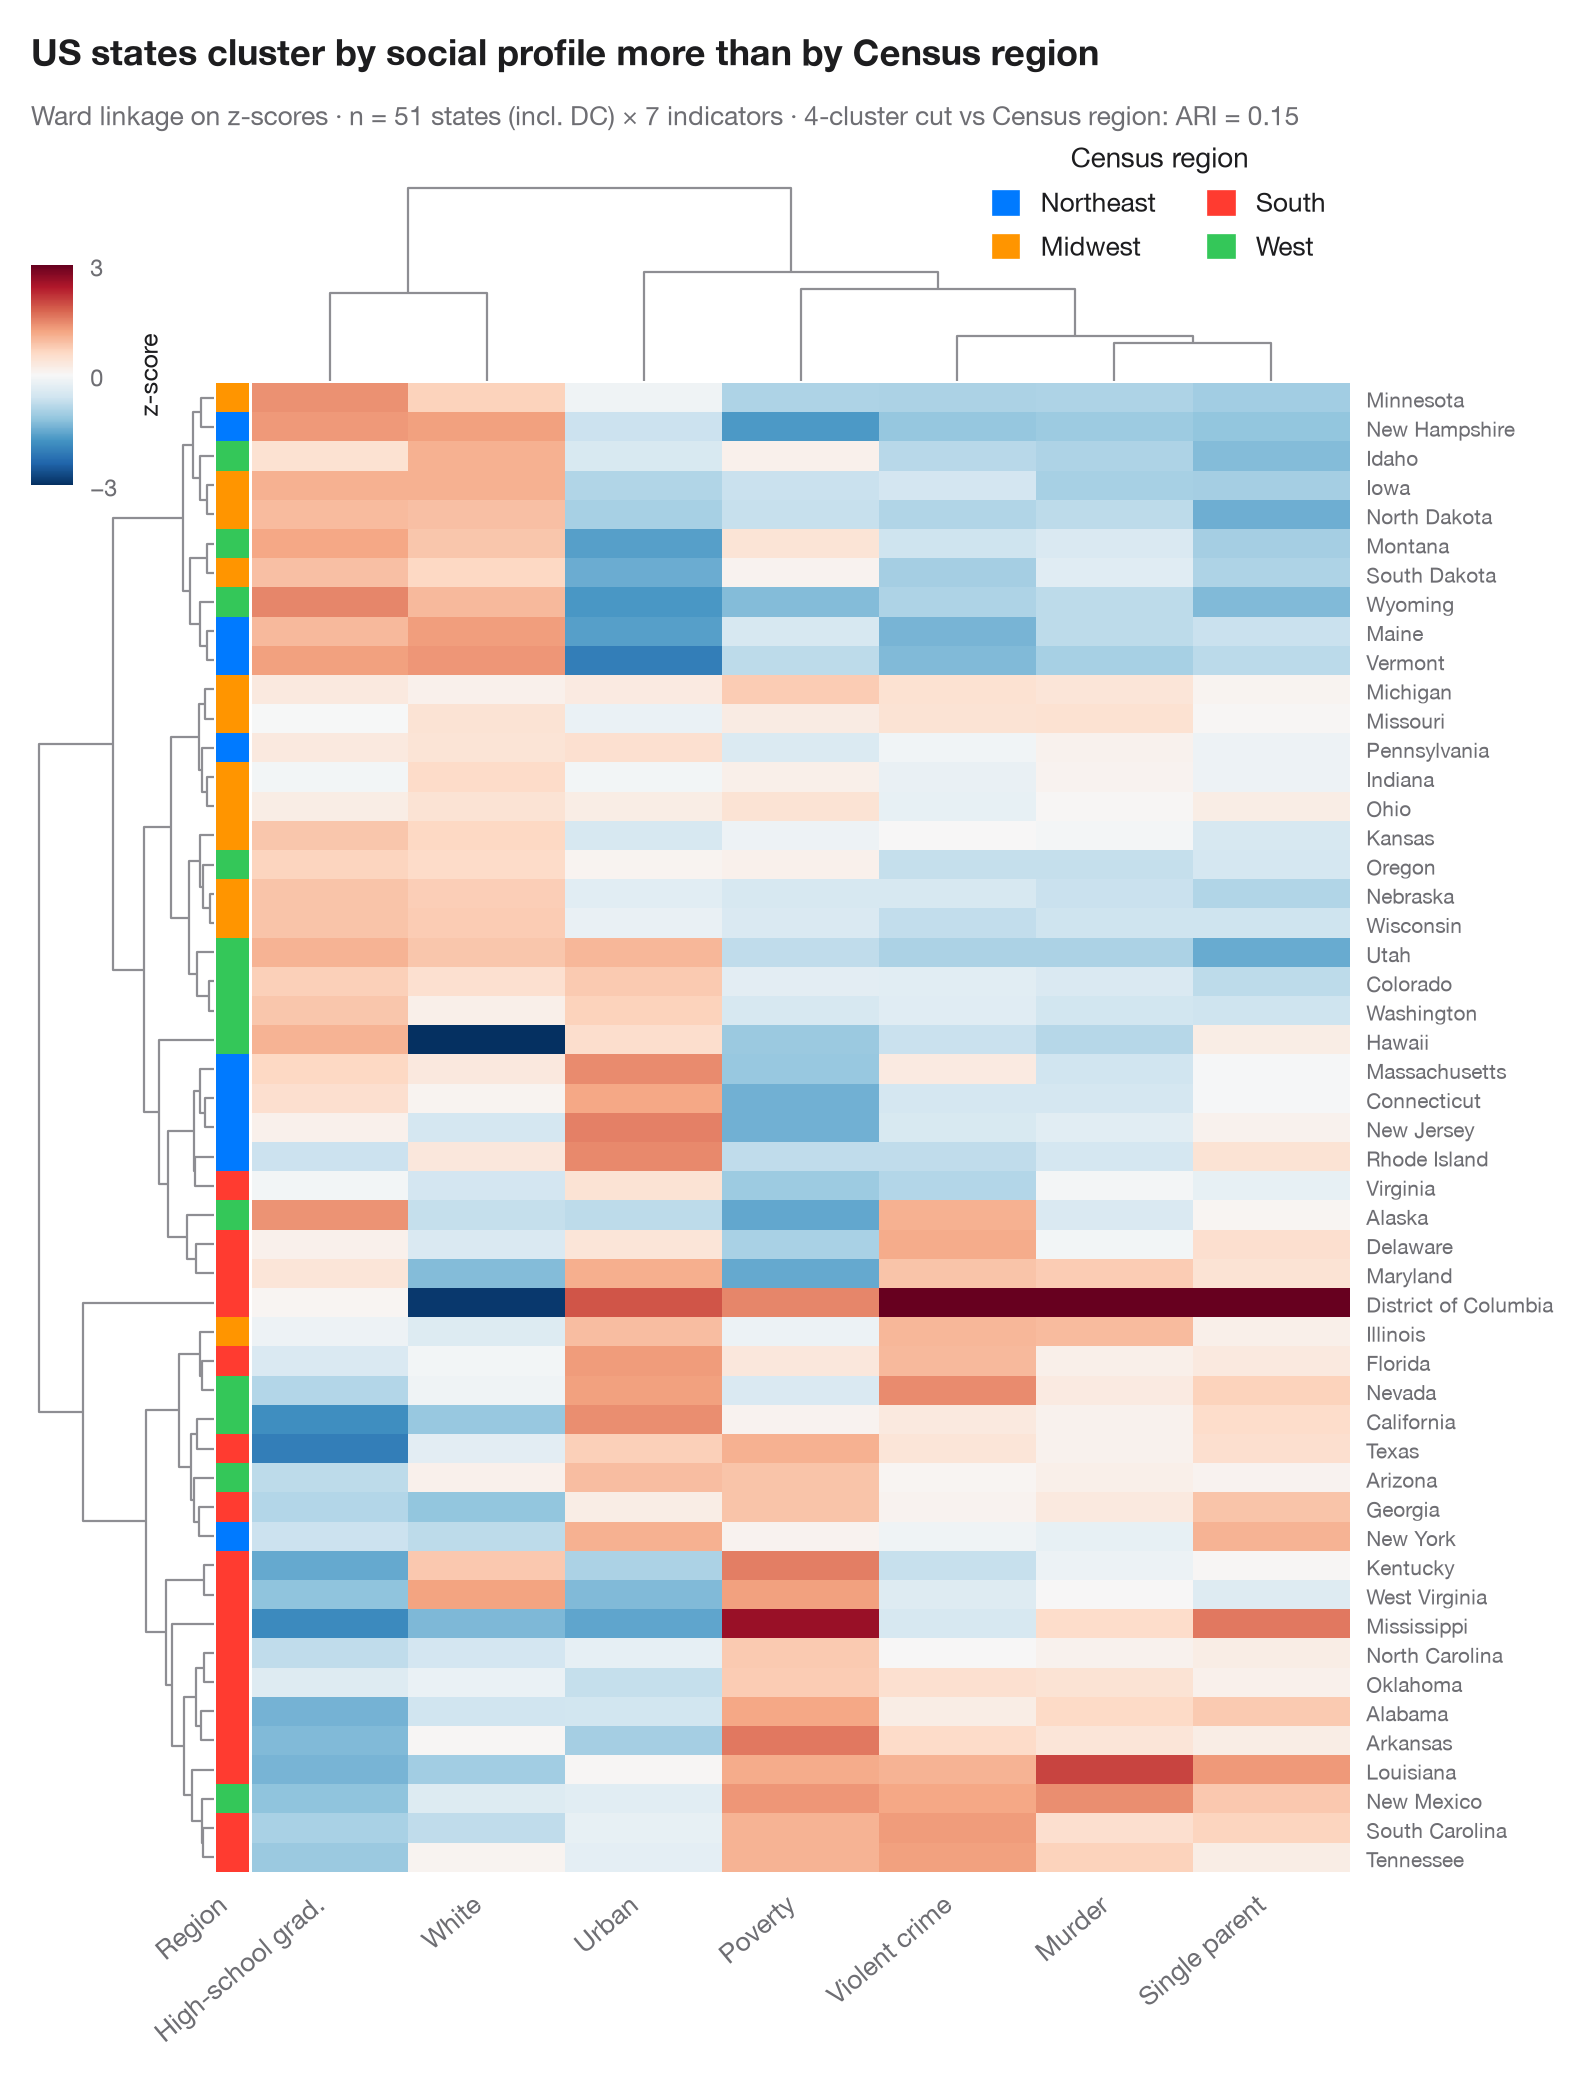
Chaque ligne est une observation, chaque colonne une variable, et chaque cellule son score z (bleu sous la moyenne de la variable, rouge au-dessus). Lignes et colonnes sont réordonnées par classification hiérarchique (agrégation de Ward sur la distance euclidienne), et les dendrogrammes montrent l'historique des fusions. La barre de couleur à gauche indique le groupe connu de chaque ligne : on voit d'un coup d'œil si l'arbre non supervisé le retrouve — et quelles variables pilotent la séparation.
Les données sont les 50 États américains et le district de Columbia du jeu de données statecrime de statsmodels (chiffres de 2009) : taux de crimes violents et d'homicides pour 100 000 habitants, % de diplômés du secondaire, % en situation de pauvreté, % de ménages monoparentaux, % de population blanche et % de population urbaine. La barre de couleur indique la région du Bureau du recensement. seaborn.clustermap effectue la classification et le tracé ; scipy.cluster.hierarchy coupe l'arbre des lignes en quatre groupes pour calculer l'indice de Rand ajusté par rapport aux quatre régions : la géographie n'explique qu'en partie quels États se ressemblent.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
from matplotlib.patches import Patch
from scipy.cluster.hierarchy import fcluster
import statsmodels.api as sm
from sklearn.metrics import adjusted_rand_score

# Data: 7 social indicators of 51 US states (incl. DC), z-scored per column;
# US Census region as row annotation
df = sm.datasets.statecrime.load_pandas().data
df.index = df.index.str.strip()
Z = (df - df.mean()) / df.std()
Z.columns = ["Violent crime", "Murder", "High-school grad.", "Poverty", "Single parent",
             "White", "Urban"]
regions = {"Northeast": ["Connecticut", "Maine", "Massachusetts", "New Hampshire", "New Jersey",
                         "New York", "Pennsylvania", "Rhode Island", "Vermont"],
           "Midwest": ["Illinois", "Indiana", "Iowa", "Kansas", "Michigan", "Minnesota", "Missouri",
                       "Nebraska", "North Dakota", "Ohio", "South Dakota", "Wisconsin"],
           "West": ["Alaska", "Arizona", "California", "Colorado", "Hawaii", "Idaho", "Montana",
                    "Nevada", "New Mexico", "Oregon", "Utah", "Washington", "Wyoming"]}
region = pd.Series([next((r for r, s in regions.items() if st in s), "South") for st in Z.index],
                   index=Z.index, name="Region")
palette = dict(zip(["Northeast", "Midwest", "South", "West"],
                   ["#007AFF", "#FF9500", "#FF3B30", "#34C759"]))

with plt.rc_context({"figure.constrained_layout.use": False}):
    g = sns.clustermap(Z, method="ward", metric="euclidean", cmap="RdBu_r", center=0,
                       vmin=-3, vmax=3, row_colors=region.map(palette), yticklabels=True,
                       figsize=(8.5, 10), dendrogram_ratio=(0.14, 0.12), colors_ratio=0.025,
                       cbar_pos=(0.02, 0.83, 0.025, 0.11),
                       cbar_kws=dict(label="z-score", ticks=[-3, 0, 3]),
                       tree_kws=dict(colors="#8E8E93", linewidths=0.8))

# How well does the row tree, cut into four clusters, recover the Census regions?
ari = adjusted_rand_score(region, fcluster(g.dendrogram_row.linkage, 4, "maxclust"))

g.ax_heatmap.set_xticklabels(g.ax_heatmap.get_xticklabels(), rotation=40, ha="right", fontsize=9.5)
g.ax_heatmap.set(xlabel="", ylabel="")
g.ax_heatmap.tick_params(axis="y", length=0, labelsize=7.5)
g.ax_heatmap.tick_params(axis="x", length=0)
g.ax_row_colors.set_xticklabels(["Region"], rotation=40, ha="right", fontsize=9.5)
g.ax_row_colors.tick_params(axis="x", length=0)
g.ax_cbar.tick_params(labelsize=8.5)
g.ax_cbar.yaxis.label.set_size(9)
g.ax_col_dendrogram.legend(handles=[Patch(color=c, label=n) for n, c in palette.items()],
                           loc="upper right", bbox_to_anchor=(1.0, 1.3), fontsize=9.5, ncol=2,
                           title="Census region", frameon=False, handlelength=1, handleheight=1)

g.figure.text(0.02, 1.04, "US states cluster by social profile more than by Census region",
              fontsize=13, fontweight="semibold", color="#1D1D1F")
g.figure.text(0.02, 1.01, f"Ward linkage on z-scores · n = {len(Z)} states (incl. DC) × {Z.shape[1]} "
              f"indicators · 4-cluster cut vs Census region: ARI = {ari:.2f}",
              fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- US state crime and social indicators, 2009. U.S. Census Bureau. Statistical Abstract of the United States, state tables for 2009 (crime rates from the FBI Uniform Crime Reporting program). https://www.statsmodels.org/stable/datasets/generated/statecrime.html
Compiled for statsmodels (sm.datasets.statecrime); public domain. See the statsmodels page for each variable's table and footnotes.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Clustered heatmap. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/multivariate/clustered-heatmap/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Multivarié et classification
Biplot d'ACP
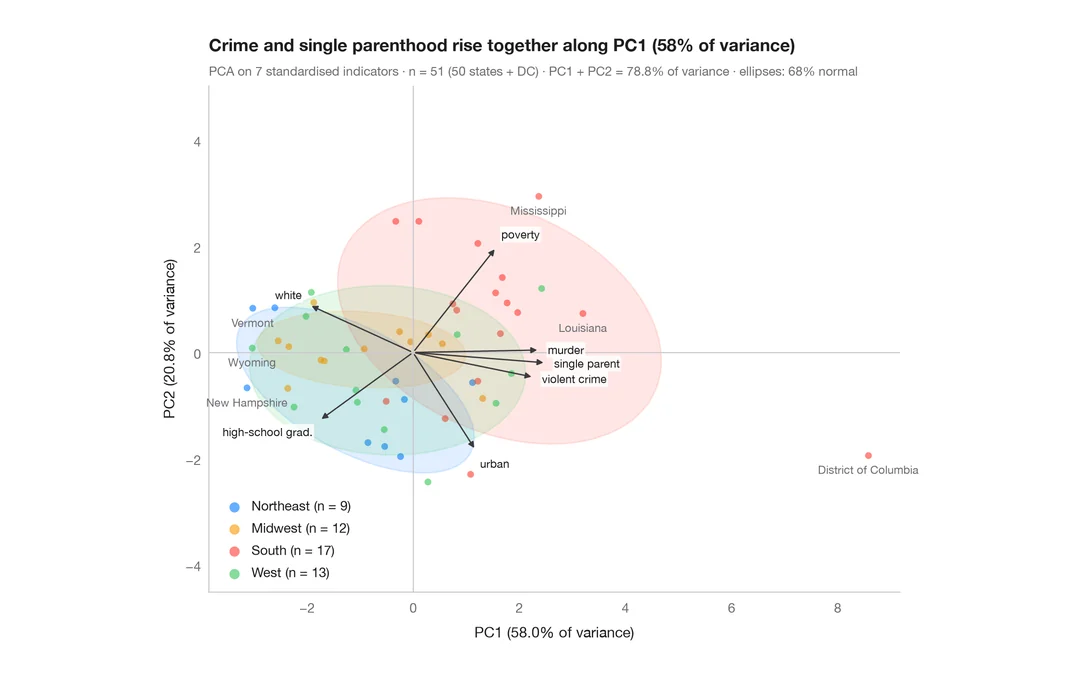
Les États américains et leurs indicateurs sociaux sur les deux premières composantes principales.
factoextra::fviz_pca_biplot()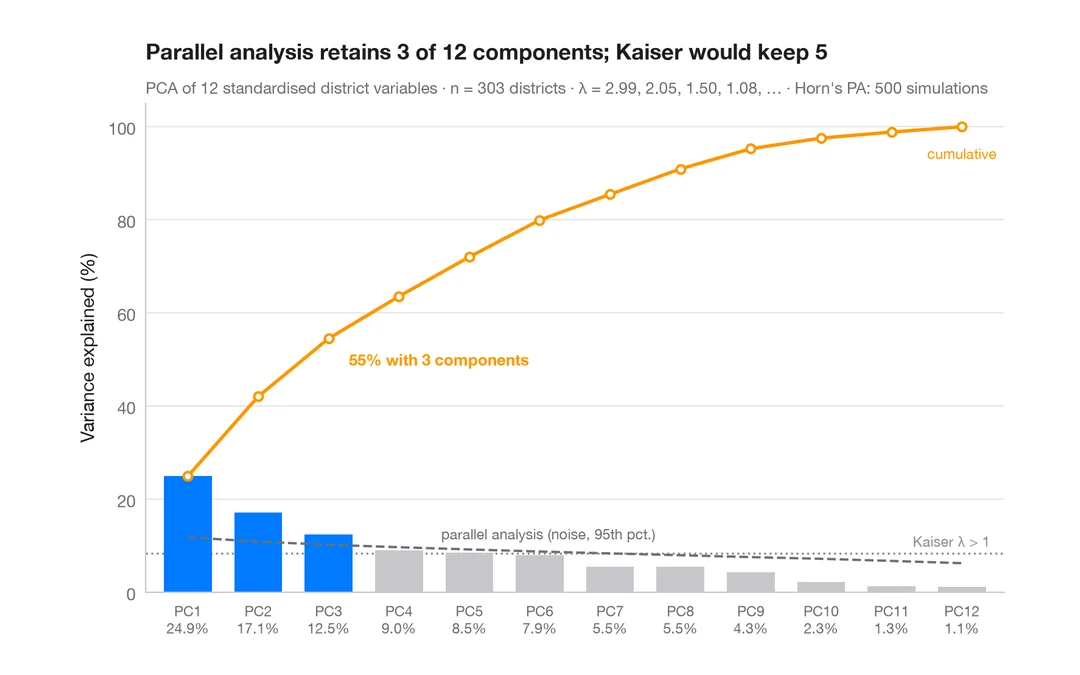
Diagramme des valeurs propres
Combien de dimensions décrivent 303 districts scolaires californiens ? Variance par composante et seuil de l'analyse parallèle.
factoextra::fviz_eig()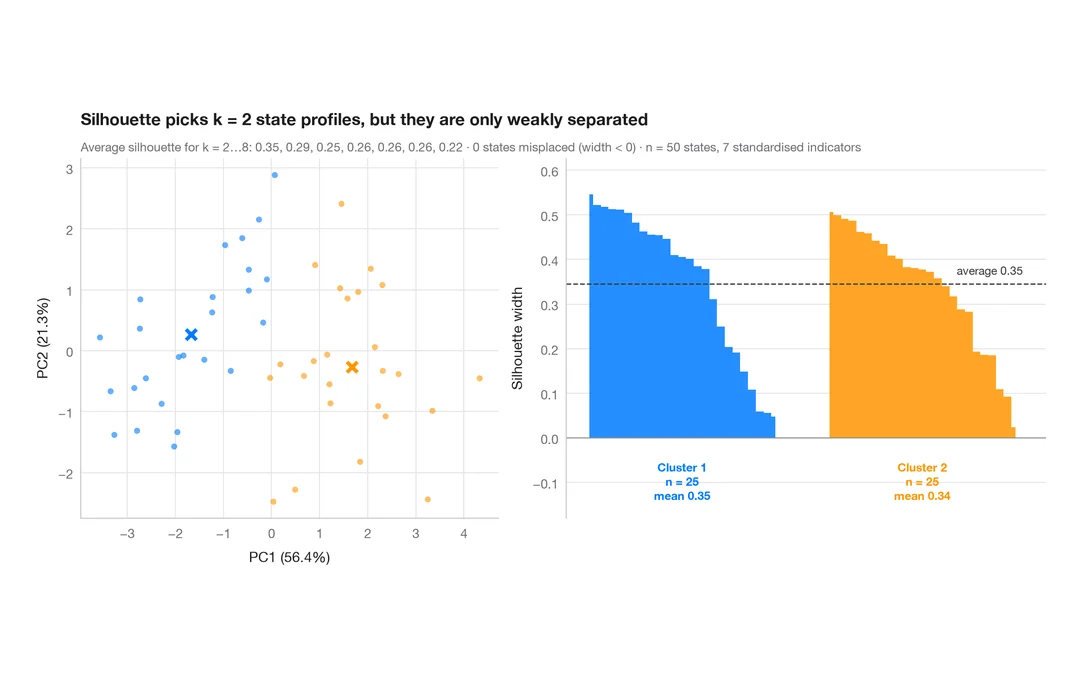
Graphique de silhouette pour les k-moyennes
Les États américains forment-ils des profils sociaux distincts ? Groupes des k-moyennes et largeurs de silhouette.
factoextra::fviz_silhouette()