Graphique de silhouette pour les k-moyennes
Les États américains forment-ils des profils sociaux distincts ? Groupes des k-moyennes et largeurs de silhouette.
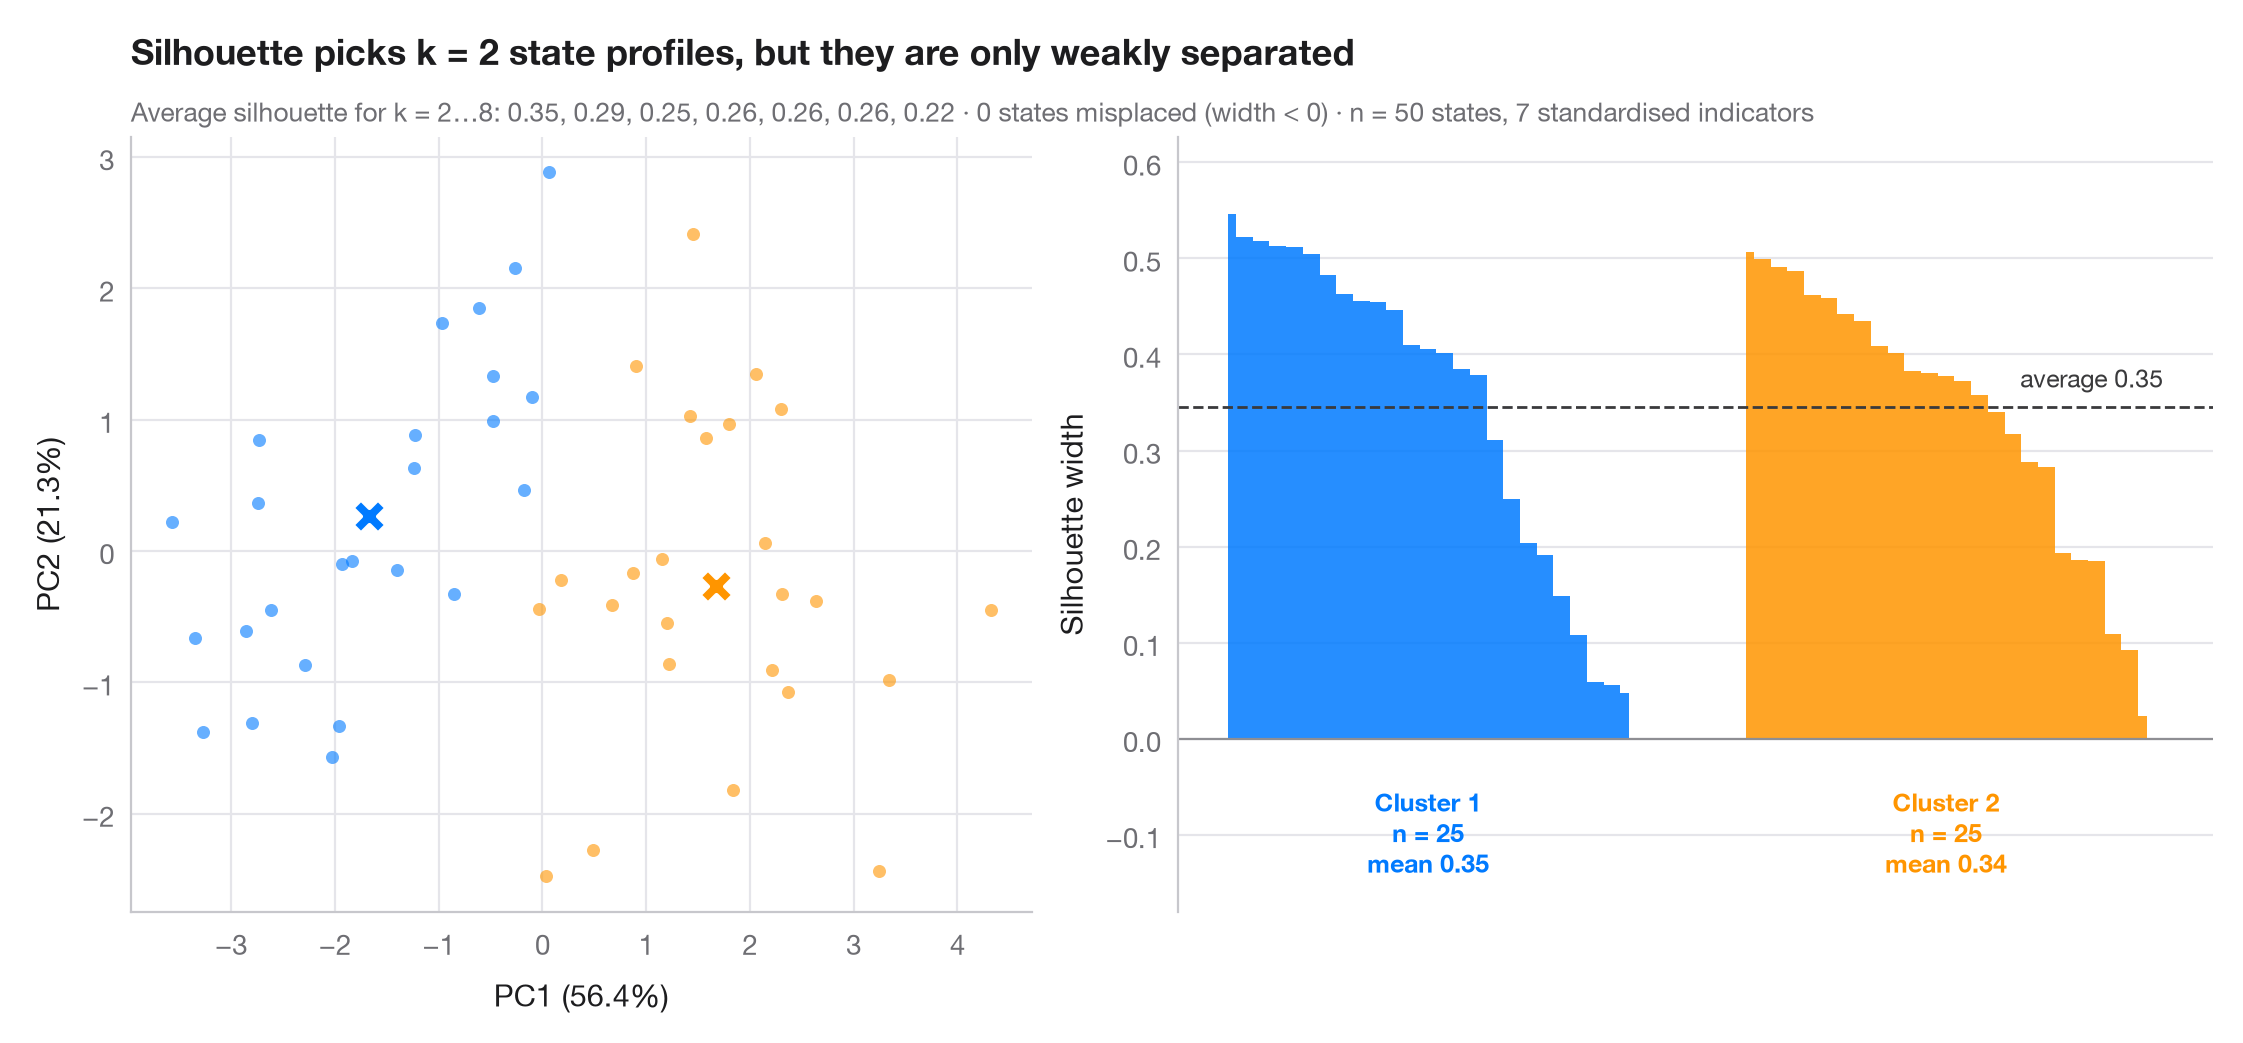
La largeur de silhouette compare la proximité de chaque observation avec son propre groupe et avec le groupe voisin le plus proche : proche de 1, l'observation est bien placée ; proche de 0, elle est à la frontière ; négative, elle est probablement mal affectée. Le nombre de groupes k retenu est celui qui maximise la silhouette moyenne (de 2 à 8). Le panneau de gauche montre les groupes sur les deux premières composantes principales ; celui de droite trie les largeurs de silhouette au sein de chaque groupe, la ligne en tirets marquant la moyenne générale.
Les données sont les 50 États américains du jeu de données statecrime de statsmodels (chiffres de 2009), décrits par 7 indicateurs standardisés : taux de crimes violents et d'homicides, % de diplômés du secondaire, % en situation de pauvreté, % de ménages monoparentaux, % de population blanche et % de population urbaine. Le district de Columbia est écarté : il est si extrême que les k-moyennes lui attribueraient un groupe à lui seul. Les deux groupes obtenus correspondent grosso modo à un profil à criminalité et pauvreté plus faibles et à un profil à criminalité et pauvreté plus élevées, mais une silhouette moyenne d'environ 0,35 traduit une structure faible selon la règle empirique de Kaufman et Rousseeuw (0,26–0,50) : les États forment un continuum plus que des types distincts. KMeans, silhouette_score et silhouette_samples de sklearn font le travail ; PCA ne sert qu'à représenter les groupes.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
from sklearn.metrics import silhouette_samples, silhouette_score
from sklearn.preprocessing import StandardScaler

# 7 social indicators of the 50 US states (DC, an extreme outlier, is left out)
df = sm.datasets.statecrime.load_pandas().data.drop("District of Columbia")
X = StandardScaler().fit_transform(df)

# Choose k by the average silhouette width
fits = {k: KMeans(k, n_init=20, random_state=1).fit(X) for k in range(2, 9)}
avg = {k: silhouette_score(X, m.labels_) for k, m in fits.items()}
k = max(avg, key=avg.get)
labels = fits[k].labels_
sil = silhouette_samples(X, labels)
colors = ["#007AFF", "#FF9500", "#34C759", "#FF3B30", "#AF52DE", "#5AC8FA", "#8E8E93", "#A2845E"]

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 5), width_ratios=[1, 1.15])

# Left: clusters projected on the first two principal components
pca = PCA(2).fit(X)
S, C = pca.transform(X), pca.transform(fits[k].cluster_centers_)
for j in range(k):
    ax1.scatter(*S[labels == j].T, s=22, color=colors[j], alpha=0.6, lw=0)
    ax1.scatter(*C[j], s=150, marker="X", color=colors[j], edgecolor="white", lw=1.5, zorder=3)
ax1.set_xlabel(f"PC1 ({100 * pca.explained_variance_ratio_[0]:.1f}%)")
ax1.set_ylabel(f"PC2 ({100 * pca.explained_variance_ratio_[1]:.1f}%)")
ax1.grid(axis="x")

# Right: silhouette widths, sorted within cluster
start = 0
for j in range(k):
    s = np.sort(sil[labels == j])[::-1]
    x = np.arange(start, start + len(s))
    ax2.fill_between(x, 0, s, color=colors[j], step="mid", lw=0, alpha=0.85)
    ax2.text(x.mean(), -0.05, f"Cluster {j + 1}\nn = {len(s)}\nmean {s.mean():.2f}",
             ha="center", va="top", fontsize=9, color=colors[j], fontweight="semibold")
    start += len(s) + 6
ax2.axhline(avg[k], color="#3A3A3C", ls="--", lw=1)
ax2.text(start - 6, avg[k] + 0.015, f"average {avg[k]:.2f}", ha="right", va="bottom",
         fontsize=9, color="#3A3A3C")
ax2.axhline(0, color="#8E8E93", lw=0.8)
ax2.set_xticks([])
ax2.set_xlim(-3, start - 3)
ax2.set_ylim(-0.18, max(sil) + 0.08)
ax2.set_ylabel("Silhouette width")
ax2.spines["bottom"].set_visible(False)

ax1.set_title(f"Silhouette picks k = {k} state profiles, but they are only weakly separated",
              pad=26)
ax1.text(0, 1.02, "Average silhouette for k = 2…8: " + ", ".join(f"{v:.2f}" for v in avg.values())
         + f" · {(sil < 0).sum()} states misplaced (width < 0) · n = {len(X)} states, "
         f"{X.shape[1]} standardised indicators", transform=ax1.transAxes, fontsize=9.5,
         color="#6E6E73", in_layout=False)
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- US state crime and social indicators, 2009. U.S. Census Bureau. Statistical Abstract of the United States, state tables for 2009 (crime rates from the FBI Uniform Crime Reporting program). https://www.statsmodels.org/stable/datasets/generated/statecrime.html
Compiled for statsmodels (sm.datasets.statecrime); public domain. See the statsmodels page for each variable's table and footnotes.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Silhouette plot for k-means. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/multivariate/silhouette-clusters/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Multivarié et classification
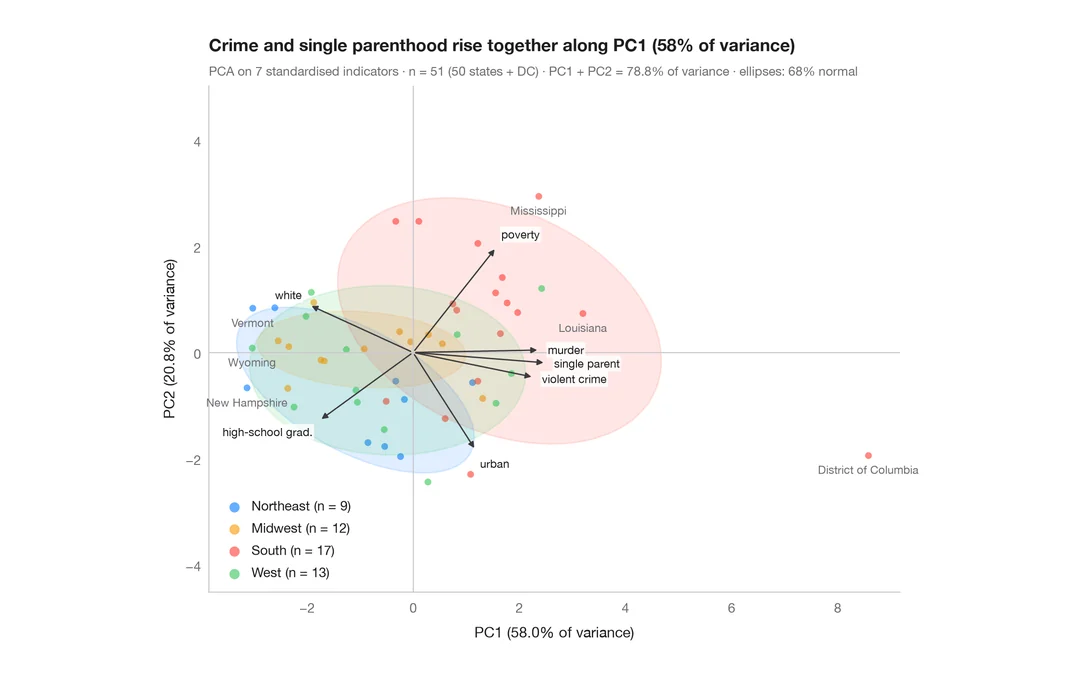
Biplot d'ACP
Les États américains et leurs indicateurs sociaux sur les deux premières composantes principales.
factoextra::fviz_pca_biplot()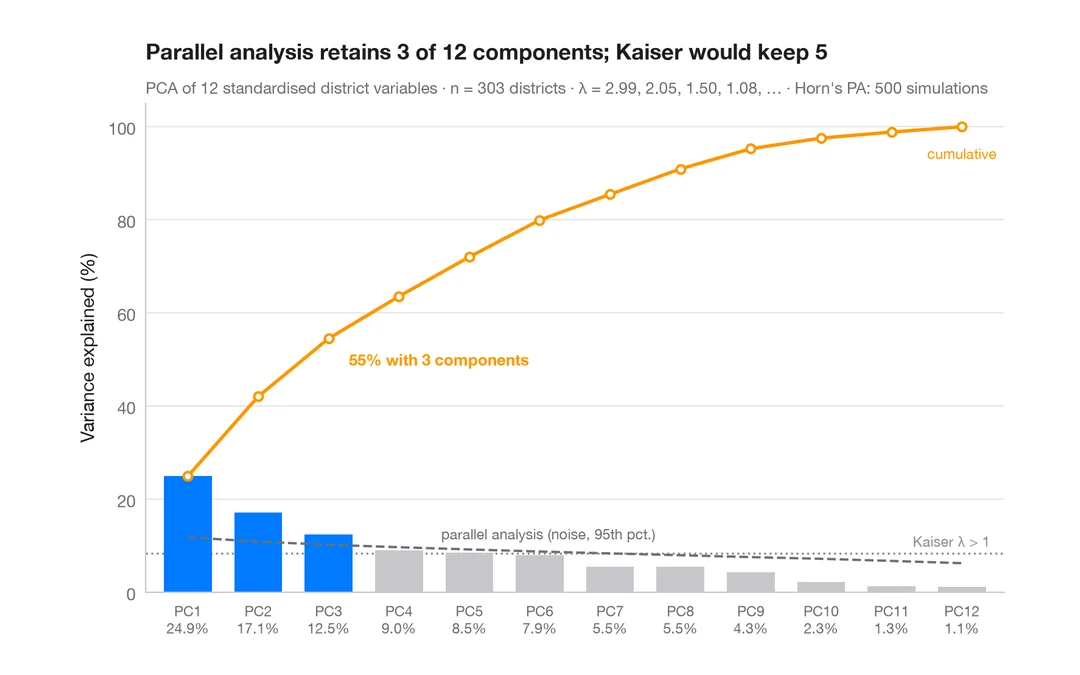
Diagramme des valeurs propres
Combien de dimensions décrivent 303 districts scolaires californiens ? Variance par composante et seuil de l'analyse parallèle.
factoextra::fviz_eig()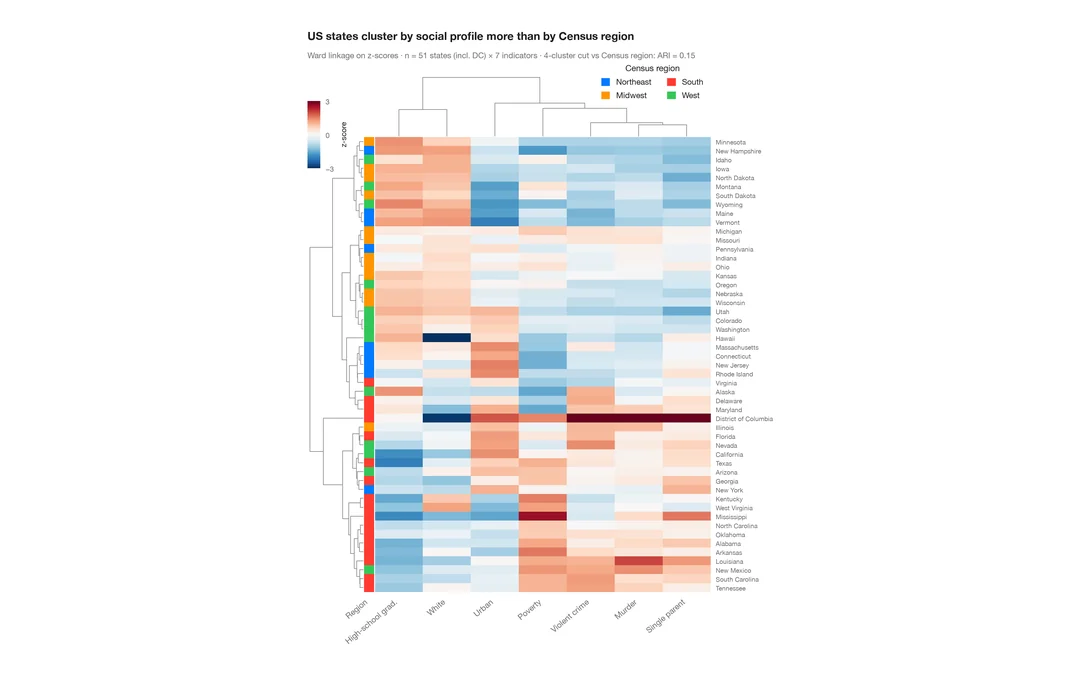
Carte de chaleur avec classification
Carte de chaleur des indicateurs sociaux des États américains en scores z, avec dendrogrammes des lignes et des colonnes et barre de couleur par région du recensement.
pheatmap::pheatmap() / ComplexHeatmap::Heatmap()