Courbes précision–rappel
Courbes précision–rappel hors échantillon pour deux classifieurs qui prédisent quelles femmes mariées déclarent une liaison, avec précision moyenne et référence sans compétence.
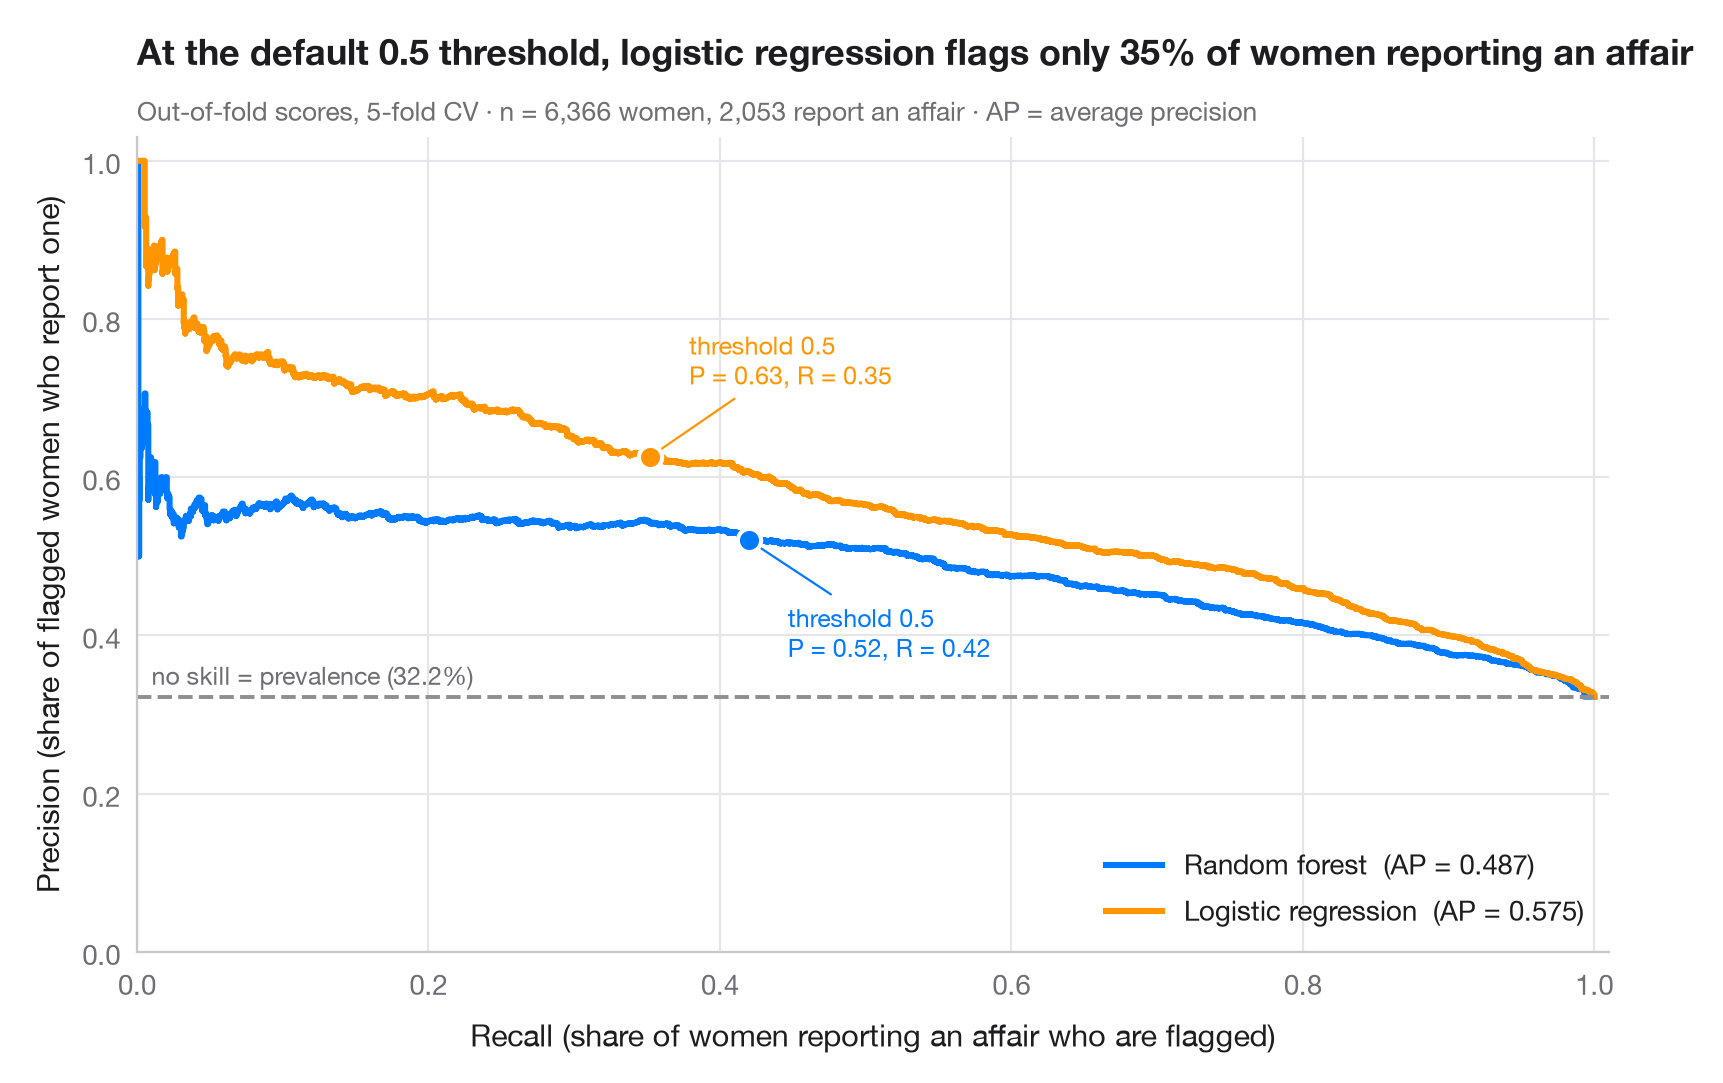
Quand la classe positive est minoritaire, une courbe ROC peut sembler excellente alors que beaucoup d'alertes sont fausses. La courbe précision–rappel répond à la question opérationnelle : si je veux détecter cette part des positifs (rappel), quelle part de mes alertes sera juste (précision) ? Chaque point correspond à un seuil de décision. La ligne en tirets est la référence sans compétence — la prévalence de la classe positive — et l'aire sous chaque courbe est résumée par la précision moyenne (AP).
Les données sont les 6 366 femmes mariées de l'enquête du magazine Redbook de 1974 analysée par Fair (1978), fournies avec statsmodels (sm.datasets.fair). La variable à prédire est le fait de déclarer au moins une liaison extraconjugale — une classe minoritaire, environ une femme sur trois. Les prédicteurs sont la note donnée au mariage, l'âge, les années de mariage, le nombre d'enfants, la religiosité, le niveau d'études et la profession de la femme et de son mari. Les scores sont des probabilités hors échantillon issues d'une validation croisée à 5 plis (cross_val_predict(method="predict_proba")) ; courbes et AP proviennent de precision_recall_curve et average_precision_score. Le marqueur indique le seuil par défaut de 0,5 sur chaque courbe. Ici, la régression logistique classe mieux les femmes que la forêt aléatoire (AP plus élevée), mais au seuil de 0,5 elle ne repère qu'environ un tiers de celles qui déclarent une liaison.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import average_precision_score, precision_recall_curve
from sklearn.model_selection import StratifiedKFold, cross_val_predict
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

# Data: 6,366 married women (1974 survey); 1 = reports any extramarital affair (a minority class)
d = sm.datasets.fair.load_pandas().data
X = d.drop(columns="affairs")
y = (d["affairs"] > 0).astype(int).to_numpy()
prevalence = y.mean()

models = {
    "Random forest": RandomForestClassifier(n_estimators=300, random_state=0),
    "Logistic regression": make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)),
}
palette = ["#007AFF", "#FF9500"]
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
recall = {}

fig, ax = plt.subplots(figsize=(8, 5.2))
for (name, model), c in zip(models.items(), palette):
    score = cross_val_predict(model, X, y, cv=cv, method="predict_proba")[:, 1]
    prec, rec, thr = precision_recall_curve(y, score)
    ap = average_precision_score(y, score)
    ax.step(rec, prec, where="post", color=c, lw=2.2, label=f"{name}  (AP = {ap:.3f})")
    k = np.argmin(np.abs(thr - 0.5))  # the default threshold
    recall[name] = rec[k]
    ax.scatter(rec[k], prec[k], s=70, color=c, edgecolor="white", lw=1.5, zorder=4)
    ax.annotate(f"threshold 0.5\nP = {prec[k]:.2f}, R = {rec[k]:.2f}", (rec[k], prec[k]),
                xytext=(14, -42 if c == palette[0] else 26), textcoords="offset points",
                ha="left", fontsize=9, color=c,
                arrowprops=dict(arrowstyle="-", color=c, lw=0.8))

ax.axhline(prevalence, color="#8E8E93", ls="--", lw=1.4)
ax.text(0.01, prevalence + 0.015, f"no skill = prevalence ({prevalence:.1%})", fontsize=9, color="#6E6E73")
ax.set_xlim(0, 1.01)
ax.set_ylim(0, 1.03)
ax.set_xlabel("Recall (share of women reporting an affair who are flagged)")
ax.set_ylabel("Precision (share of flagged women who report one)")
ax.grid(axis="x")
ax.legend(loc="lower right")
ax.set_title(f"At the default 0.5 threshold, logistic regression flags only {recall['Logistic regression']:.0%} "
             "of women reporting an affair", pad=26)
ax.text(0, 1.02, f"Out-of-fold scores, 5-fold CV · n = {len(y):,} women, {y.sum():,} report an affair · "
        "AP = average precision", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Redbook survey of married women, 1974 (Fair's affairs data). Fair, R. C. (1978). A theory of extramarital affairs. Journal of Political Economy, 86(1), 45–61. https://doi.org/10.1086/260646
Data from the 1974 Redbook magazine survey; distributed with statsmodels (sm.datasets.fair) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Precision–recall curves. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/machine-learning/precision-recall/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Apprentissage automatique

Matrice de confusion avec indicateurs
Dans quelle mesure une régression logistique prédit qui a voté Dole en 1996 — matrice de confusion hors échantillon, avec effectifs et parts par ligne, et intervalles bootstrap pour les principaux indicateurs.
yardstick::conf_mat() + autoplot()
Courbe d'apprentissage
Exactitude d'entraînement et en validation croisée à mesure que l'échantillon d'entraînement grandit, pour deux modèles qui prédisent quelles femmes mariées déclarent une liaison.
caret::learning_curve_dat() + ggplot()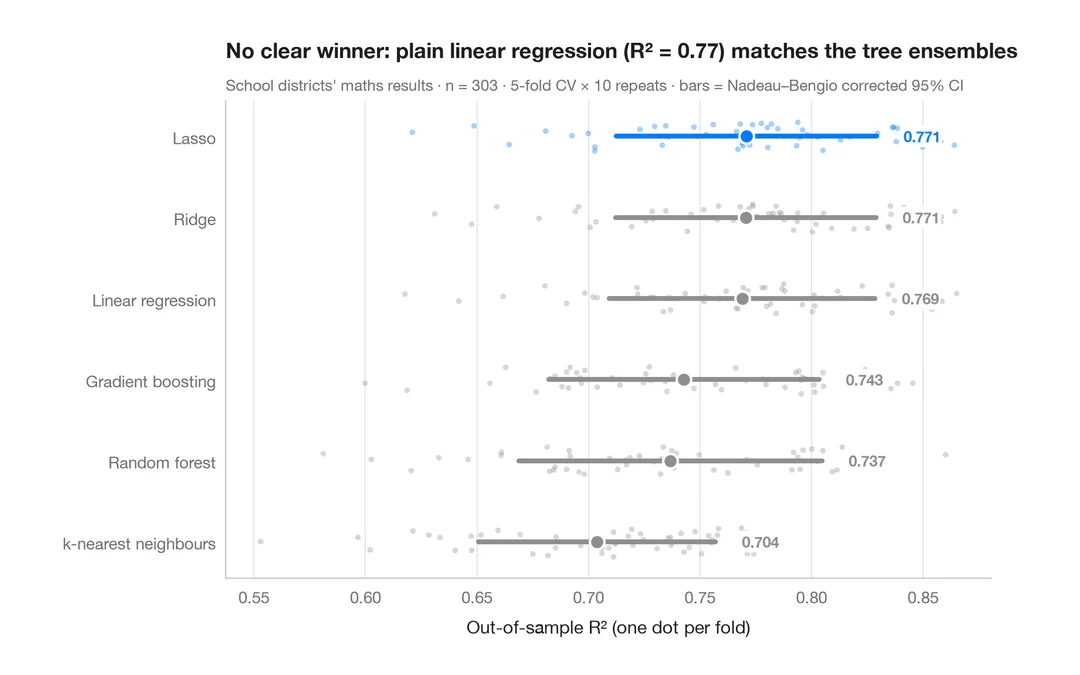
Comparaison de modèles en validation croisée
R² pli par pli de six modèles qui prédisent les résultats en mathématiques des districts scolaires californiens, avec moyennes et intervalles à 95 % corrigés.
caret::resamples() + bwplot() / tune::autoplot()