Comparaison de modèles en validation croisée
R² pli par pli de six modèles qui prédisent les résultats en mathématiques des districts scolaires californiens, avec moyennes et intervalles à 95 % corrigés.
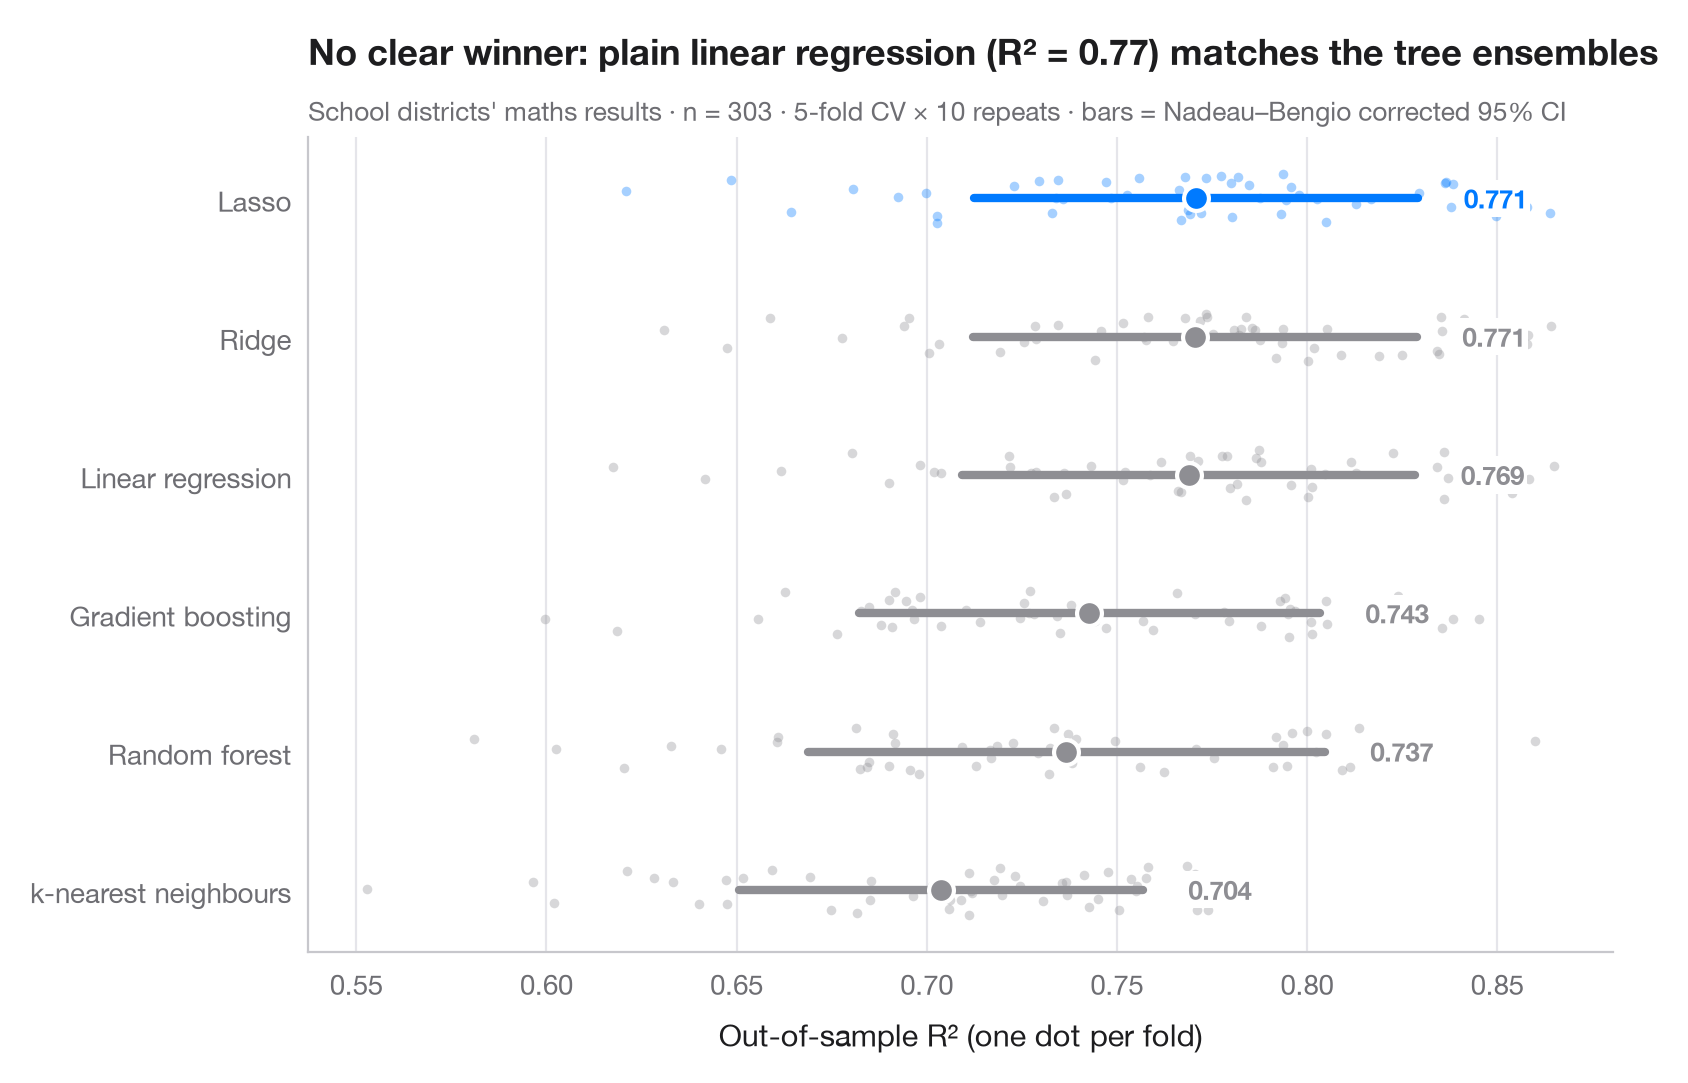
« Le modèle B obtient 0,47, le modèle A 0,46 » ne dit rien tant qu'on ignore de combien le score varie d'un découpage à l'autre. Ici, chaque modèle est évalué sur les mêmes plis répétés 10 × 5 ; chaque point est un pli, le gros marqueur la moyenne et la barre son intervalle à 95 %. Les scores des plis ne sont pas indépendants — les échantillons d'entraînement se chevauchent — l'intervalle utilise donc la variance corrigée de Nadeau et Bengio plutôt que l'erreur type naïve, beaucoup trop étroite.
Les données sont les 303 districts scolaires californiens du test STAR de 1998, fournis avec statsmodels (sm.datasets.star98) : la variable à prédire est la part des élèves au-dessus de la médiane nationale en mathématiques, à partir de dix caractéristiques des districts (part d'élèves à faible revenu, composition ethnique, expérience et salaire des enseignants, dépense par élève, nombre d'élèves par enseignant, inscription aux cours préparatoires à l'université, écoles à calendrier continu). Le score est le R² hors échantillon. Les scores viennent de cross_val_score avec RepeatedKFold ; les modèles linéaires sont standardisés dans un Pipeline. Ici, la simple régression linéaire fait aussi bien que les ensembles d'arbres : la flexibilité n'apporte rien quand la relation est presque additive.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
from scipy import stats
import statsmodels.api as sm
from sklearn.ensemble import GradientBoostingRegressor, RandomForestRegressor
from sklearn.linear_model import LassoCV, LinearRegression, RidgeCV
from sklearn.model_selection import RepeatedKFold, cross_val_score
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

# Data: 303 California school districts; outcome = % of students above the national median in maths
d = sm.datasets.star98.load_pandas().data
y = 100 * d["NABOVE"] / (d["NABOVE"] + d["NBELOW"])
names = {"LOWINC": "% low-income students", "PERASIAN": "% Asian students", "PERBLACK": "% Black students",
         "PERHISP": "% Hispanic students", "AVYRSEXP": "Teacher experience (years)",
         "AVSALK": "Teacher salary ($000)", "PERSPENK": "Spending per pupil ($000)",
         "PTRATIO": "Pupils per teacher", "PCTAF": "% in college-prep courses",
         "PCTYRRND": "% year-round schools"}
X = d[list(names)]
k, reps = 5, 10
cv = RepeatedKFold(n_splits=k, n_repeats=reps, random_state=0)
models = {
    "Linear regression": make_pipeline(StandardScaler(), LinearRegression()),
    "Ridge": make_pipeline(StandardScaler(), RidgeCV(alphas=np.logspace(-3, 3, 25))),
    "Lasso": make_pipeline(StandardScaler(), LassoCV(random_state=0)),
    "Random forest": RandomForestRegressor(n_estimators=300, min_samples_leaf=5, random_state=0),
    "Gradient boosting": GradientBoostingRegressor(learning_rate=0.05, max_depth=2, random_state=0),
    "k-nearest neighbours": make_pipeline(StandardScaler(), KNeighborsRegressor(n_neighbors=15)),
}
scores = {name: cross_val_score(m, X, y, cv=cv, scoring="r2", n_jobs=-1) for name, m in models.items()}

# Nadeau–Bengio corrected 95% interval for a mean of k-fold scores
def corrected_ci(s):
    J = len(s)
    se = np.sqrt((1 / J + (1 / k) / (1 - 1 / k)) * s.var(ddof=1))
    t = stats.t.ppf(0.975, J - 1)
    return s.mean() - t * se, s.mean() + t * se

order = sorted(scores, key=lambda n: scores[n].mean())
best = order[-1]
fig, ax = plt.subplots(figsize=(8, 5.2))
rng = np.random.default_rng(3)
for i, name in enumerate(order):
    s = scores[name]
    c = "#007AFF" if name == best else "#8E8E93"
    ax.scatter(s, i + rng.uniform(-0.18, 0.18, len(s)), s=12, color=c, alpha=0.35, lw=0)
    lo, hi = corrected_ci(s)
    ax.plot([lo, hi], [i, i], color=c, lw=3, solid_capstyle="round")
    ax.scatter(s.mean(), i, s=80, color=c, edgecolor="white", lw=1.5, zorder=4)
    ax.text(hi + 0.012, i, f"{s.mean():.3f}", va="center", fontsize=9.5, color=c, fontweight="semibold",
            bbox=dict(fc="white", ec="none", pad=1), zorder=5)
ax.set_yticks(range(len(order)), order)
ax.set_xlabel("Out-of-sample R² (one dot per fold)")
ax.grid(axis="x"); ax.grid(axis="y", visible=False)
lin = scores["Linear regression"].mean()
ax.set_title(f"No clear winner: plain linear regression (R² = {lin:.2f}) matches the tree ensembles", pad=26)
ax.text(0, 1.02, f"School districts' maths results · n = {len(y)} · {k}-fold CV × {reps} repeats · "
        "bars = Nadeau–Bengio corrected 95% CI", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- California STAR test results, 1998 (303 school districts). Gill, J. (2001). Generalized Linear Models: A Unified Approach (Quantitative Applications in the Social Sciences, No. 134). Sage. https://www.statsmodels.org/stable/datasets/generated/star98.html
Original data from the California Department of Education's Standardized Testing and Reporting (STAR) program, 1998. Subset distributed with statsmodels (sm.datasets.star98) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Cross-validated model comparison. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/machine-learning/model-comparison/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Apprentissage automatique

Matrice de confusion avec indicateurs
Dans quelle mesure une régression logistique prédit qui a voté Dole en 1996 — matrice de confusion hors échantillon, avec effectifs et parts par ligne, et intervalles bootstrap pour les principaux indicateurs.
yardstick::conf_mat() + autoplot()
Courbes précision–rappel
Courbes précision–rappel hors échantillon pour deux classifieurs qui prédisent quelles femmes mariées déclarent une liaison, avec précision moyenne et référence sans compétence.
yardstick::pr_curve() + autoplot()
Courbe d'apprentissage
Exactitude d'entraînement et en validation croisée à mesure que l'échantillon d'entraînement grandit, pour deux modèles qui prédisent quelles femmes mariées déclarent une liaison.
caret::learning_curve_dat() + ggplot()