Matrice de confusion avec indicateurs
Dans quelle mesure une régression logistique prédit qui a voté Dole en 1996 — matrice de confusion hors échantillon, avec effectifs et parts par ligne, et intervalles bootstrap pour les principaux indicateurs.
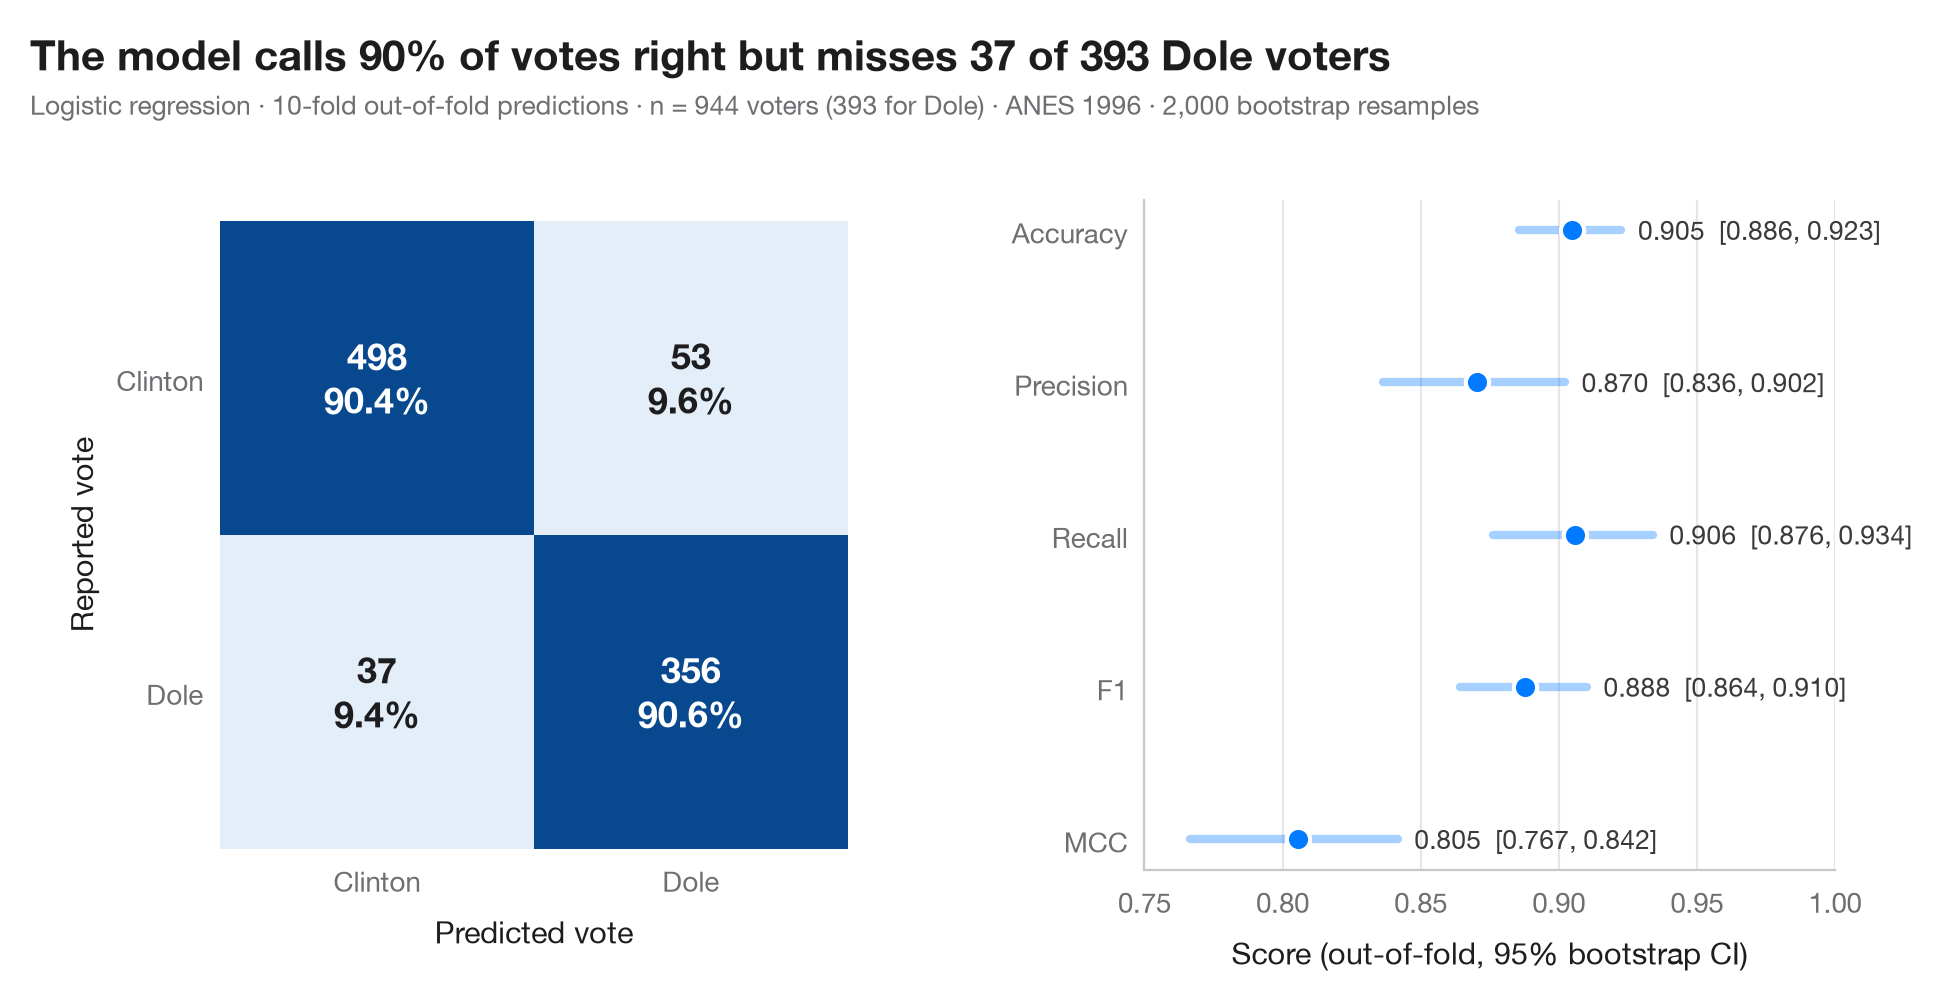
Une matrice de confusion croise la classe réelle et la classe prédite. Chaque case affiche un effectif et sa part dans la classe réelle (la ligne), de sorte que la diagonale se lit directement comme sensibilité et spécificité. Les prédictions sont hors échantillon (out-of-fold) : chaque observation est prédite par un modèle qui ne l'a jamais vue au cours d'une validation croisée à 10 plis — c'est ce à quoi ressemblerait la matrice sur de nouvelles données.
Le panneau de droite donne l'exactitude, la précision, le rappel, le F1 et le coefficient de corrélation de Matthews (MCC), chacun avec un intervalle bootstrap à 95 % : un chiffre seul cache combien il varierait avec un autre échantillon. Les données sont les 944 répondants de l'American National Election Study de 1996 ayant voté pour Clinton ou pour Dole, fournis avec statsmodels (sm.datasets.anes96). Le modèle prédit un vote Dole à partir de l'identification partisane, de l'auto-positionnement gauche–droite, de l'âge, du niveau d'études, du revenu, du nombre de jours passés à regarder le journal télévisé et de la population (en log) du lieu de résidence. C'est une régression logistique standardisée ; les prédictions viennent de cross_val_predict et les indicateurs de sklearn.metrics.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (accuracy_score, confusion_matrix, f1_score, matthews_corrcoef,
                             precision_score, recall_score)
from sklearn.model_selection import StratifiedKFold, cross_val_predict
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

# Data: 944 voters in the 1996 US presidential election; 1 = voted Dole, 0 = voted Clinton
d = sm.datasets.anes96.load_pandas().data
X = d[["PID", "selfLR", "age", "educ", "income", "TVnews", "logpopul"]]
y = d["vote"].to_numpy().astype(int)
labels = ["Clinton", "Dole"]

# Out-of-fold predictions from a 10-fold cross-validation
model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))
cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=0)
pred = cross_val_predict(model, X, y, cv=cv)
cm = confusion_matrix(y, pred)

# Metrics with 95% bootstrap intervals
metrics = {"Accuracy": accuracy_score, "Precision": precision_score, "Recall": recall_score,
           "F1": f1_score, "MCC": matthews_corrcoef}
rng = np.random.default_rng(1)
boot = {k: [] for k in metrics}
for _ in range(2000):
    i = rng.integers(0, len(y), len(y))
    for k, f in metrics.items():
        boot[k].append(f(y[i], pred[i]))
point = {k: f(y, pred) for k, f in metrics.items()}
ci = {k: np.percentile(v, [2.5, 97.5]) for k, v in boot.items()}

plt.rcParams["figure.constrained_layout.use"] = False   # manual margins leave room for the subtitle
fig, (ax, axm) = plt.subplots(1, 2, figsize=(9.5, 5), gridspec_kw=dict(width_ratios=(1, 1.1)))
fig.subplots_adjust(left=0.12, right=0.97, top=0.80, bottom=0.13, wspace=0.45)

# Confusion matrix: colour = share of the true class
share = cm / cm.sum(axis=1, keepdims=True)
ax.imshow(share, cmap="Blues", vmin=0, vmax=1)
for r in range(2):
    for c in range(2):
        ax.text(c, r, f"{cm[r, c]}\n{share[r, c]:.1%}", ha="center", va="center", fontsize=13,
                fontweight="semibold", color="white" if share[r, c] > 0.5 else "#1d1d1f")
ax.set_xticks([0, 1], labels)
ax.set_yticks([0, 1], labels)
ax.set_xlabel("Predicted vote")
ax.set_ylabel("Reported vote")
ax.grid(False)
for s in ax.spines.values():
    s.set_visible(False)

# Metrics with intervals
names = list(metrics)[::-1]
for j, k in enumerate(names):
    axm.plot(ci[k], [j, j], color="#007AFF", lw=3, solid_capstyle="round", alpha=0.35)
    axm.scatter(point[k], j, s=70, color="#007AFF", zorder=3, edgecolor="white", lw=1.5)
    axm.text(ci[k][1] + 0.006, j, f"{point[k]:.3f}  [{ci[k][0]:.3f}, {ci[k][1]:.3f}]",
             va="center", fontsize=9.5, color="#3A3A3C")
axm.set_yticks(range(len(names)), names)
axm.set_xlim(0.75, 1.0)
axm.set_xlabel("Score (out-of-fold, 95% bootstrap CI)")
axm.grid(axis="x"); axm.grid(axis="y", visible=False)

fn, pos = cm[1, 0], cm[1].sum()
fig.suptitle(f"The model calls {point['Accuracy']:.0%} of votes right but misses {fn} of {pos} Dole voters",
             x=0.02, y=0.97, ha="left")
fig.text(0.02, 0.885, f"Logistic regression · 10-fold out-of-fold predictions · n = {len(y)} voters "
         f"({y.sum()} for Dole) · ANES 1996 · 2,000 bootstrap resamples", fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- American National Election Study, 1996. Rosenstone, S. J., Kinder, D. R., Miller, W. E., & the National Election Studies. (2016). ANES 1996 Time Series Study (ICPSR 6896; Version 6) [Data set]. Inter-university Consortium for Political and Social Research. https://doi.org/10.3886/ICPSR06896.v6
Subset of 944 respondents distributed with statsmodels (sm.datasets.anes96); public domain.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Confusion matrix with metrics. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/machine-learning/confusion-matrix/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Apprentissage automatique

Courbes précision–rappel
Courbes précision–rappel hors échantillon pour deux classifieurs qui prédisent quelles femmes mariées déclarent une liaison, avec précision moyenne et référence sans compétence.
yardstick::pr_curve() + autoplot()
Courbe d'apprentissage
Exactitude d'entraînement et en validation croisée à mesure que l'échantillon d'entraînement grandit, pour deux modèles qui prédisent quelles femmes mariées déclarent une liaison.
caret::learning_curve_dat() + ggplot()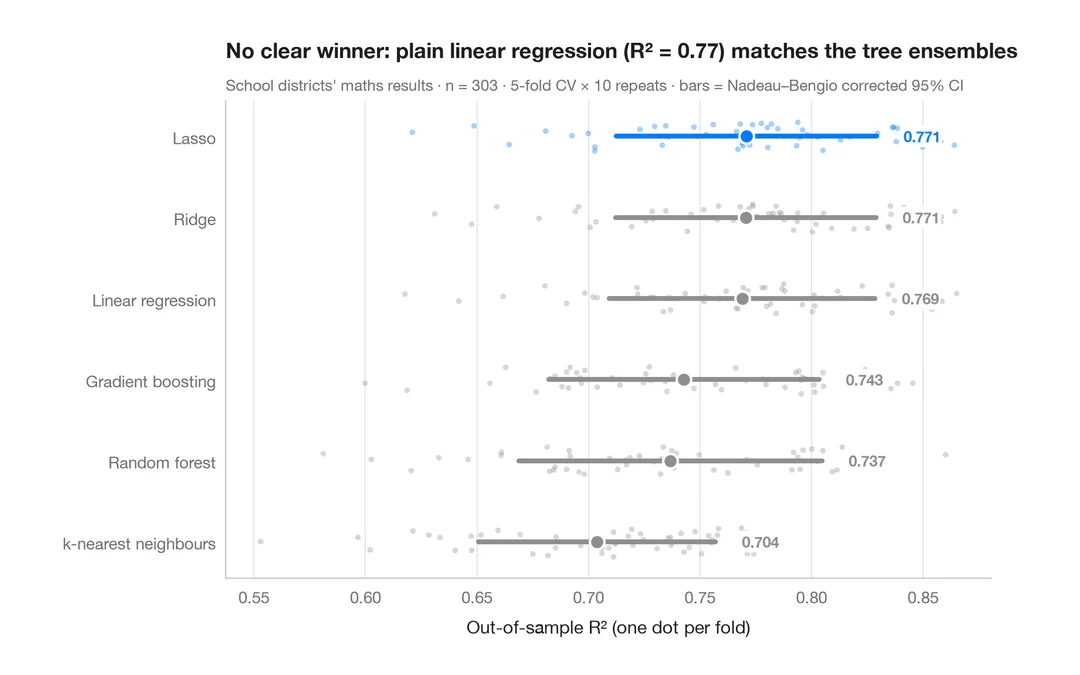
Comparaison de modèles en validation croisée
R² pli par pli de six modèles qui prédisent les résultats en mathématiques des districts scolaires californiens, avec moyennes et intervalles à 95 % corrigés.
caret::resamples() + bwplot() / tune::autoplot()