Courbe d'apprentissage
Exactitude d'entraînement et en validation croisée à mesure que l'échantillon d'entraînement grandit, pour deux modèles qui prédisent quelles femmes mariées déclarent une liaison.
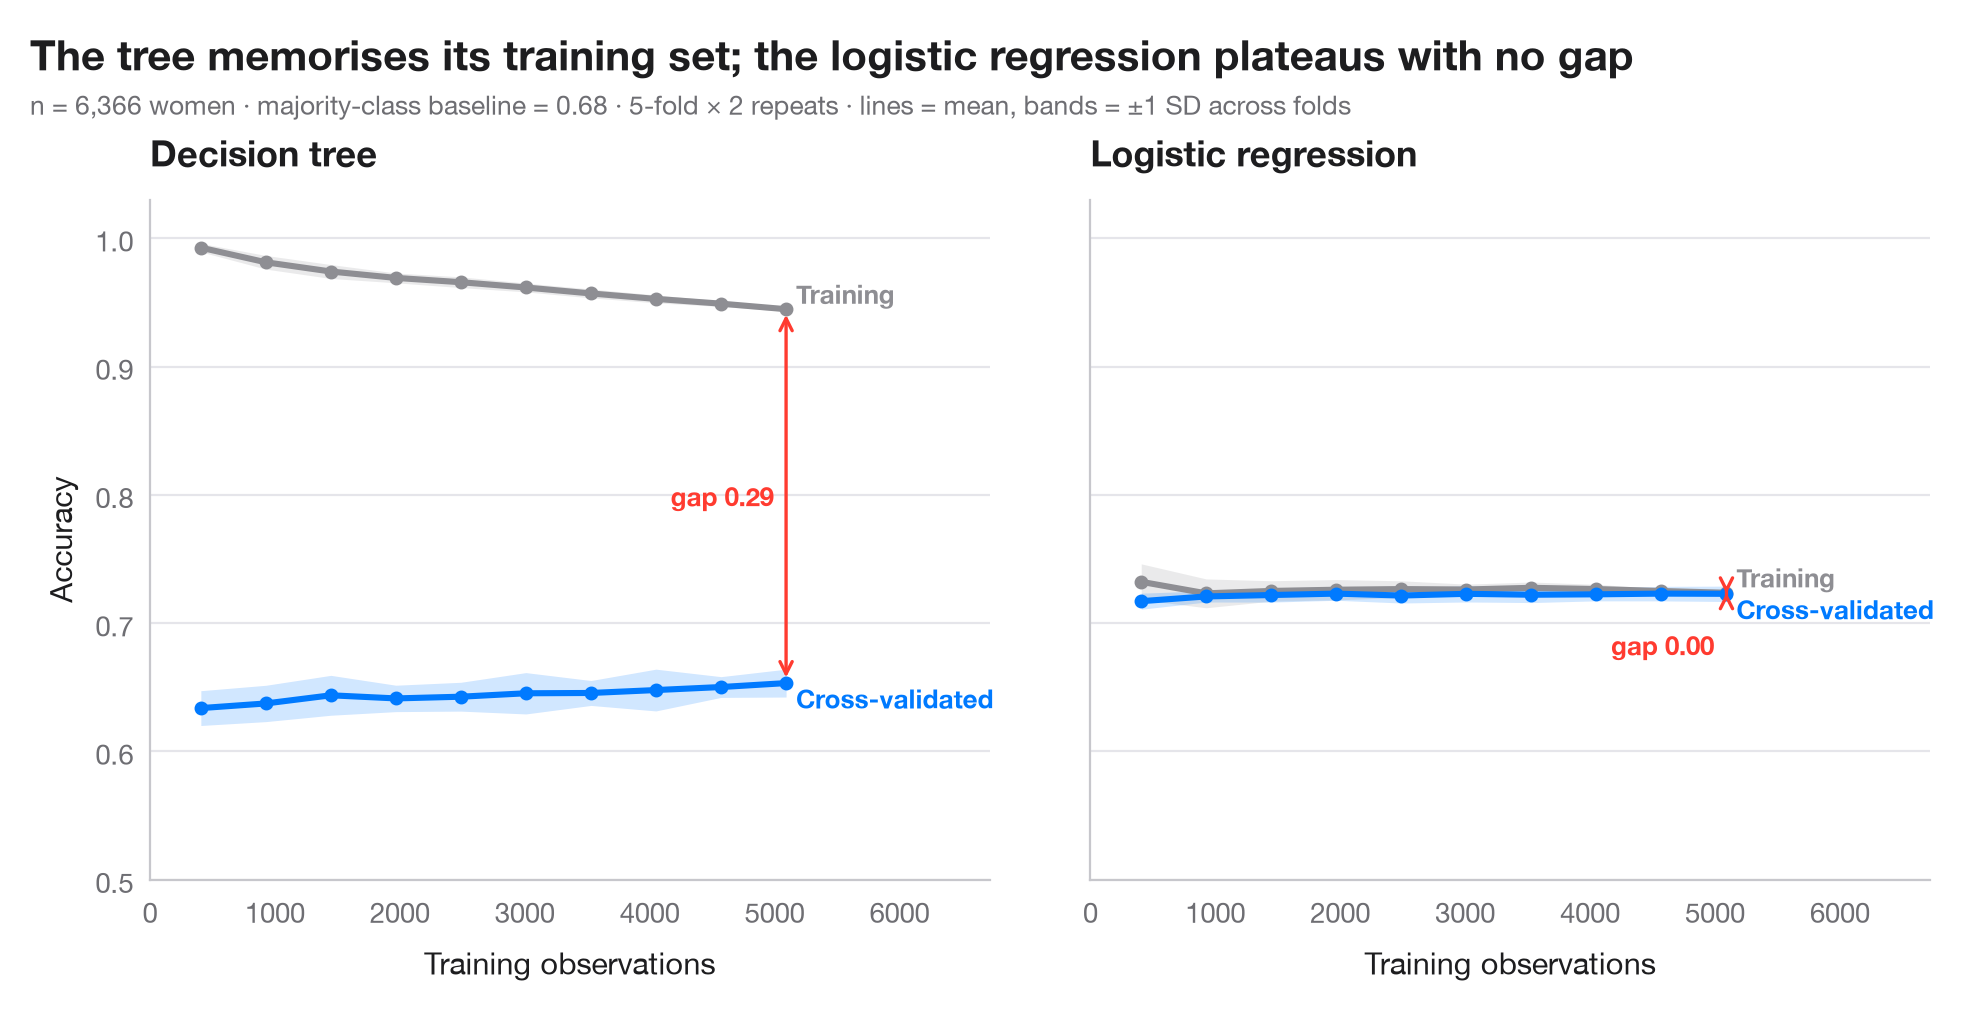
Une courbe d'apprentissage répond à deux questions avant de collecter davantage de données : le modèle surapprend-il (un grand écart entre le score d'entraînement et le score en validation croisée) ou sous-apprend-il (deux scores bas et proches) ? Et plus d'observations aideraient-elles encore (la courbe de validation monte-t-elle toujours) ? Les lignes sont des moyennes sur les plis d'une validation croisée répétée ; les bandes valent ±1 écart type, leur largeur montre combien l'estimation bougerait avec un autre découpage.
Deux modèles sont comparés sur la même tâche : un arbre de décision profond, qui mémorise son échantillon d'entraînement, et une régression logistique standardisée. Les données sont les 6 366 femmes mariées de l'enquête du magazine Redbook de 1974 analysée par Fair (1978), fournies avec statsmodels (sm.datasets.fair) ; la variable à prédire est le fait de déclarer au moins une liaison extraconjugale (environ une sur trois), à partir de la note donnée au mariage, de l'âge, des années de mariage, des enfants, de la religiosité, du niveau d'études et des professions. Les courbes viennent de sklearn.model_selection.learning_curve avec un découpage stratifié 5 × 2 répété. Le verdict est sévère : l'exactitude de l'arbre en validation croisée reste sous la référence de la classe majoritaire, tandis que les deux courbes de la régression logistique sont plates et confondues — davantage de répondantes n'aideraient pas ; de meilleurs prédicteurs, si.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import RepeatedStratifiedKFold, learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeClassifier

# Data: 6,366 married women (1974 survey); 1 = reports any extramarital affair
d = sm.datasets.fair.load_pandas().data
X = d.drop(columns="affairs")
y = (d["affairs"] > 0).astype(int)
cv = RepeatedStratifiedKFold(n_splits=5, n_repeats=2, random_state=0)
sizes = np.linspace(0.08, 1.0, 10)
models = {"Decision tree": DecisionTreeClassifier(random_state=0),
          "Logistic regression": make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))}

plt.rcParams["figure.constrained_layout.use"] = False   # manual margins leave room for the subtitle
fig, axes = plt.subplots(1, 2, figsize=(10, 5), sharey=True)
fig.subplots_adjust(left=0.08, right=0.97, top=0.80, bottom=0.12, wspace=0.12)
for ax, (name, model) in zip(axes, models.items()):
    n, train, valid = learning_curve(model, X, y, cv=cv, train_sizes=sizes, n_jobs=-1,
                                    shuffle=True, random_state=0)   # rows are sorted by outcome
    for scores, c, lab in [(train, "#8E8E93", "Training"), (valid, "#007AFF", "Cross-validated")]:
        m, s = scores.mean(axis=1), scores.std(axis=1)
        ax.fill_between(n, m - s, m + s, color=c, alpha=0.18, lw=0)
        ax.plot(n, m, color=c, lw=2.2, marker="o", ms=4)
        dy = 0.012 if lab == "Training" else -0.012
        ax.text(n[-1] + 80, m[-1] + dy, lab, va="center", fontsize=9.5, color=c, fontweight="semibold")
    gap = train.mean(axis=1)[-1] - valid.mean(axis=1)[-1]
    ax.annotate("", xy=(n[-1], valid.mean(axis=1)[-1]), xytext=(n[-1], train.mean(axis=1)[-1]),
                arrowprops=dict(arrowstyle="<->", color="#FF3B30", lw=1.2))
    ax.text(n[-1] - 100, valid.mean(axis=1)[-1] + (gap / 2 if gap > 0.05 else -0.04), f"gap {gap:.2f}",
            ha="right", va="center", fontsize=9.5, color="#FF3B30", fontweight="semibold")
    ax.set_title(name)
    ax.set_xlabel("Training observations")
    ax.set_xlim(0, n[-1] * 1.32)
axes[0].set_ylabel("Accuracy")
axes[0].set_ylim(0.5, 1.03)

fig.suptitle("The tree memorises its training set; the logistic regression plateaus with no gap",
             x=0.02, y=0.97, ha="left")
fig.text(0.02, 0.885, f"n = {len(y):,} women · majority-class baseline = {1 - y.mean():.2f} · "
         "5-fold × 2 repeats · lines = mean, bands = ±1 SD across folds",
         fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Redbook survey of married women, 1974 (Fair's affairs data). Fair, R. C. (1978). A theory of extramarital affairs. Journal of Political Economy, 86(1), 45–61. https://doi.org/10.1086/260646
Data from the 1974 Redbook magazine survey; distributed with statsmodels (sm.datasets.fair) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Learning curve. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/machine-learning/learning-curve/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Apprentissage automatique

Matrice de confusion avec indicateurs
Dans quelle mesure une régression logistique prédit qui a voté Dole en 1996 — matrice de confusion hors échantillon, avec effectifs et parts par ligne, et intervalles bootstrap pour les principaux indicateurs.
yardstick::conf_mat() + autoplot()
Courbes précision–rappel
Courbes précision–rappel hors échantillon pour deux classifieurs qui prédisent quelles femmes mariées déclarent une liaison, avec précision moyenne et référence sans compétence.
yardstick::pr_curve() + autoplot()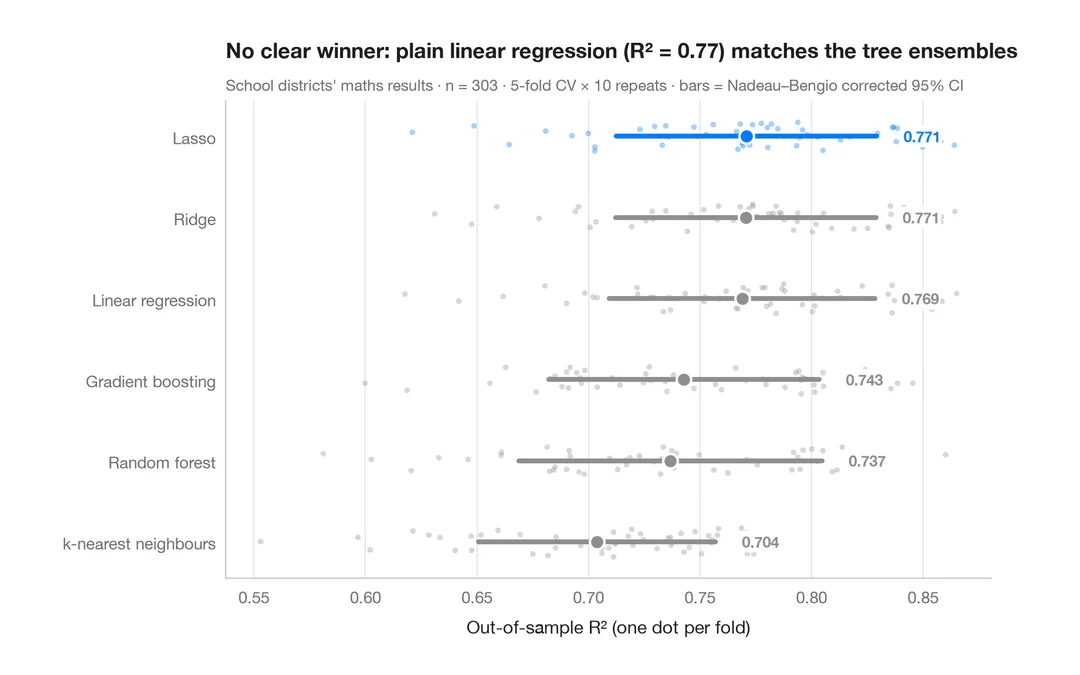
Comparaison de modèles en validation croisée
R² pli par pli de six modèles qui prédisent les résultats en mathématiques des districts scolaires californiens, avec moyennes et intervalles à 95 % corrigés.
caret::resamples() + bwplot() / tune::autoplot()