Prévision SARIMA
Prévision ARIMA saisonnière du chiffre d'affaires industriel avec intervalles de prédiction à 80 % et 95 %, confrontée aux données mises de côté.
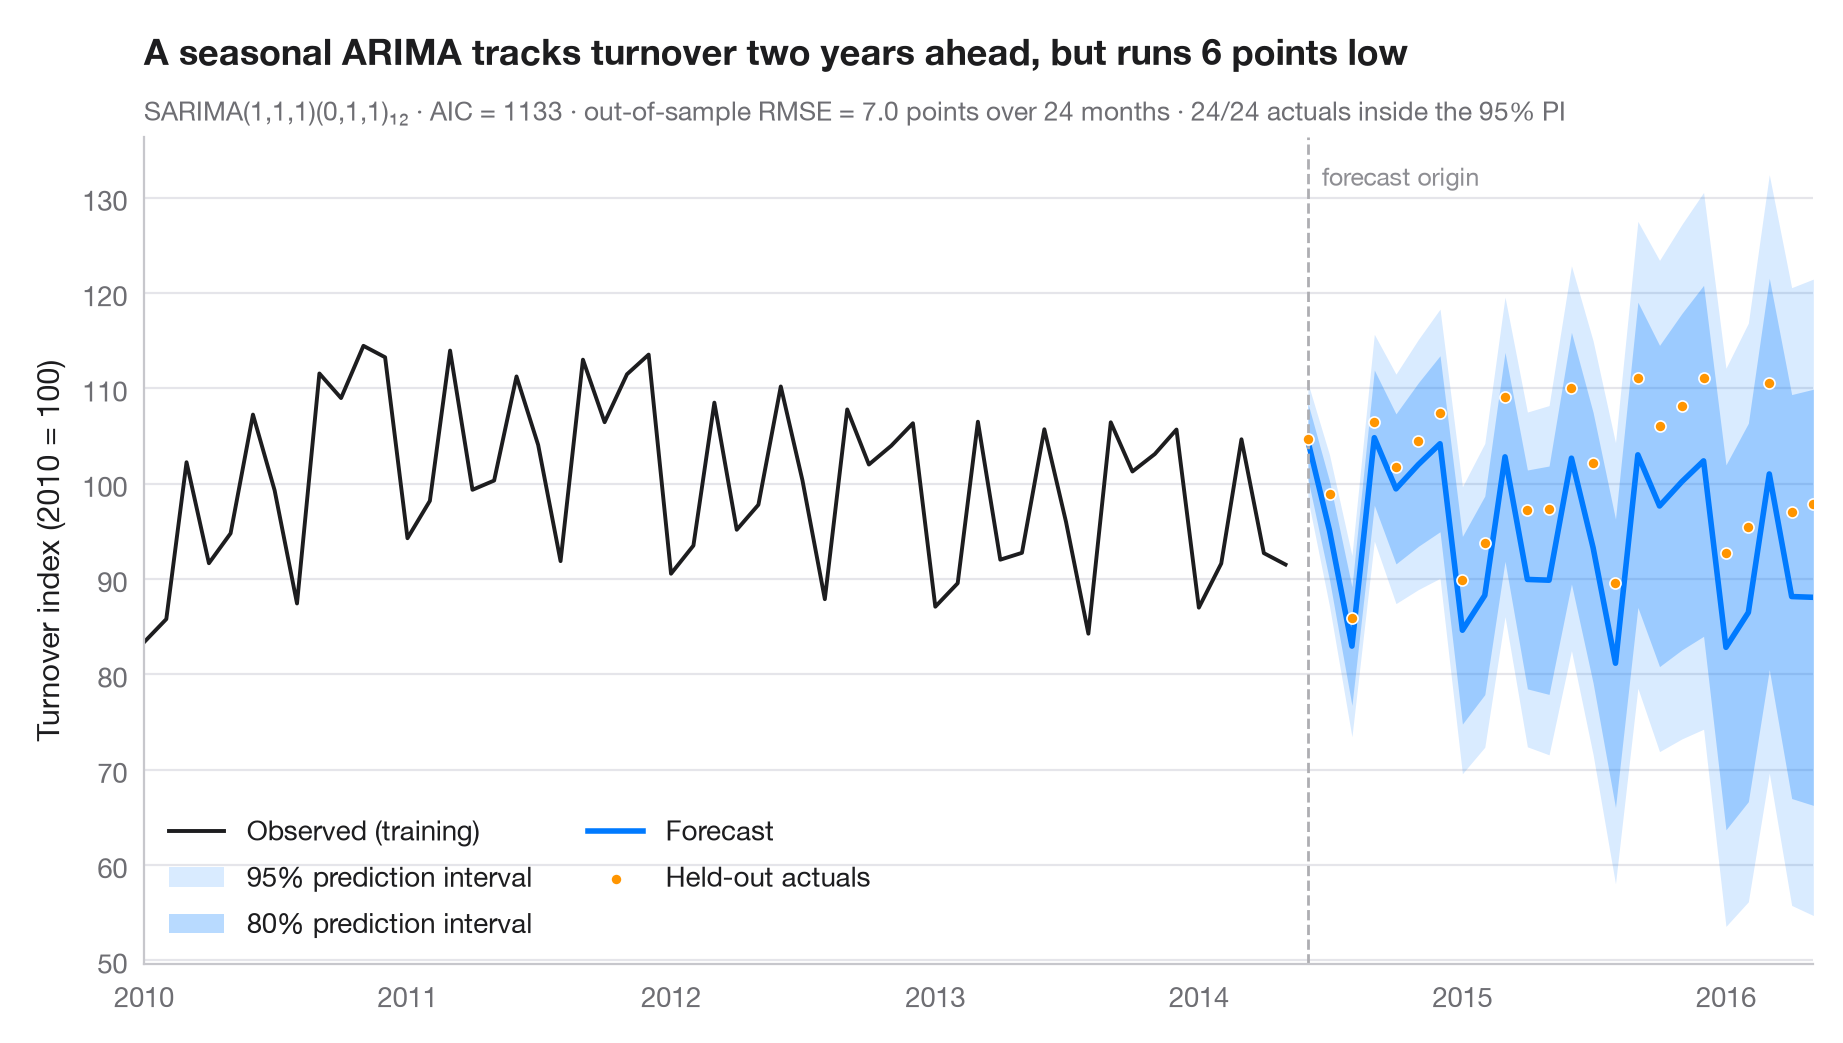
Une prévision n'est honnête qu'accompagnée de son incertitude. L'éventail foncé est l'intervalle de prédiction à 80 %, l'éventail clair l'intervalle à 95 % ; tous deux s'élargissent à mesure que l'horizon s'éloigne. Les deux dernières années ont été mises de côté lors de l'ajustement : les points montrent donc ce qui s'est réellement produit, et le sous-titre rapporte la RMSE hors échantillon ainsi que le nombre de ces mois tombés dans l'intervalle à 95 %.
Les données sont l'indice mensuel Eurostat du chiffre d'affaires de la fabrication d'équipements électriques dans la zone euro (2010 = 100), de janvier 1995 à mai 2016, corrigé des jours ouvrables mais non désaisonnalisé (statsmodels.datasets.elec_equip, fourni avec statsmodels). Le modèle est ajusté sur les données jusqu'à mai 2014 et prévoit juin 2014 – mai 2016. Il s'agit d'un ARIMA saisonnier (1,1,1)(0,1,1)₁₂ — la structure classique dite « airline » — ajusté avec statsmodels.tsa.statespace.SARIMAX ; les intervalles proviennent de get_forecast().conf_int(). Chaque mois mis de côté tombe dans l'intervalle à 95 %, mais la prévision reste en moyenne en dessous des valeurs observées.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
from statsmodels.datasets import elec_equip
from statsmodels.tsa.statespace.sarimax import SARIMAX

# Data: euro-area turnover index, electrical equipment (2010 = 100); hold out the last 2 years
turnover = elec_equip.load().data.iloc[:, 0].asfreq("MS")
h = 24
train, test = turnover[:-h], turnover[-h:]

# Fit a seasonal ARIMA and forecast the held-out horizon
fit = SARIMAX(train, order=(1, 1, 1), seasonal_order=(0, 1, 1, 12)).fit(disp=False)
fc = fit.get_forecast(h)
mean, ci95, ci80 = fc.predicted_mean, fc.conf_int(alpha=0.05), fc.conf_int(alpha=0.20)

rmse = np.sqrt(((test - mean) ** 2).mean())
bias = (test - mean).mean()                       # > 0: actuals above the forecast
covered = ((test >= ci95.iloc[:, 0]) & (test <= ci95.iloc[:, 1])).sum()

fig, ax = plt.subplots(figsize=(9, 5))
hist = train["2010":]
ax.plot(hist.index, hist, color="#1D1D1F", lw=1.4, label="Observed (training)")
ax.fill_between(mean.index, ci95.iloc[:, 0], ci95.iloc[:, 1], color="#007AFF", alpha=0.15, lw=0,
                label="95% prediction interval")
ax.fill_between(mean.index, ci80.iloc[:, 0], ci80.iloc[:, 1], color="#007AFF", alpha=0.28, lw=0,
                label="80% prediction interval")
ax.plot(mean.index, mean, color="#007AFF", lw=2, label="Forecast")
ax.scatter(test.index, test, s=16, color="#FF9500", edgecolor="white", lw=0.6, zorder=4,
           label="Held-out actuals")

# Mark the forecast origin
ax.axvline(test.index[0], color="#AEAEB2", lw=1, ls="--")
ax.text(test.index[0], 0.97, "  forecast origin", transform=ax.get_xaxis_transform(),
        fontsize=9, color="#8E8E93", va="top")

ax.set(ylabel="Turnover index (2010 = 100)", xlim=(hist.index[0], test.index[-1]))
ax.legend(loc="lower left", ncols=2)
ax.set_title(f"A seasonal ARIMA tracks turnover two years ahead, but runs {abs(bias):.0f} points "
             f"{'low' if bias > 0 else 'high'}", pad=26)
ax.text(0, 1.02, f"SARIMA(1,1,1)(0,1,1)₁₂ · AIC = {fit.aic:.0f} · out-of-sample RMSE = {rmse:.1f} points "
        f"over {h} months · {covered}/{h} actuals inside the 95% PI",
        transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Euro-area electrical-equipment turnover, monthly, 1995–2016. Eurostat. Euro area (18, fixed composition) total turnover index, manufacture of electrical equipment (NACE Rev. 2), working-day adjusted, not seasonally adjusted. https://ec.europa.eu/eurostat
Distributed with statsmodels (statsmodels.datasets.elec_equip); public domain.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). SARIMA forecast. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/time-series/arima-forecast/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Séries chronologiques
Décomposition STL
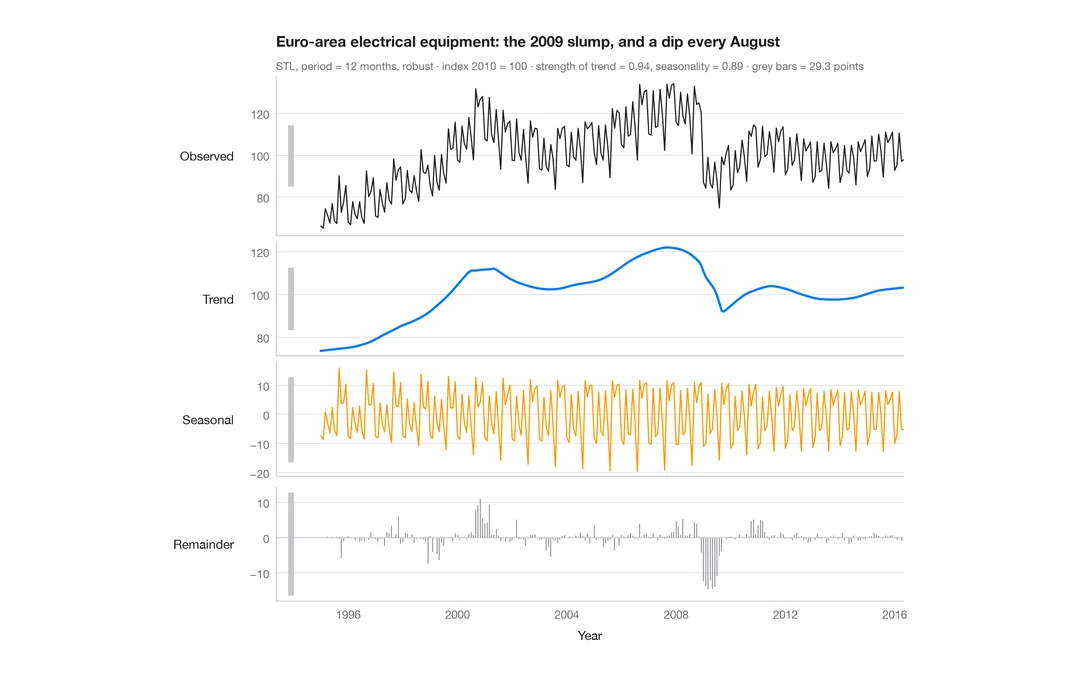
Une série mensuelle de chiffre d'affaires industriel décomposée en tendance, saisonnalité et résidu dans des panneaux superposés.
feasts::STL() + autoplot()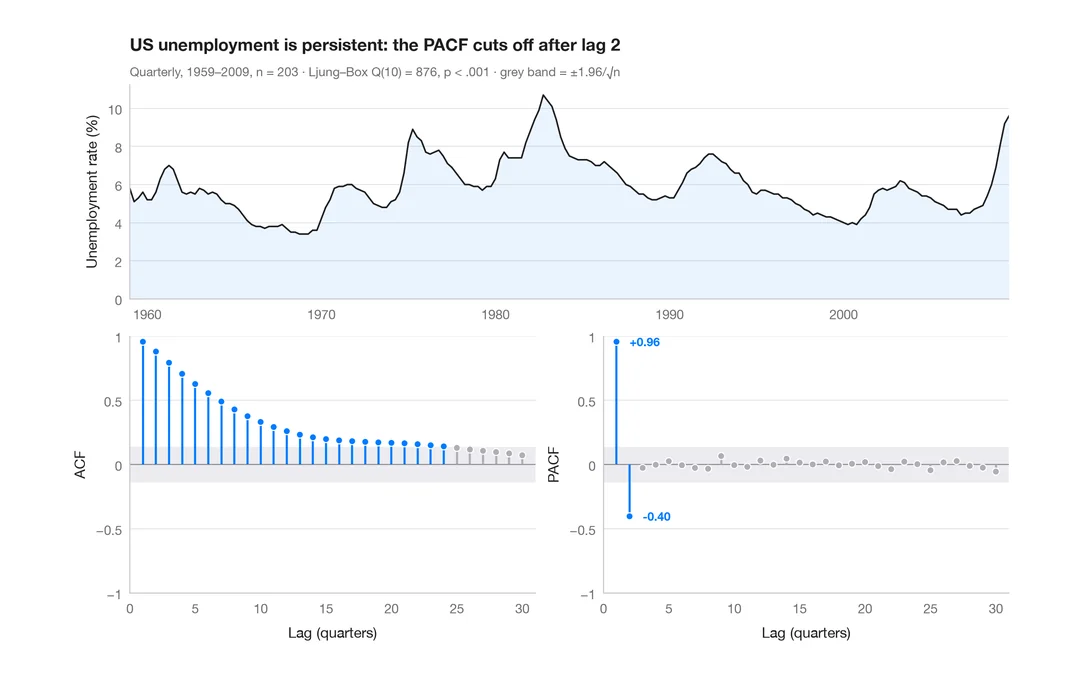
ACF et PACF
Autocorrélation et autocorrélation partielle du chômage trimestriel aux États-Unis, en sucettes avec bandes de significativité à 95 %.
forecast::ggtsdisplay()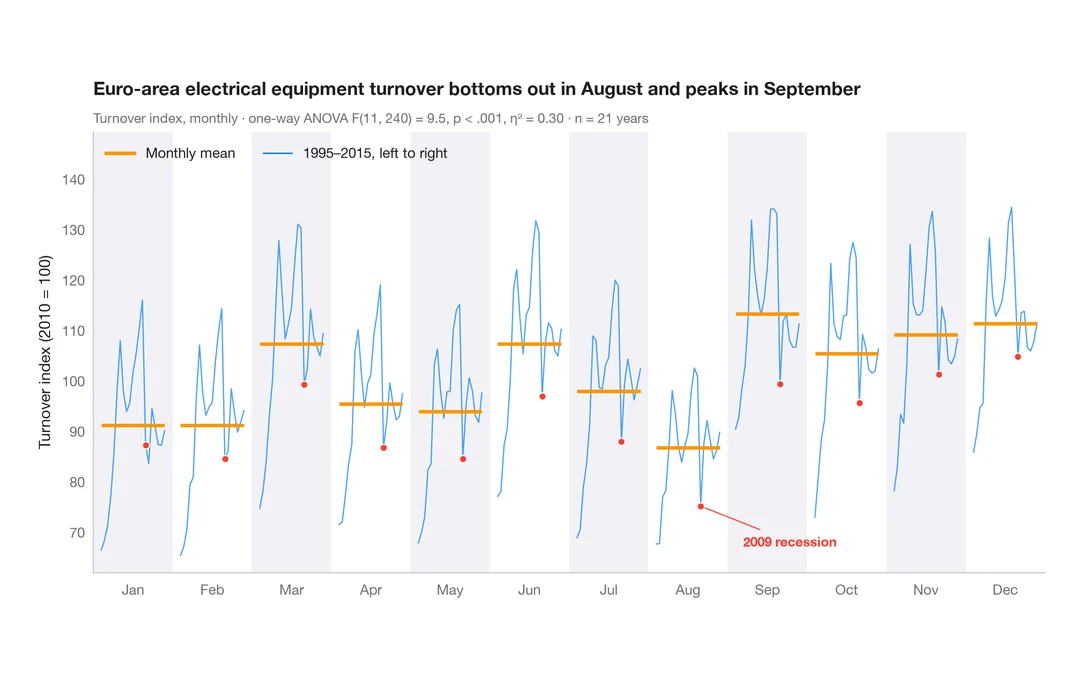
Graphique des sous-séries saisonnières
Le chiffre d'affaires industriel de chaque mois de l'année au fil des ans, avec la moyenne mensuelle comme référence.
feasts::gg_subseries()