Décomposition STL
Une série mensuelle de chiffre d'affaires industriel décomposée en tendance, saisonnalité et résidu dans des panneaux superposés.
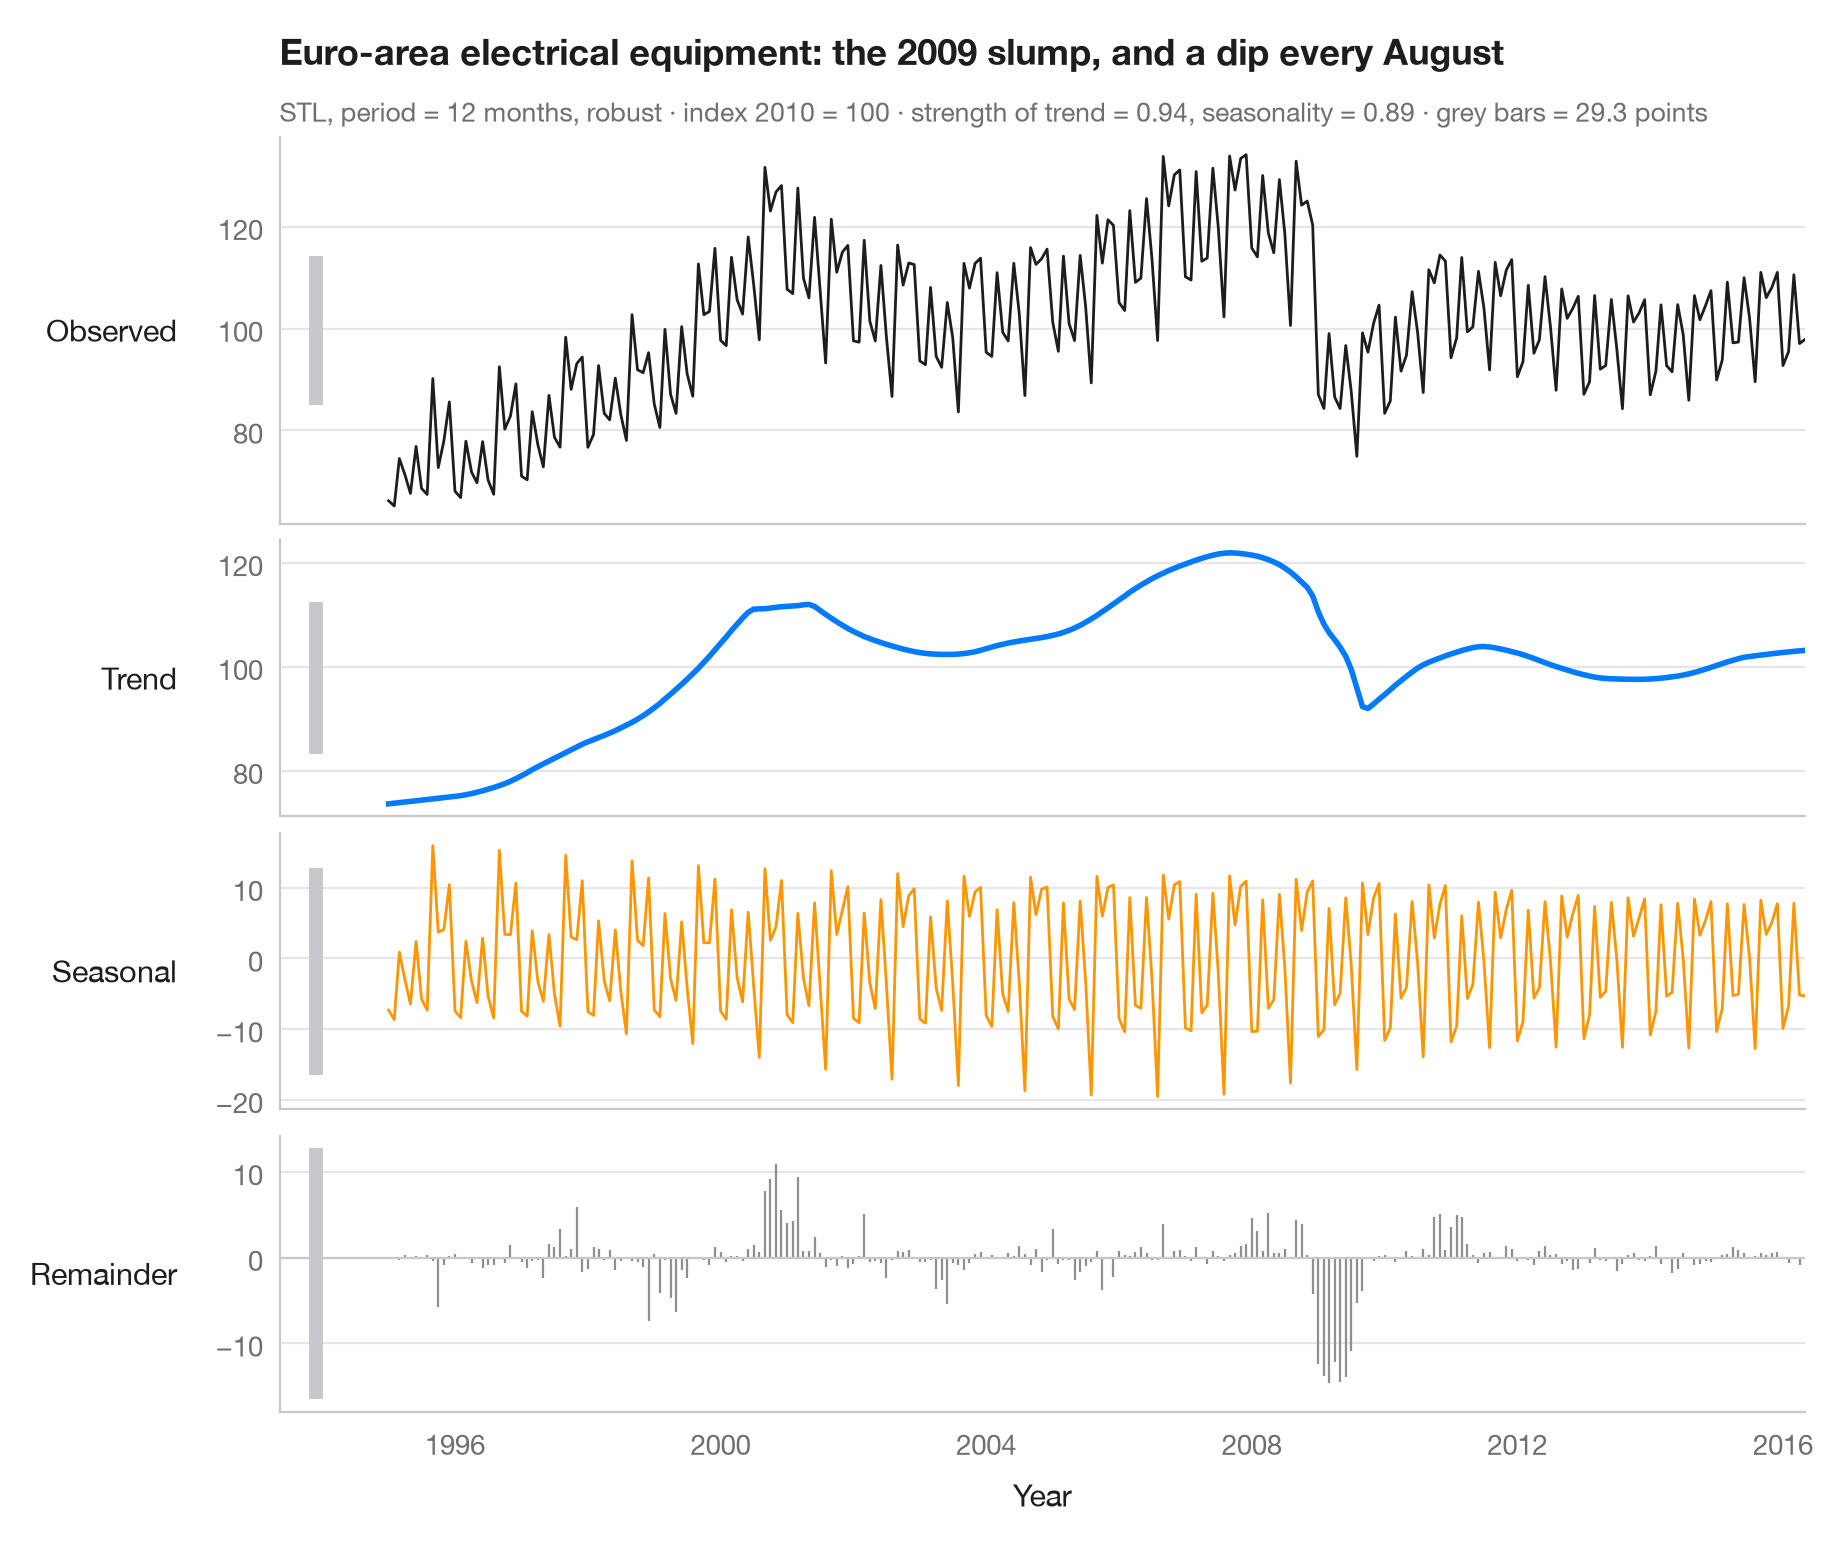
La STL (Seasonal–Trend decomposition using Loess) écrit une série sous la forme observé = tendance + saisonnalité + résidu. Les panneaux partagent l'axe du temps mais ont chacun leur propre échelle verticale ; la barre grise à gauche de chaque panneau — toutes de même longueur en unités des données — montre donc l'importance réelle de chaque composante : une barre courte signale une composante dominante, une barre longue une composante faible.
Les données sont l'indice mensuel Eurostat du chiffre d'affaires de la fabrication d'équipements électriques dans la zone euro (2010 = 100), de janvier 1995 à mai 2016, corrigé des jours ouvrables mais non désaisonnalisé — 257 mois fournis avec statsmodels (statsmodels.datasets.elec_equip). La tendance montre l'effondrement de l'activité industrielle en 2008–09 ; la composante saisonnière montre la fermeture d'août et les pics de fin de trimestre. La décomposition utilise statsmodels.tsa.seasonal.STL avec une période de 12 mois et un ajustement robuste ; le sous-titre donne la force de la tendance et de la saisonnalité selon la définition de Wang, Smith et Hyndman (2006).
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
from statsmodels.datasets import elec_equip
from statsmodels.tsa.seasonal import STL

# Data: euro-area turnover index, electrical equipment manufacturing (2010 = 100), monthly
turnover = elec_equip.load().data.iloc[:, 0]

res = STL(turnover, period=12, robust=True).fit()
parts = {"Observed": turnover, "Trend": res.trend, "Seasonal": res.seasonal, "Remainder": res.resid}
colors = ["#1D1D1F", "#007AFF", "#FF9500", "#8E8E93"]

# Strength of trend and seasonality (0 = none, 1 = all the variation)
f_trend = max(0, 1 - res.resid.var() / (res.trend + res.resid).var())
f_seas = max(0, 1 - res.resid.var() / (res.seasonal + res.resid).var())

fig, axes = plt.subplots(4, 1, figsize=(9, 7.5), sharex=True,
                         gridspec_kw=dict(height_ratios=[1.4, 1, 1, 1]))
bar = 2 * res.resid.abs().max()  # common scale bar, in index points
x0 = turnover.index[0] - np.timedelta64(400, "D")

for ax, (name, s), c in zip(axes, parts.items(), colors):
    if name == "Remainder":
        ax.vlines(s.index, 0, s, color=c, lw=0.8)
        ax.axhline(0, color="#C7C7CC", lw=0.8)
    else:
        ax.plot(s.index, s, color=c, lw=2 if name == "Trend" else 1)
    ax.set_ylabel(name, rotation=0, ha="right", va="center", labelpad=14)
    # Scale bar: same height in index points in every panel
    mid = (s.max() + s.min()) / 2
    ax.plot([x0, x0], [mid - bar / 2, mid + bar / 2], color="#C7C7CC", lw=5, solid_capstyle="butt",
            clip_on=False)

axes[-1].set_xlabel("Year")
fig.align_ylabels(axes)
axes[0].set_xlim(x0 - np.timedelta64(200, "D"), turnover.index[-1])
slump = res.trend.diff(12).idxmin().year                                  # steepest yearly fall
low = res.seasonal.groupby(res.seasonal.index.month_name()).mean().idxmin()  # weakest month
axes[0].set_title(f"Euro-area electrical equipment: the {slump} slump, and a dip every {low}", pad=26)
axes[0].text(0, 1.04, f"STL, period = 12 months, robust · index 2010 = 100 · strength of trend = "
             f"{f_trend:.2f}, seasonality = {f_seas:.2f} · grey bars = {bar:.1f} points",
             transform=axes[0].transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Euro-area electrical-equipment turnover, monthly, 1995–2016. Eurostat. Euro area (18, fixed composition) total turnover index, manufacture of electrical equipment (NACE Rev. 2), working-day adjusted, not seasonally adjusted. https://ec.europa.eu/eurostat
Distributed with statsmodels (statsmodels.datasets.elec_equip); public domain.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). STL decomposition. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/time-series/stl-decomposition/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Séries chronologiques
ACF et PACF
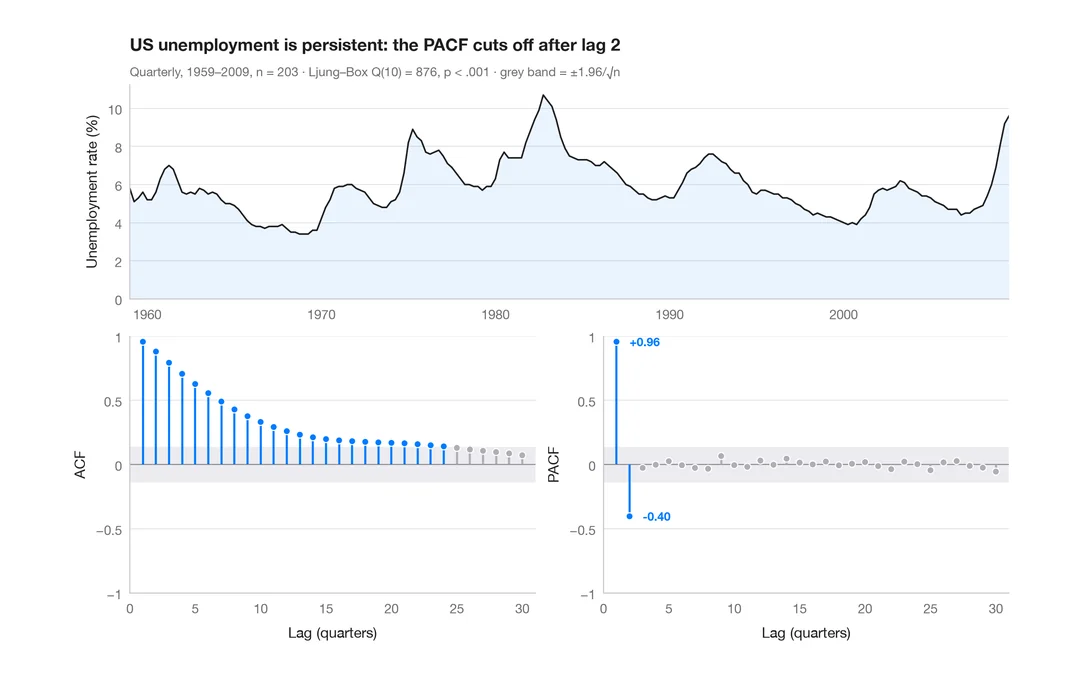
Autocorrélation et autocorrélation partielle du chômage trimestriel aux États-Unis, en sucettes avec bandes de significativité à 95 %.
forecast::ggtsdisplay()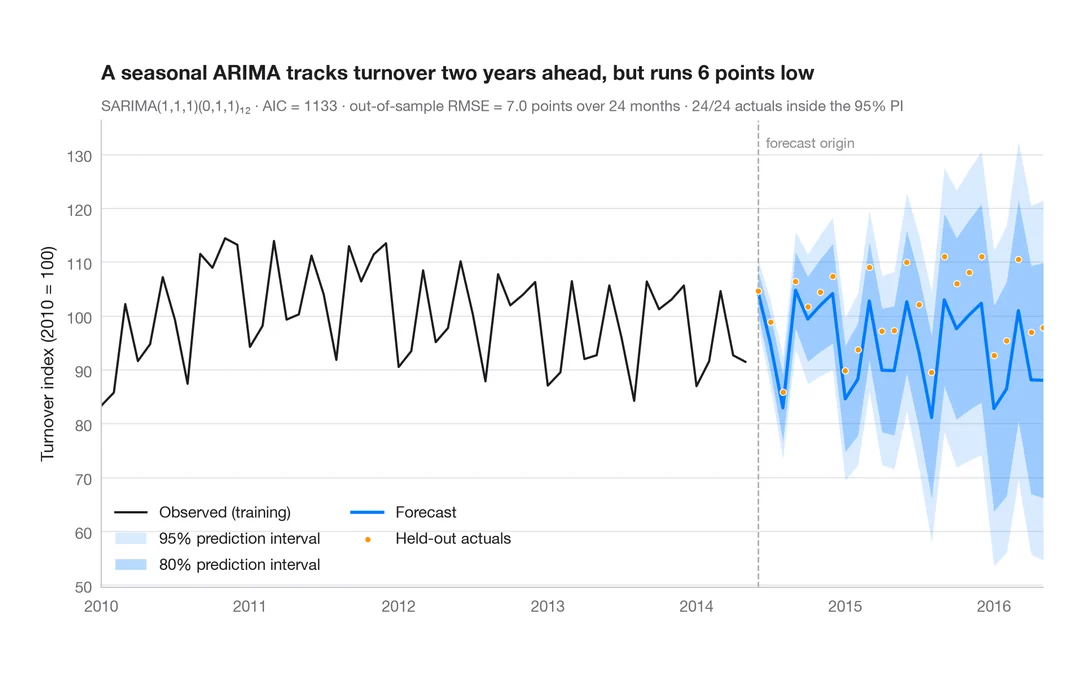
Prévision SARIMA
Prévision ARIMA saisonnière du chiffre d'affaires industriel avec intervalles de prédiction à 80 % et 95 %, confrontée aux données mises de côté.
forecast::autoplot(forecast())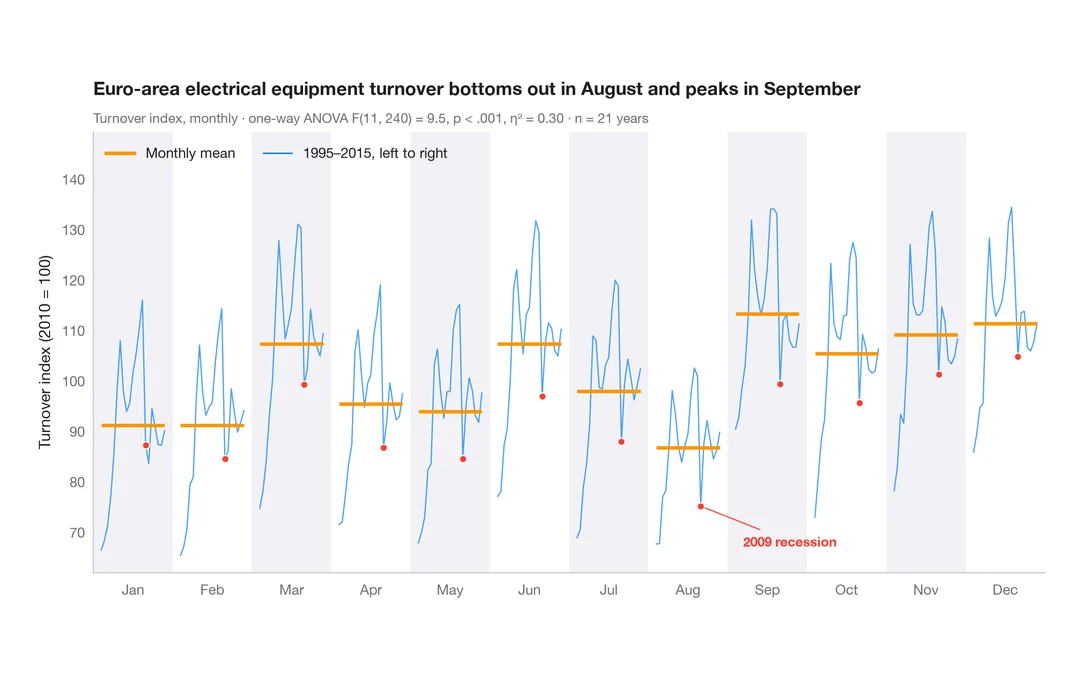
Graphique des sous-séries saisonnières
Le chiffre d'affaires industriel de chaque mois de l'année au fil des ans, avec la moyenne mensuelle comme référence.
feasts::gg_subseries()