Proportions empilées par groupe
Barres empilées à 100 % avec pourcentages, n par barre, test du khi-deux et V de Cramér.
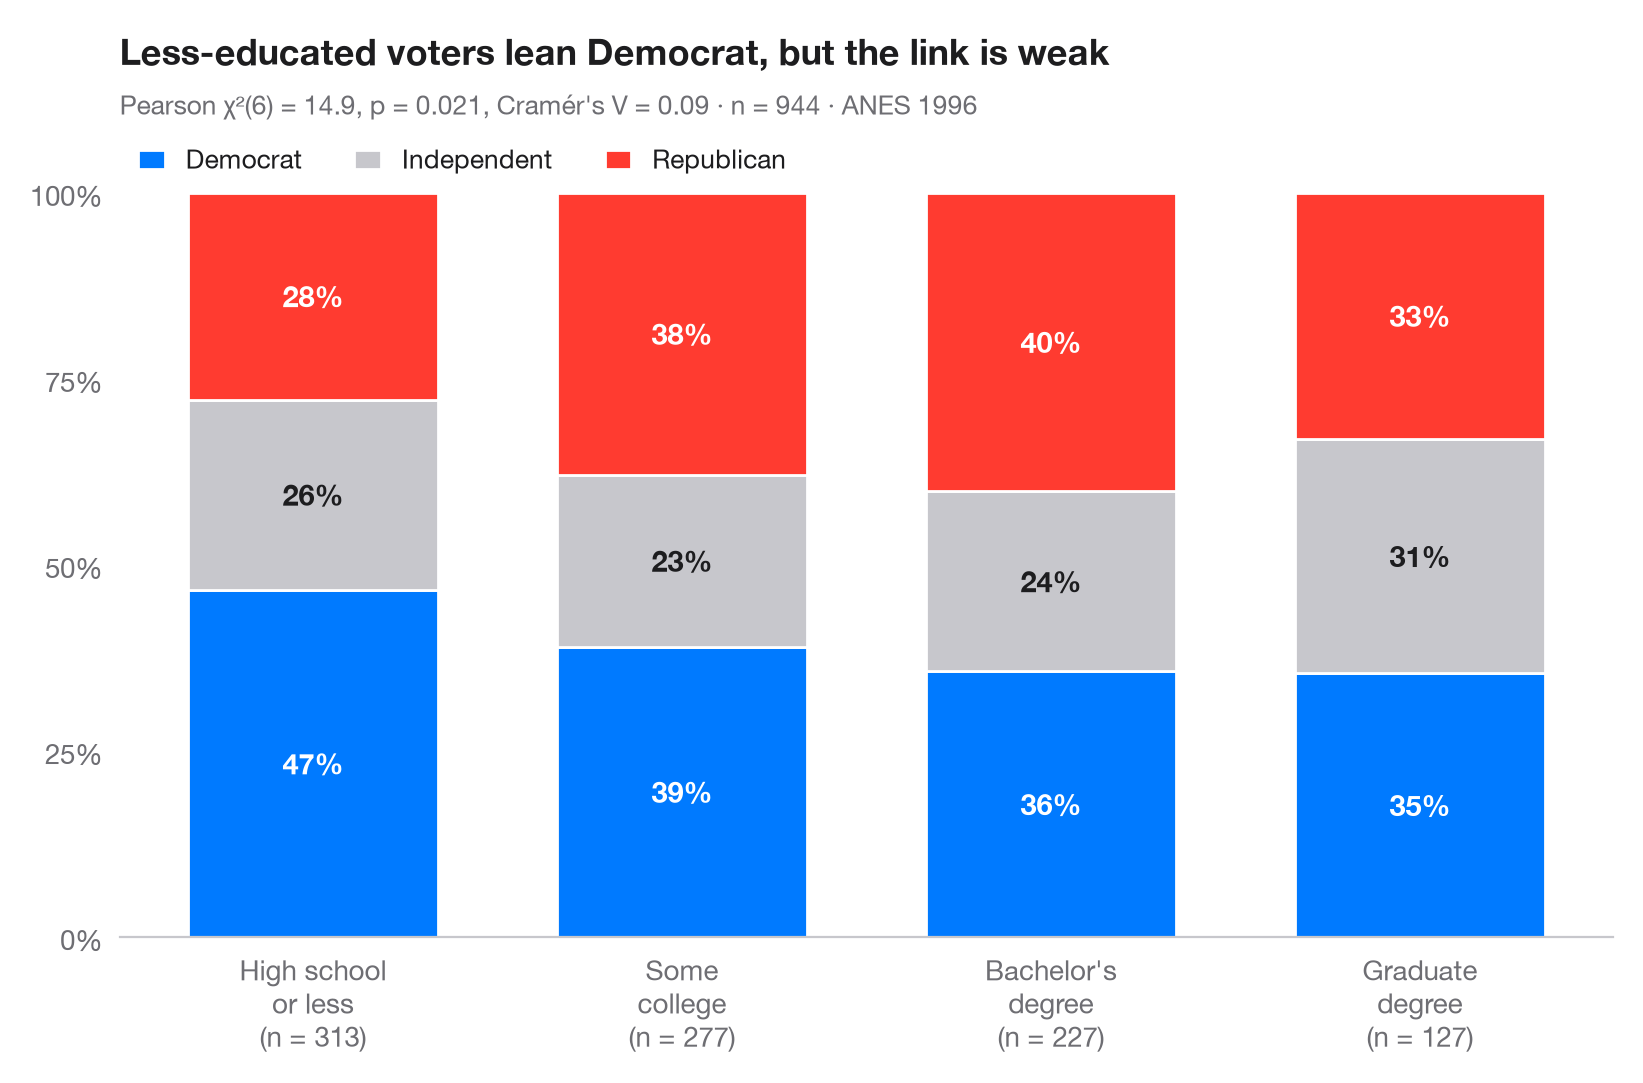
L'équivalent Python de ggbarstats(). Chaque barre représente un groupe ramené à 100 %, de sorte que les segments montrent la distribution conditionnelle de la variable réponse au sein du groupe ; les étiquettes sont des pourcentages en ligne et le nombre sous chaque barre est la taille du groupe. Le sous-titre rapporte le test d'indépendance du χ² de Pearson et le V de Cramér, la taille d'effet qui ramène le χ² dans l'intervalle 0–1.
Les données sont l'American National Election Study de 1996 fournie avec statsmodels (sm.datasets.anes96) : l'identification partisane de 944 électeurs selon le niveau de scolarité. Le test provient de scipy.stats.chi2_contingency et le V de scipy.stats.contingency.association.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import statsmodels.api as sm
from scipy import stats
from scipy.stats.contingency import association

# Data: 1996 ANES — party identification (7-point scale) by education (7 levels)
df = sm.datasets.anes96.load_pandas().data
df["party"] = pd.cut(df.PID, [-1, 1, 4, 6], labels=["Democrat", "Independent", "Republican"])
df["education"] = pd.cut(df.educ, [0, 3, 5, 6, 7],
                         labels=["High school\nor less", "Some\ncollege", "Bachelor's\ndegree", "Graduate\ndegree"])

table = pd.crosstab(df.education, df.party)
pct = table.div(table.sum(axis=1), axis=0) * 100

# Pearson chi-squared test of independence + Cramér's V
chi2, p, dof, _ = stats.chi2_contingency(table, correction=False)
v = association(table.to_numpy(), method="cramer")

fig, ax = plt.subplots(figsize=(8, 5.2))
colors = ["#007AFF", "#C7C7CC", "#FF3B30"]
x = np.arange(len(pct))
bottom = np.zeros(len(pct))
for party, c in zip(pct.columns, colors):
    ax.bar(x, pct[party], bottom=bottom, color=c, width=0.68, label=party, edgecolor="white", lw=1)
    for xi, (b, h) in enumerate(zip(bottom, pct[party])):
        ax.text(xi, b + h / 2, f"{h:.0f}%", ha="center", va="center", fontsize=10.5,
                fontweight="semibold", color="#1D1D1F" if c == "#C7C7CC" else "white")
    bottom += pct[party].to_numpy()

ax.set_xticks(x, [f"{g}\n(n = {n})" for g, n in zip(pct.index, table.sum(axis=1))])
ax.set_yticks(range(0, 101, 25), [f"{t}%" for t in range(0, 101, 25)])
ax.set_ylim(0, 100)
ax.grid(False)
ax.spines["left"].set_visible(False)
ax.legend(ncols=3, loc="lower left", bbox_to_anchor=(0, 1.0), fontsize=9.5,
          handlelength=1, borderaxespad=0.3)
ax.set_title("Less-educated voters lean Democrat, but the link is weak", pad=46)
ax.text(0, 1.105, f"Pearson χ²({dof}) = {chi2:.1f}, p = {p:.3f}, Cramér's V = {v:.2f} · "
        f"n = {table.to_numpy().sum()} · ANES 1996", transform=ax.transAxes,
        fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- American National Election Study, 1996. Rosenstone, S. J., Kinder, D. R., Miller, W. E., & the National Election Studies. (2016). ANES 1996 Time Series Study (ICPSR 6896; Version 6) [Data set]. Inter-university Consortium for Political and Social Research. https://doi.org/10.3886/ICPSR06896.v6
Subset of 944 respondents distributed with statsmodels (sm.datasets.anes96); public domain.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Stacked proportions by group. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/proportions-surveys/stacked-proportions/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Proportions et enquêtes
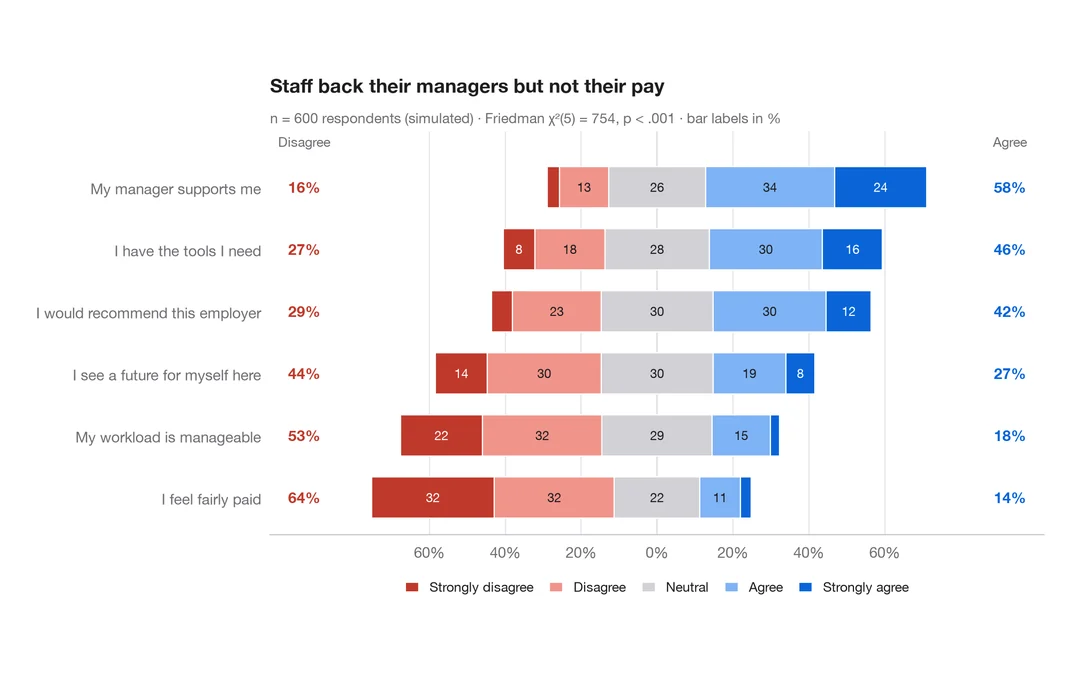
Graphique de Likert divergent
Items de Likert à cinq niveaux en barres empilées divergentes, centrées sur la réponse neutre.
ggstats::gglikert()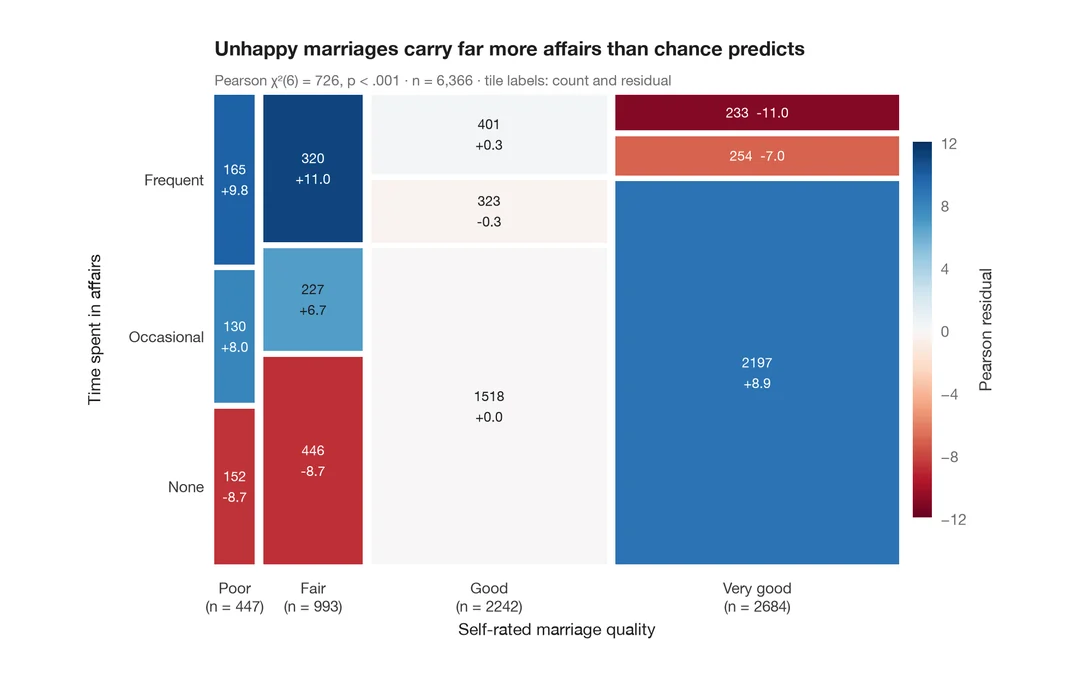
Diagramme en mosaïque avec résidus de Pearson
Aires des tuiles proportionnelles aux effectifs, colorées selon les résidus de Pearson par rapport à l'indépendance.
vcd::mosaic(shade = TRUE)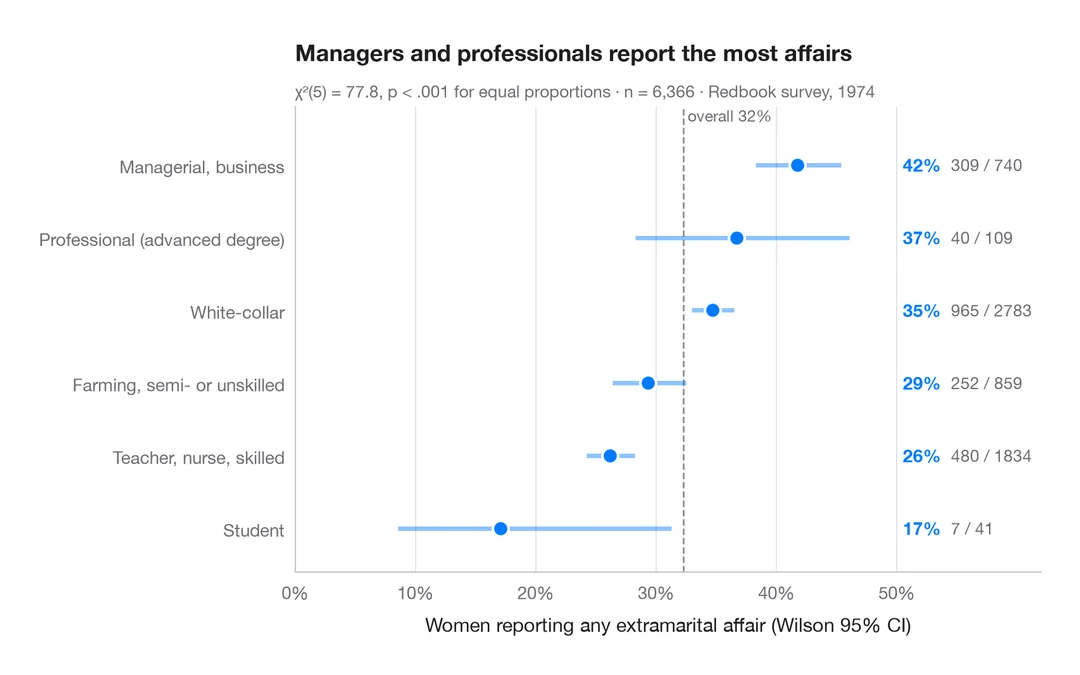
Proportions avec intervalles de confiance
Diagramme en points trié des proportions par groupe, avec intervalles de confiance de Wilson à 95 %.
ggstats::stat_prop() + geom_errorbar()