Proportions avec intervalles de confiance
Diagramme en points trié des proportions par groupe, avec intervalles de confiance de Wilson à 95 %.
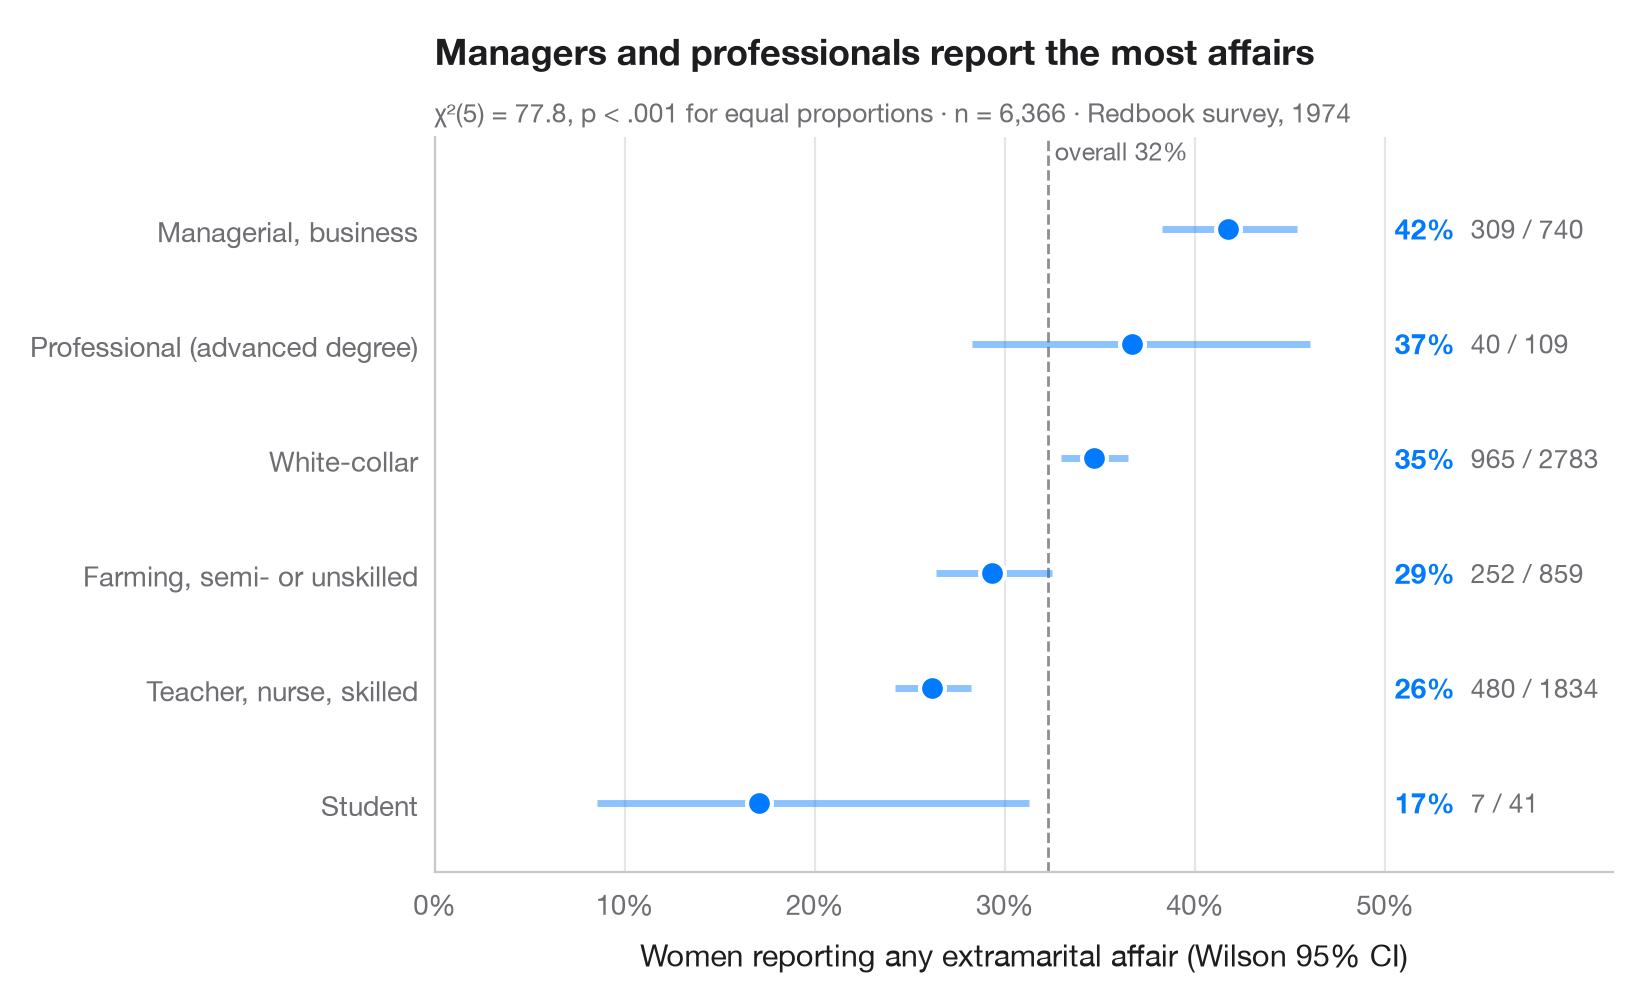
Lorsque la question est « quelle part de chaque groupe… ? », un point par groupe avec son intervalle de confiance vaut mieux qu'un diagramme en barres : l'œil compare des positions, et la largeur de l'intervalle révèle d'emblée quels groupes sont petits. L'intervalle de score de Wilson est préféré à l'intervalle de Wald des manuels, car il conserve sa couverture de 95 % pour les petits groupes et les proportions proches de 0 ou de 1. La ligne en tirets représente la proportion globale.
Les données sont l'enquête Redbook de 1974 auprès de femmes mariées, fournie avec statsmodels (sm.datasets.fair) : la proportion de celles qui ont déclaré au moins une relation extraconjugale, selon la profession de la répondante. Les intervalles proviennent de statsmodels.stats.proportion.proportion_confint(method="wilson") et le sous-titre teste l'égalité de toutes les proportions avec scipy.stats.chi2_contingency.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import statsmodels.api as sm
from scipy import stats
from statsmodels.stats.proportion import proportion_confint

# Data: share of women reporting any affair, by occupation
df = sm.datasets.fair.load_pandas().data
jobs = {1: "Student", 2: "Farming, semi- or unskilled", 3: "White-collar",
        4: "Teacher, nurse, skilled", 5: "Managerial, business", 6: "Professional (advanced degree)"}
df["job"] = df.occupation.map(jobs)
df["affair"] = df.affairs > 0

# Proportion + Wilson 95% CI per group, sorted
g = df.groupby("job").affair.agg(k="sum", n="size")
g["p"] = g.k / g.n
g["low"], g["high"] = proportion_confint(g.k, g.n, alpha=0.05, method="wilson")
g = g.sort_values("p")

# Chi-squared test of homogeneity across the six groups
chi2, pval, dof, _ = stats.chi2_contingency(pd.crosstab(df.job, df.affair), correction=False)
overall = df.affair.mean()

fig, ax = plt.subplots(figsize=(8, 4.8))
y = np.arange(len(g))
ax.axvline(overall, color="#8E8E93", lw=1, ls="--", zorder=1)
ax.text(overall, len(g) - 0.45, f" overall {overall:.0%}", fontsize=9, color="#6E6E73", va="bottom")
ax.hlines(y, g.low, g.high, color="#007AFF", lw=2.5, alpha=0.45, zorder=2)
ax.scatter(g.p, y, s=80, color="#007AFF", edgecolor="white", lw=1.5, zorder=3)

for yi, (_, row) in zip(y, g.iterrows()):
    ax.text(0.505, yi, f"{row.p:.0%}", va="center", fontsize=10, fontweight="semibold", color="#007AFF")
    ax.text(0.545, yi, f"{row.k:.0f} / {row.n:.0f}", va="center", fontsize=9.5, color="#6E6E73")

ax.set_yticks(y, g.index)
ax.set_ylim(-0.6, len(g) - 0.2)
ax.set_xlim(0, 0.62)
ax.set_xticks(np.arange(0, 0.51, 0.1))
ax.xaxis.set_major_formatter(plt.matplotlib.ticker.PercentFormatter(1, decimals=0))
ax.grid(axis="x"); ax.grid(axis="y", visible=False)
ax.set_xlabel("Women reporting any extramarital affair (Wilson 95% CI)")
ax.set_title("Managers and professionals report the most affairs", pad=26)
ax.text(0, 1.02, f"χ²({dof}) = {chi2:.1f}, p < .001 for equal proportions · n = {len(df):,} · "
        "Redbook survey, 1974", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Redbook survey of married women, 1974 (Fair's affairs data). Fair, R. C. (1978). A theory of extramarital affairs. Journal of Political Economy, 86(1), 45–61. https://doi.org/10.1086/260646
Data from the 1974 Redbook magazine survey; distributed with statsmodels (sm.datasets.fair) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Proportions with confidence intervals. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/proportions-surveys/proportions-with-ci/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Proportions et enquêtes
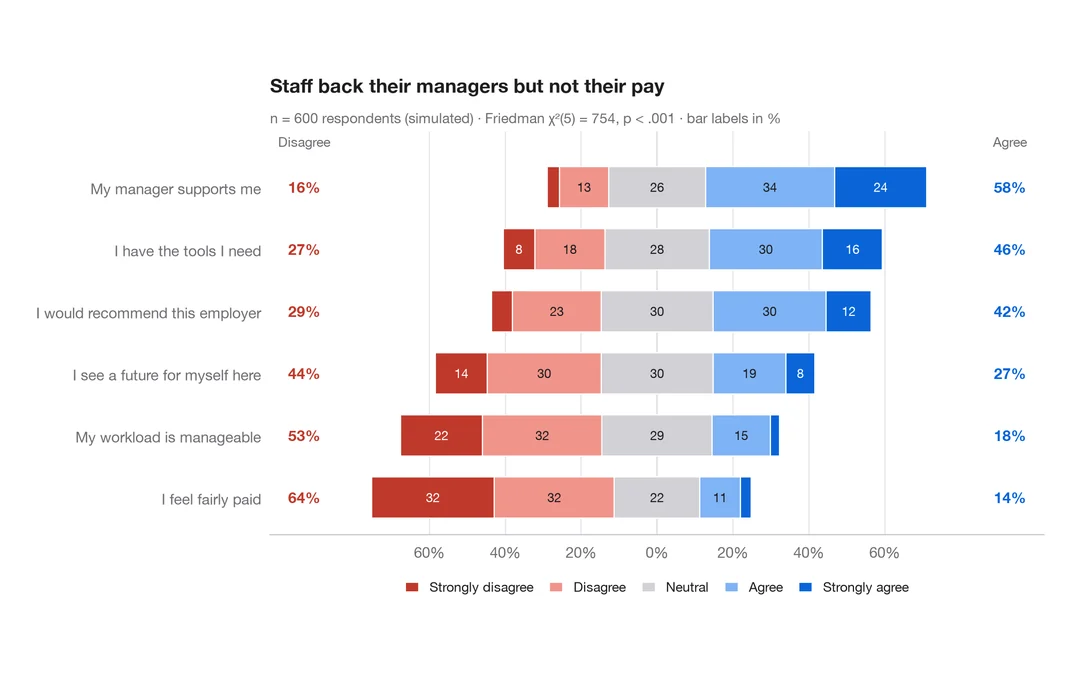
Graphique de Likert divergent
Items de Likert à cinq niveaux en barres empilées divergentes, centrées sur la réponse neutre.
ggstats::gglikert()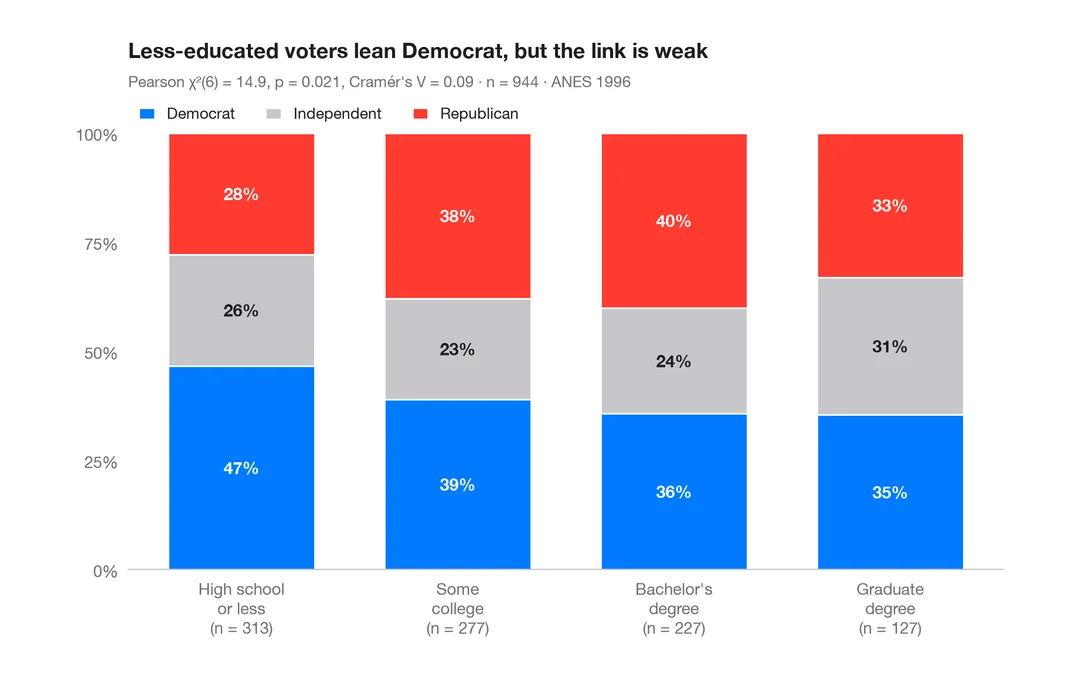
Proportions empilées par groupe
Barres empilées à 100 % avec pourcentages, n par barre, test du khi-deux et V de Cramér.
ggstatsplot::ggbarstats()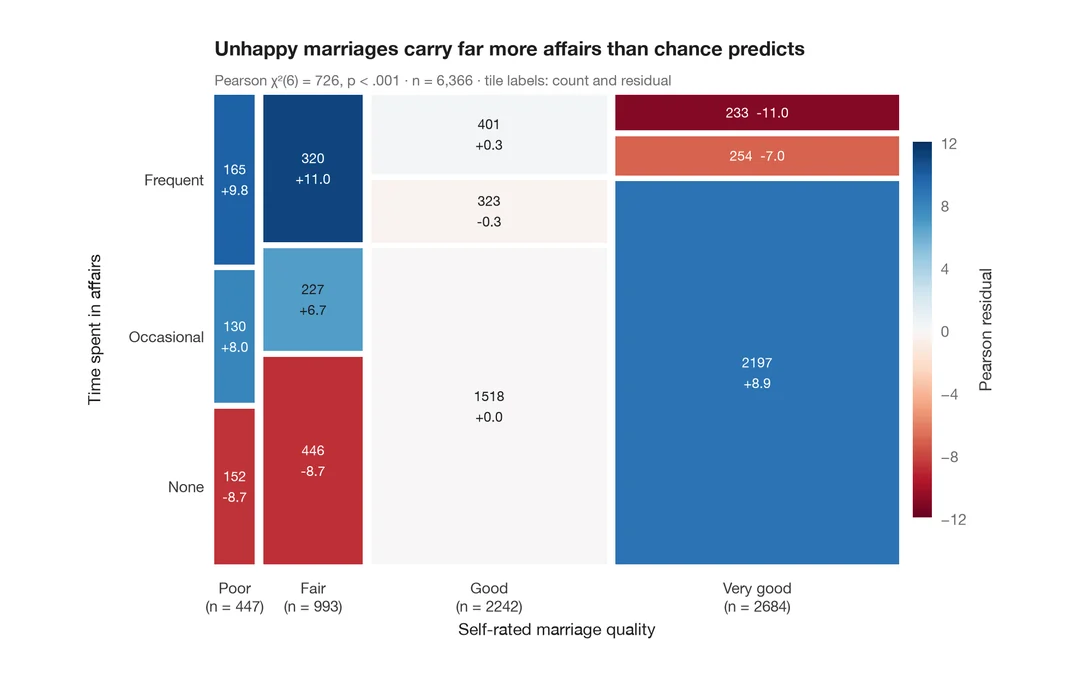
Diagramme en mosaïque avec résidus de Pearson
Aires des tuiles proportionnelles aux effectifs, colorées selon les résidus de Pearson par rapport à l'indépendance.
vcd::mosaic(shade = TRUE)