Cascade SHAP pour une prédiction
Comment chaque caractéristique déplace les résultats prédits en mathématiques d'un district scolaire en difficulté, de la moyenne jusqu'à la sortie du modèle.
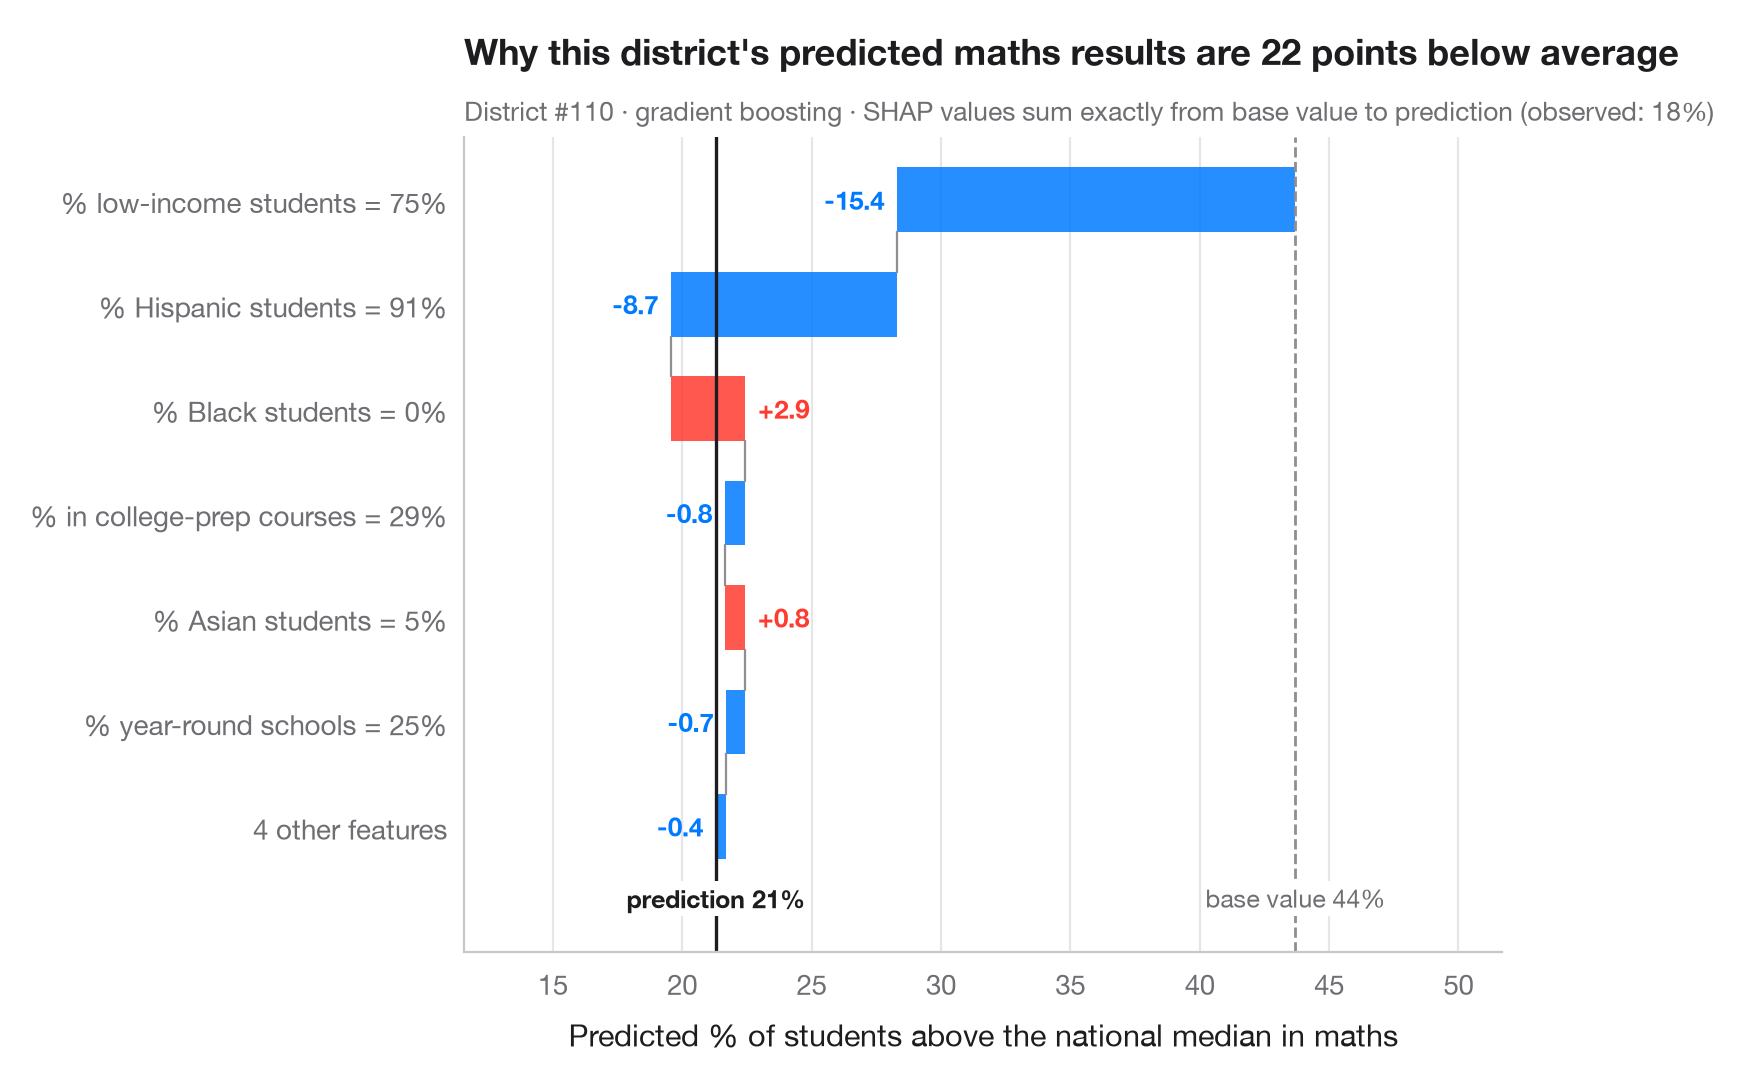
Les graphiques globaux décrivent le modèle ; une cascade explique une prédiction. Elle part de la valeur de base — la prédiction moyenne du modèle sur les données — et ajoute la valeur SHAP de chaque variable, la plus grande d'abord, jusqu'à la prédiction de ce district. Les barres rouges poussent la prédiction vers le haut, les bleues la tirent vers le bas ; les plus petites contributions sont regroupées en une barre pour garder le graphique lisible. Les valeurs SHAP étant additives, les barres somment toujours exactement l'écart entre la valeur de base et la prédiction.
C'est le graphique à montrer quand un cas particulier doit être expliqué — un district signalé pour un soutien, un prêt, une demande de prestation. Il explique ce qu'a fait le modèle, pas pourquoi le résultat se produit. Les données sont les 303 districts scolaires californiens du test STAR de 1998, fournis avec statsmodels (sm.datasets.star98) ; la variable à prédire est la part des élèves au-dessus de la médiane nationale en mathématiques, à partir de dix caractéristiques des districts. Le modèle est un gradient boosting ; les valeurs SHAP viennent de shap.TreeExplainer. Le district présenté est en difficulté (prédit plus de 20 points sous la valeur de base), choisi parce que son explication tire dans les deux sens.
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import shap
import statsmodels.api as sm
from sklearn.ensemble import GradientBoostingRegressor

# Data: 303 California school districts; outcome = % of students above the national median in maths
d = sm.datasets.star98.load_pandas().data
y = 100 * d["NABOVE"] / (d["NABOVE"] + d["NBELOW"])
names = {"LOWINC": "% low-income students", "PERASIAN": "% Asian students", "PERBLACK": "% Black students",
         "PERHISP": "% Hispanic students", "AVYRSEXP": "Teacher experience (years)",
         "AVSALK": "Teacher salary ($000)", "PERSPENK": "Spending per pupil ($000)",
         "PTRATIO": "Pupils per teacher", "PCTAF": "% in college-prep courses",
         "PCTYRRND": "% year-round schools"}
X = d[list(names)]
fmt = {"LOWINC": "{:.0f}%", "PERASIAN": "{:.0f}%", "PERBLACK": "{:.0f}%", "PERHISP": "{:.0f}%",
       "AVYRSEXP": "{:.1f}", "AVSALK": "{:.1f}", "PERSPENK": "{:.2f}", "PTRATIO": "{:.1f}",
       "PCTAF": "{:.0f}%", "PCTYRRND": "{:.0f}%"}
model = GradientBoostingRegressor(learning_rate=0.05, n_estimators=300, max_depth=2,
                                  subsample=0.8, random_state=0).fit(X, y)

explainer = shap.TreeExplainer(model)
base = float(np.ravel(explainer.expected_value)[0])
all_sv = explainer.shap_values(X)
# A struggling district whose explanation has pushes in both directions
low = np.where(all_sv.sum(axis=1) < -20)[0]
p = int(low[np.argmax(all_sv[low].max(axis=1))])
sv = all_sv[p]

# Largest contributions first; pool the rest
k = 6
idx = np.argsort(np.abs(sv))[::-1]
top, rest = idx[:k], idx[k:]
labels = [f"{names[X.columns[j]]} = {fmt[X.columns[j]].format(X.iloc[p, j])}" for j in top]
values = list(sv[top])
if len(rest):
    labels.append(f"{len(rest)} other features")
    values.append(sv[rest].sum())

fig, ax = plt.subplots(figsize=(8, 5.2))
start = base
for i, (lab, v) in enumerate(zip(labels, values)):
    c = "#FF3B30" if v > 0 else "#007AFF"
    ax.barh(i, v, left=start, color=c, alpha=0.85, height=0.62)
    ax.text(start + v + (0.5 if v > 0 else -0.5), i, f"{v:+.1f}", va="center",
            ha="left" if v > 0 else "right", fontsize=9.5, color=c, fontweight="semibold")
    if i < len(values) - 1:
        ax.plot([start + v] * 2, [i + 0.31, i + 0.69], color="#8E8E93", lw=0.8)
    start += v
ax.axvline(base, color="#8E8E93", ls="--", lw=1)
ax.axvline(start, color="#1d1d1f", lw=1.2)
bottom = len(labels) - 0.45
ax.text(base, bottom, f"base value {base:.0f}%", ha="center", va="top", fontsize=9, color="#6E6E73",
        bbox=dict(fc="white", ec="none", pad=1))
ax.text(start, bottom, f"prediction {start:.0f}%", ha="center", va="top", fontsize=9,
        color="#1d1d1f", fontweight="semibold", bbox=dict(fc="white", ec="none", pad=1))
ax.set_yticks(range(len(labels)), labels)
ax.set_ylim(len(labels) + 0.2, -0.6)
lo_x = min(base, *(base + np.cumsum(values)))
ax.set_xlim(lo_x - 8, max(base, *(base + np.cumsum(values))) + 8)
ax.set_xlabel("Predicted % of students above the national median in maths")
ax.grid(axis="x"); ax.grid(axis="y", visible=False)
ax.set_title(f"Why this district's predicted maths results are {base - start:.0f} points below average", pad=26)
ax.text(0, 1.02, f"District #{p} · gradient boosting · SHAP values sum exactly from base value to prediction "
        f"(observed: {y.iloc[p]:.0f}%)", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- California STAR test results, 1998 (303 school districts). Gill, J. (2001). Generalized Linear Models: A Unified Approach (Quantitative Applications in the Social Sciences, No. 134). Sage. https://www.statsmodels.org/stable/datasets/generated/star98.html
Original data from the California Department of Education's Standardized Testing and Reporting (STAR) program, 1998. Subset distributed with statsmodels (sm.datasets.star98) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). SHAP waterfall for one prediction. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/machine-learning/shap-waterfall/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Apprentissage automatique

Matrice de confusion avec indicateurs
Dans quelle mesure une régression logistique prédit qui a voté Dole en 1996 — matrice de confusion hors échantillon, avec effectifs et parts par ligne, et intervalles bootstrap pour les principaux indicateurs.
yardstick::conf_mat() + autoplot()
Courbes précision–rappel
Courbes précision–rappel hors échantillon pour deux classifieurs qui prédisent quelles femmes mariées déclarent une liaison, avec précision moyenne et référence sans compétence.
yardstick::pr_curve() + autoplot()
Courbe d'apprentissage
Exactitude d'entraînement et en validation croisée à mesure que l'échantillon d'entraînement grandit, pour deux modèles qui prédisent quelles femmes mariées déclarent une liaison.
caret::learning_curve_dat() + ggplot()