Comparaison de modèles emboîtés
Coefficients de trois régressions emboîtées des résultats en mathématiques des districts, côte à côte, pour voir comment les estimations bougent à mesure que des blocs sont ajoutés.
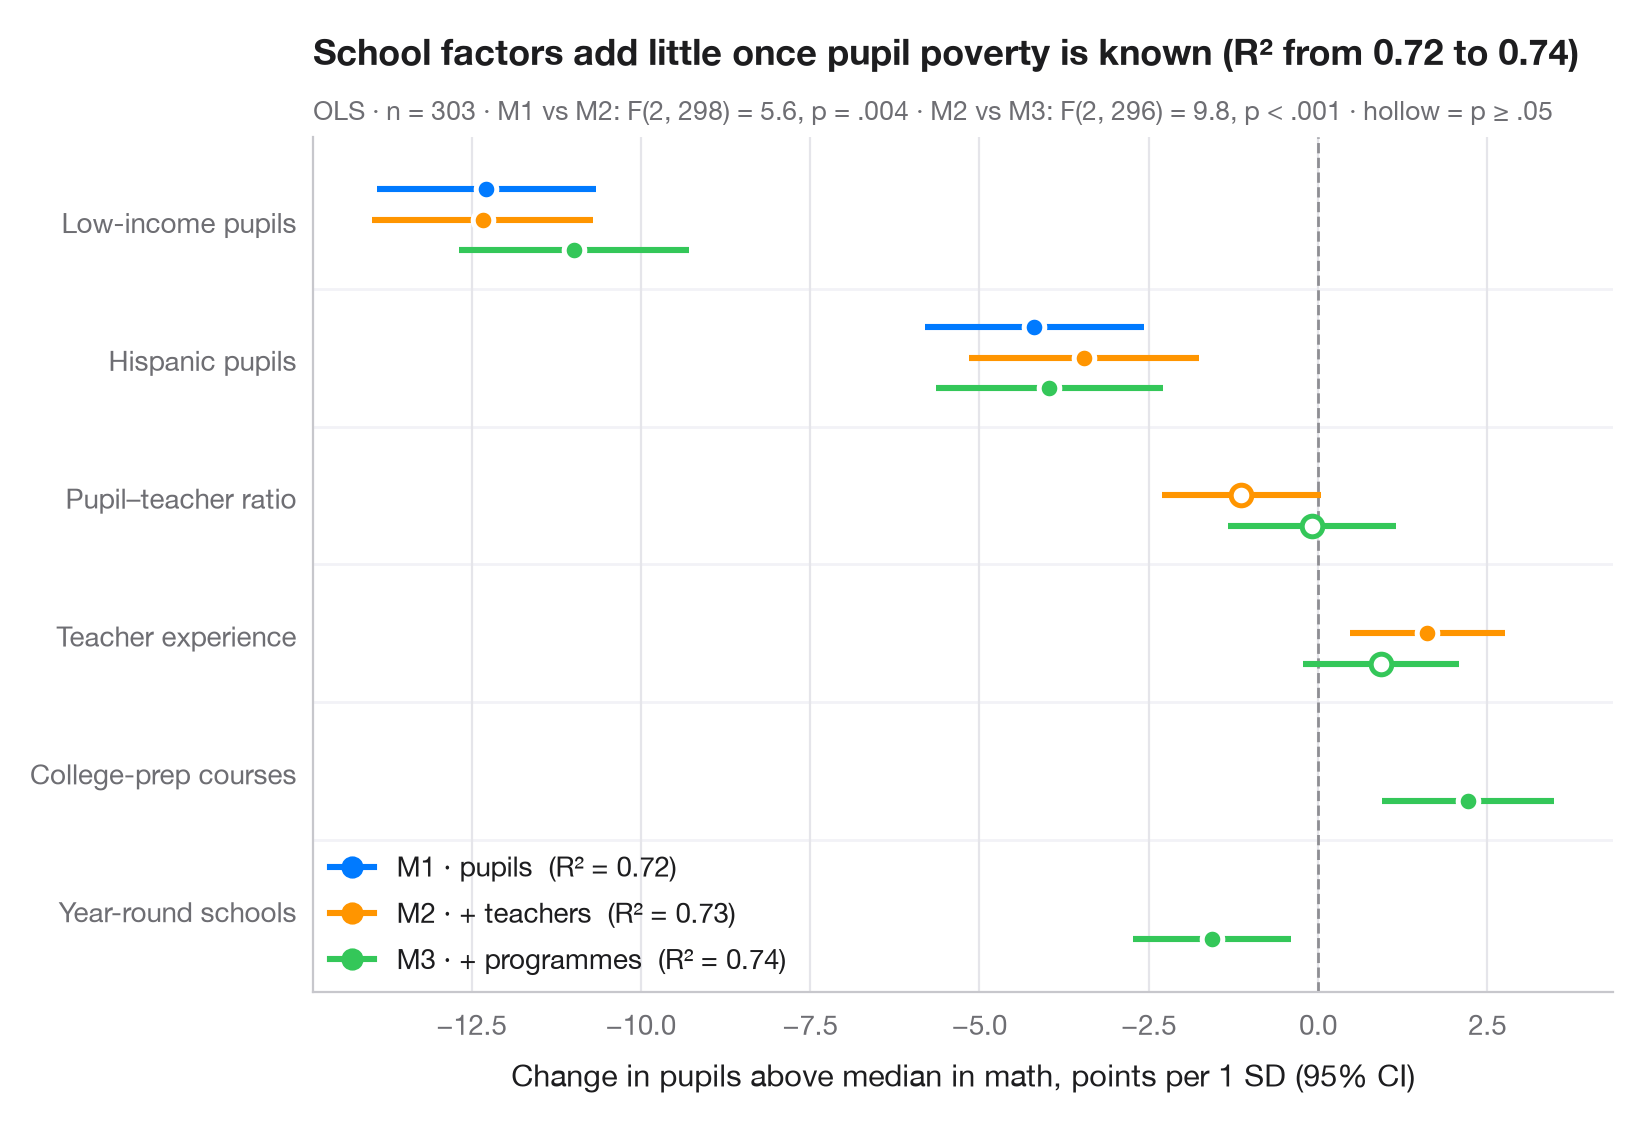
Lorsque les covariables sont ajoutées bloc par bloc, la question intéressante n'est souvent pas de savoir quels termes sont significatifs, mais comment les estimations se déplacent. Ici, chaque terme occupe une ligne et chaque modèle un point avec intervalle légèrement décalé, ce qui permet de suivre un coefficient à mesure que le modèle s'enrichit. Les marqueurs creux ne sont pas significatifs au seuil de 5 %. Le sous-titre compare les modèles à l'aide du R² et des tests F des blocs ajoutés.
Les données sont les 303 districts scolaires californiens du test STAR98 fournis avec statsmodels (sm.datasets.star98). La variable expliquée est la part d'élèves au-dessus de la médiane nationale en mathématiques, NABOVE / (NABOVE + NBELOW), en pourcentage. M1 contient la composition des élèves (élèves à faible revenu et hispaniques), M2 ajoute les enseignants (ratio élèves-enseignant, expérience moyenne) et M3 ajoute les programmes (cours préparatoires à l'université, écoles à calendrier annuel continu). Les prédicteurs sont standardisés : chaque coefficient est la variation en points de pourcentage par écart type. Les blocs sont conjointement significatifs, mais le R² bouge à peine et le coefficient du faible revenu reste proche de −12 dans tous les modèles. Les modèles sont ajustés avec smf.ols() et comparés avec anova_lm().
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf
from statsmodels.stats.anova import anova_lm

# Data: math results in 303 California school districts; standardise predictors (z-scores)
df = sm.datasets.star98.load_pandas().data
df["math"] = 100 * df.NABOVE / (df.NABOVE + df.NBELOW)
X = ["LOWINC", "PERHISP", "PTRATIO", "AVYRSEXP", "PCTAF", "PCTYRRND"]
df[X] = (df[X] - df[X].mean()) / df[X].std()

# Three nested models, each adding a block of predictors
formulas = {"M1 · pupils": "math ~ LOWINC + PERHISP",
            "M2 · + teachers": "math ~ LOWINC + PERHISP + PTRATIO + AVYRSEXP",
            "M3 · + programmes": "math ~ LOWINC + PERHISP + PTRATIO + AVYRSEXP + PCTAF + PCTYRRND"}
fits = {name: smf.ols(f, data=df).fit() for name, f in formulas.items()}
f_tests = anova_lm(*fits.values())

labels = {"LOWINC": "Low-income pupils", "PERHISP": "Hispanic pupils",
          "PTRATIO": "Pupil–teacher ratio", "AVYRSEXP": "Teacher experience",
          "PCTAF": "College-prep courses", "PCTYRRND": "Year-round schools"}
terms = list(labels)[::-1]
palette = ["#007AFF", "#FF9500", "#34C759"]

fig, ax = plt.subplots(figsize=(8, 5.4))
ax.axvline(0, color="#8E8E93", lw=1, ls="--", zorder=1)
for k, ((name, m), c) in enumerate(zip(fits.items(), palette)):
    offset = (1 - k) * 0.22                      # dodge: first model on top
    ci = m.conf_int()
    for i, t in enumerate(terms):
        if t not in m.params:
            continue
        sig = m.pvalues[t] < 0.05
        ax.hlines(i + offset, ci.loc[t, 0], ci.loc[t, 1], color=c, lw=2.2, zorder=2)
        ax.scatter(m.params[t], i + offset, s=55, zorder=3, lw=1.8,
                   color=c if sig else "white", edgecolor=c if not sig else "white")
    ax.plot([], [], "o-", color=c, lw=2.2, ms=7,
            label=f"{name}  (R² = {m.rsquared:.2f})")

for i in range(len(terms) - 1):                  # thin separators between terms
    ax.axhline(i + 0.5, color="#F2F2F7", lw=1, zorder=0)
ax.set_yticks(range(len(terms)), [labels[t] for t in terms])
ax.set_ylim(-0.6, len(terms) - 0.4)
ax.grid(axis="x"); ax.grid(axis="y", visible=False)
ax.set_xlabel("Change in pupils above median in math, points per 1 SD (95% CI)")
ax.legend(loc="lower left", handlelength=1.6, borderaxespad=0.2)
r2 = [m.rsquared for m in fits.values()]
ax.set_title(f"School factors add little once pupil poverty is known (R² from {r2[0]:.2f} to {r2[-1]:.2f})", pad=26)
fmt_p = lambda p: "p < .001" if p < .001 else f"p = {p:.3f}".replace("0.", ".")
blocks = [f"M{j} vs M{j + 1}: F({f_tests.df_diff[j]:.0f}, {f_tests.df_resid[j]:.0f}) = "
          f"{f_tests.F[j]:.1f}, {fmt_p(f_tests['Pr(>F)'][j])}" for j in (1, 2)]
ax.text(0, 1.02, f"OLS · n = {int(fits['M1 · pupils'].nobs)} · " + " · ".join(blocks)
        + " · hollow = p ≥ .05", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- California STAR test results, 1998 (303 school districts). Gill, J. (2001). Generalized Linear Models: A Unified Approach (Quantitative Applications in the Social Sciences, No. 134). Sage. https://www.statsmodels.org/stable/datasets/generated/star98.html
Original data from the California Department of Education's Standardized Testing and Reporting (STAR) program, 1998. Subset distributed with statsmodels (sm.datasets.star98) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Comparing nested models. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/regression-models/compare-models/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Modèles de régression

Graphique des coefficients
Estimations de régression avec intervalles de confiance à 95 %, une ligne par terme.
ggstats::ggcoef_model()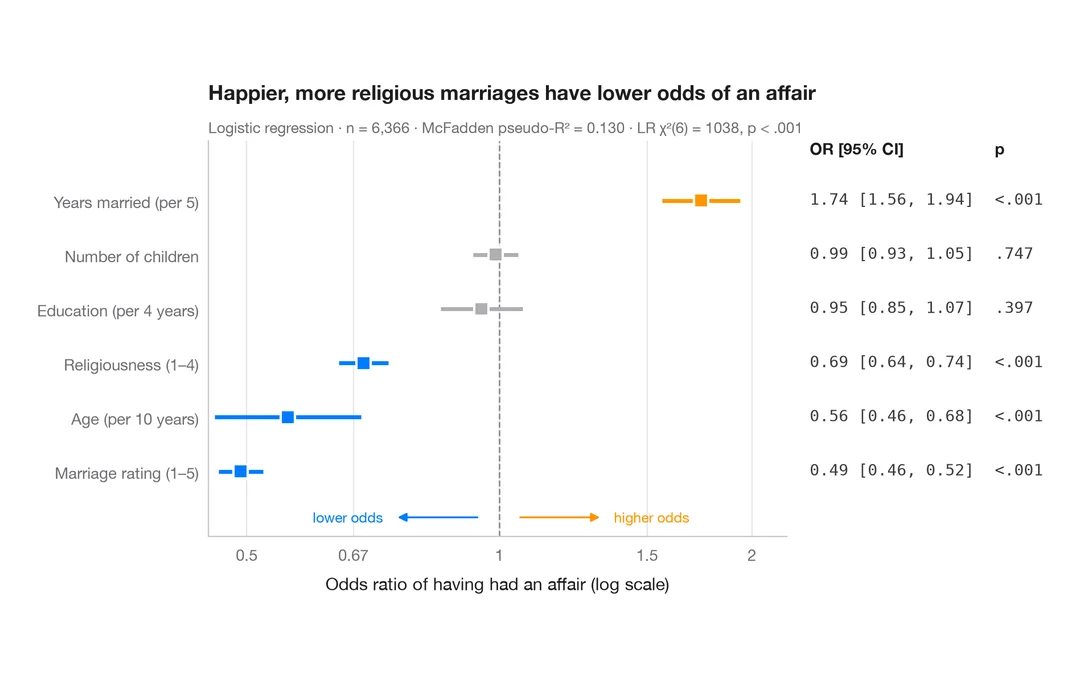
Graphique en forêt des rapports de cotes
Rapports de cotes d'une régression logistique sur échelle logarithmique, accompagnés d'un tableau RC [IC à 95 %].
ggstats::ggcoef_model(exponentiate = TRUE)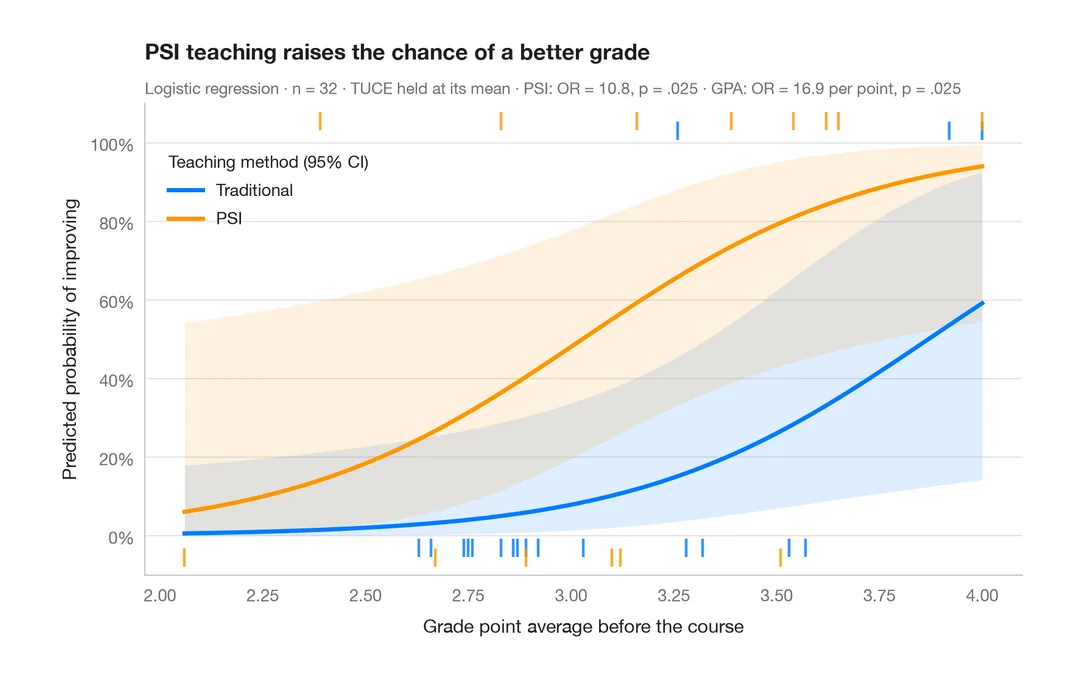
Probabilités prédites
Courbes de probabilité issues du modèle, avec rubans d'IC à 95 %, selon un prédicteur et par groupe.
ggeffects::ggpredict() / marginaleffects::plot_predictions()