Graphique en forêt des rapports de cotes
Rapports de cotes d'une régression logistique sur échelle logarithmique, accompagnés d'un tableau RC [IC à 95 %].
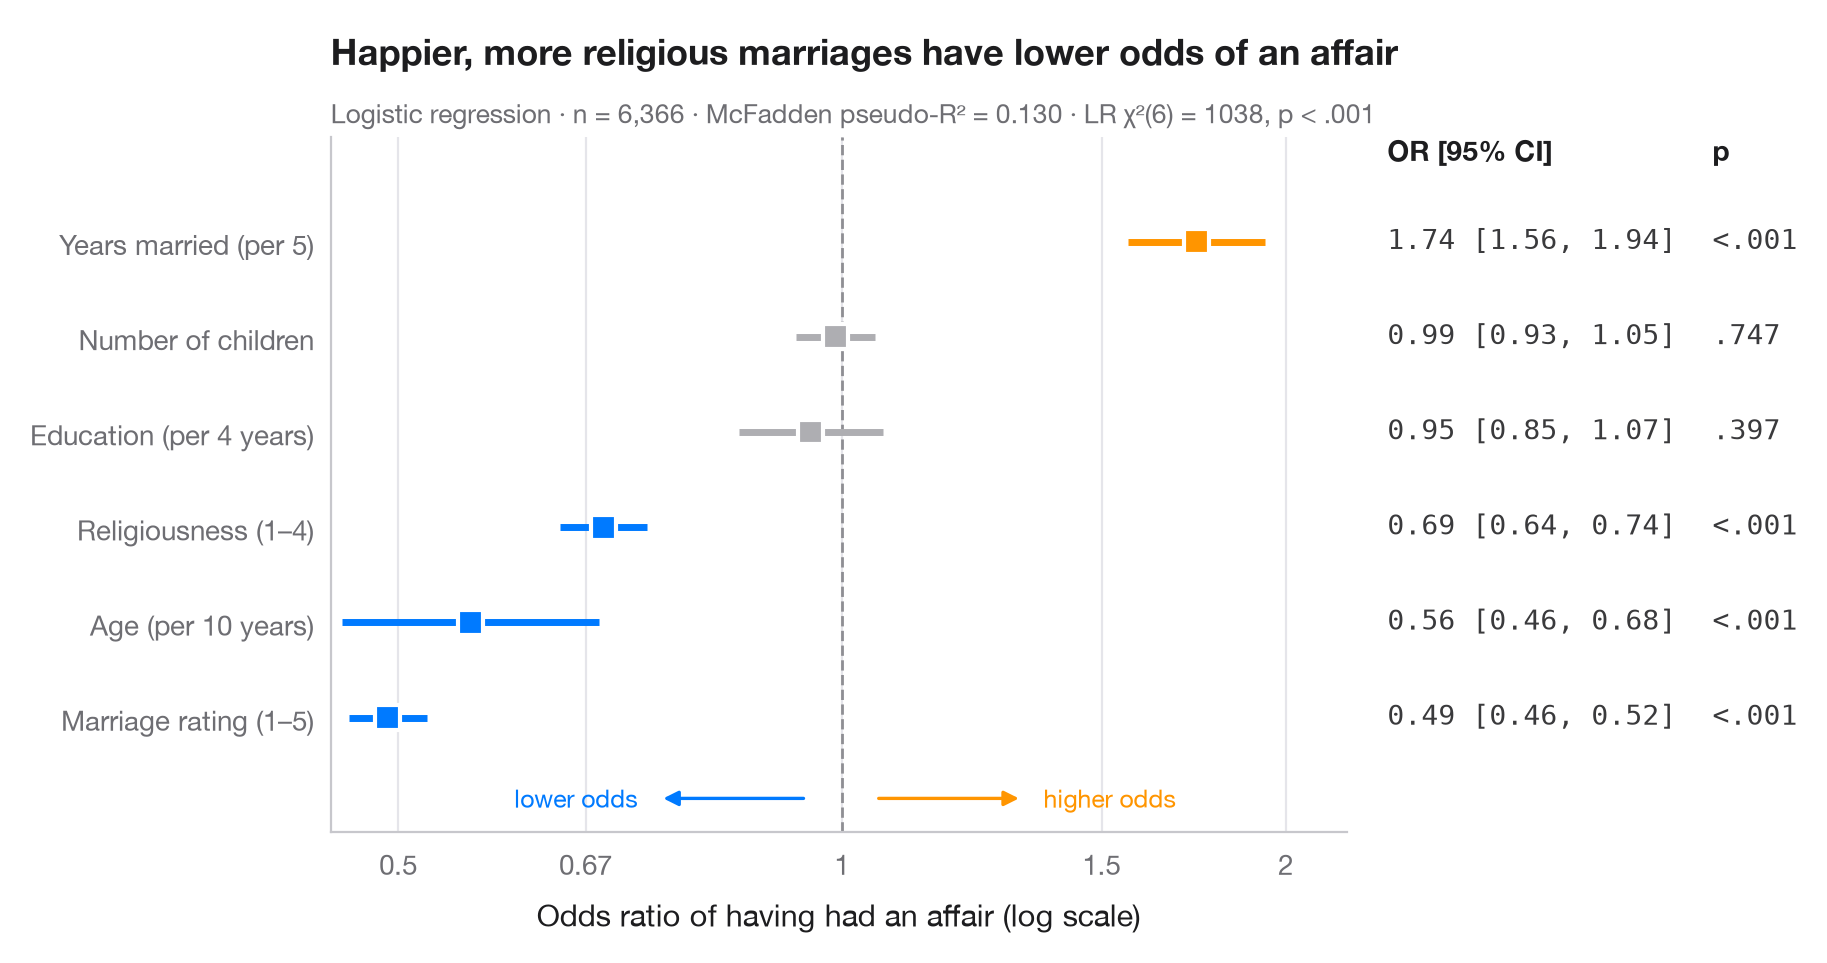
Les coefficients logistiques sont des log-cotes ; une fois exponentiés, ils deviennent des rapports de cotes. Chaque point est la variation multiplicative de la cote de l'événement pour une variation d'une unité du prédicteur, le segment est son intervalle de confiance à 95 %, et la ligne en tirets à RC = 1 signifie « aucun effet ». Comme les rapports sont symétriques sur une échelle logarithmique (0,5 est aussi fort que 2), l'axe des x est logarithmique. La colonne de droite reprend les valeurs, comme le tableau d'un article.
Les données sont l'enquête Redbook de 1974 auprès de 6 366 femmes mariées, fournie avec statsmodels (sm.datasets.fair). La variable réponse indique si la répondante a déclaré au moins une relation extraconjugale ; le modèle est ajusté avec smf.logit() et les rapports de cotes sont les np.exp() de params et de conf_int().
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf
from matplotlib.ticker import FixedLocator, NullLocator

# Data: Fair's affairs survey; rescale a few predictors to meaningful units
df = sm.datasets.fair.load_pandas().data
df = df.assign(affair=(df.affairs > 0).astype(int), age10=df.age / 10,
               yrs5=df.yrs_married / 5, educ4=df.educ / 4)

model = smf.logit("affair ~ rate_marriage + religious + age10 + yrs5 + children + educ4",
                  data=df).fit(disp=False)

# Odds ratios with 95% CI (intercept dropped), sorted by effect
tab = np.exp(model.conf_int().drop("Intercept")).rename(columns={0: "low", 1: "high"})
tab = tab.assign(OR=np.exp(model.params), p=model.pvalues).sort_values("OR")
labels = {"rate_marriage": "Marriage rating (1–5)", "religious": "Religiousness (1–4)",
          "age10": "Age (per 10 years)", "yrs5": "Years married (per 5)",
          "children": "Number of children", "educ4": "Education (per 4 years)"}

fig, ax = plt.subplots(figsize=(8.6, 4.6))
y = np.arange(len(tab))
colors = np.where(tab["p"] < 0.05, np.where(tab["OR"] > 1, "#FF9500", "#007AFF"), "#AEAEB2")

ax.axvline(1, color="#8E8E93", lw=1, ls="--", zorder=1)
ax.hlines(y, tab["low"], tab["high"], color=colors, lw=2.5, zorder=2)
ax.scatter(tab["OR"], y, s=80, marker="s", color=colors, edgecolor="white", lw=1.5, zorder=3)

# Right-hand "table" column: OR [95% CI] and p-value
tr = ax.get_yaxis_transform()
top = len(tab) - 0.15
ax.text(1.04, top, "OR [95% CI]", transform=tr, fontsize=10, fontweight="semibold")
ax.text(1.36, top, "p", transform=tr, fontsize=10, fontweight="semibold")
for yi, (_, r) in zip(y, tab.iterrows()):
    ax.text(1.04, yi, f"{r.OR:.2f} [{r.low:.2f}, {r.high:.2f}]", transform=tr,
            va="center", fontsize=10, color="#3A3A3C", family="monospace")
    ax.text(1.36, yi, "<.001" if r.p < .001 else f"{r.p:.3f}".lstrip("0"), transform=tr,
            va="center", fontsize=10, color="#3A3A3C", family="monospace")

ax.set_xscale("log")
ax.xaxis.set_major_locator(FixedLocator([0.5, 0.67, 1, 1.5, 2]))
ax.xaxis.set_minor_locator(NullLocator())
ax.set_xticklabels(["0.5", "0.67", "1", "1.5", "2"])
ax.set_xlim(0.45, 2.2)
ax.set_yticks(y, [labels[t] for t in tab.index])
ax.set_ylim(-1.2, len(tab) + 0.1)
ax.grid(axis="x"); ax.grid(axis="y", visible=False)
ax.set_xlabel("Odds ratio of having had an affair (log scale)")
# Direction hints along the bottom of the panel
for x0, x1, txt, c in [(0.95, 0.75, "lower odds", "#007AFF"), (1.05, 1.33, "higher odds", "#FF9500")]:
    ax.annotate("", (x1, -0.85), (x0, -0.85), arrowprops=dict(arrowstyle="-|>", color=c, lw=1.2))
    ax.text(x1 * (0.97 if x1 < 1 else 1.03), -0.85, txt, color=c, fontsize=9, va="center",
            ha="right" if x1 < 1 else "left")
ax.set_title("Happier, more religious marriages have lower odds of an affair", pad=26)
ax.text(0, 1.02, f"Logistic regression · n = {int(model.nobs):,} · "
        f"McFadden pseudo-R² = {model.prsquared:.3f} · LR χ²({model.df_model:.0f}) = "
        f"{model.llr:.0f}, p < .001", transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Redbook survey of married women, 1974 (Fair's affairs data). Fair, R. C. (1978). A theory of extramarital affairs. Journal of Political Economy, 86(1), 45–61. https://doi.org/10.1086/260646
Data from the 1974 Redbook magazine survey; distributed with statsmodels (sm.datasets.fair) with the author's permission.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Odds-ratio forest plot. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/regression-models/odds-ratio-forest/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Modèles de régression

Graphique des coefficients
Estimations de régression avec intervalles de confiance à 95 %, une ligne par terme.
ggstats::ggcoef_model()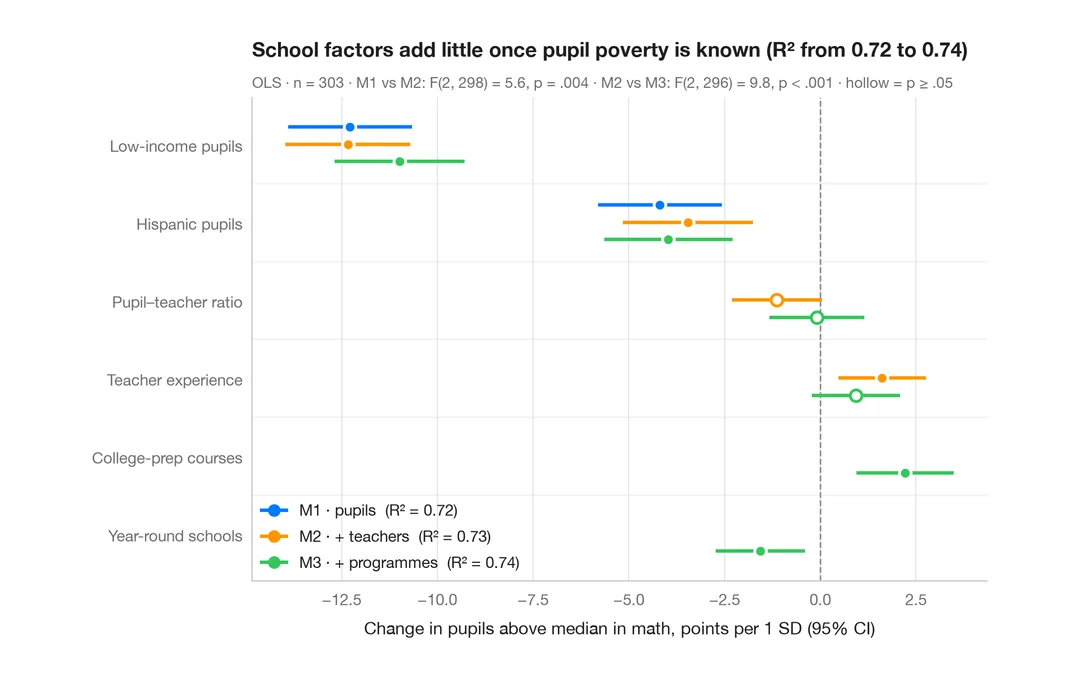
Comparaison de modèles emboîtés
Coefficients de trois régressions emboîtées des résultats en mathématiques des districts, côte à côte, pour voir comment les estimations bougent à mesure que des blocs sont ajoutés.
ggstats::ggcoef_compare()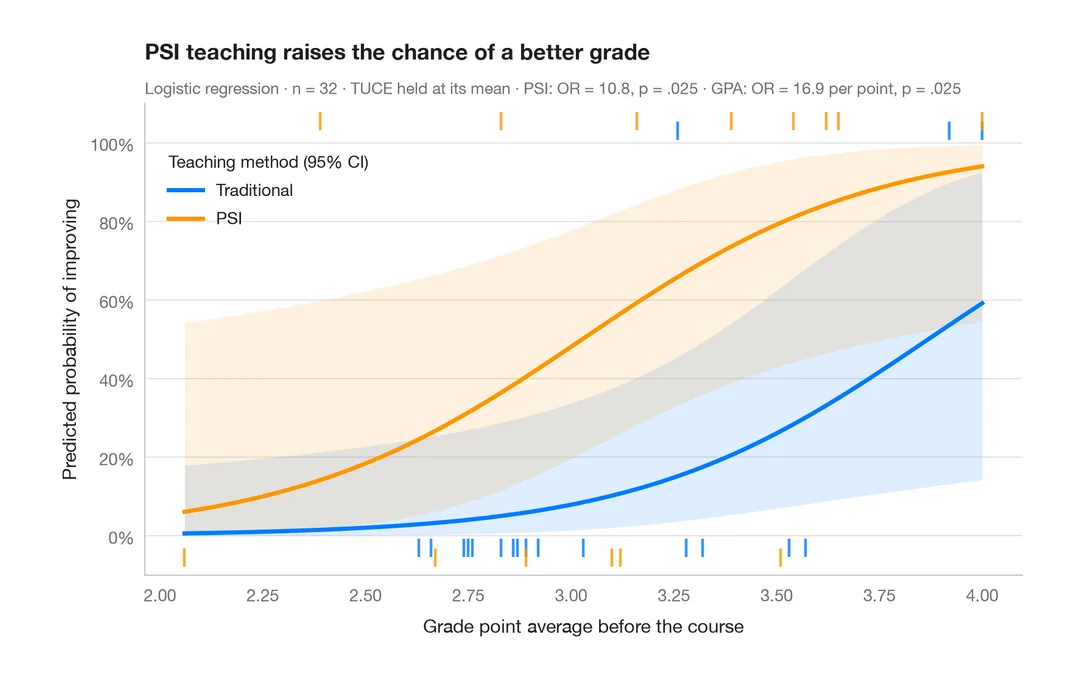
Probabilités prédites
Courbes de probabilité issues du modèle, avec rubans d'IC à 95 %, selon un prédicteur et par groupe.
ggeffects::ggpredict() / marginaleffects::plot_predictions()