Probabilités prédites
Courbes de probabilité issues du modèle, avec rubans d'IC à 95 %, selon un prédicteur et par groupe.
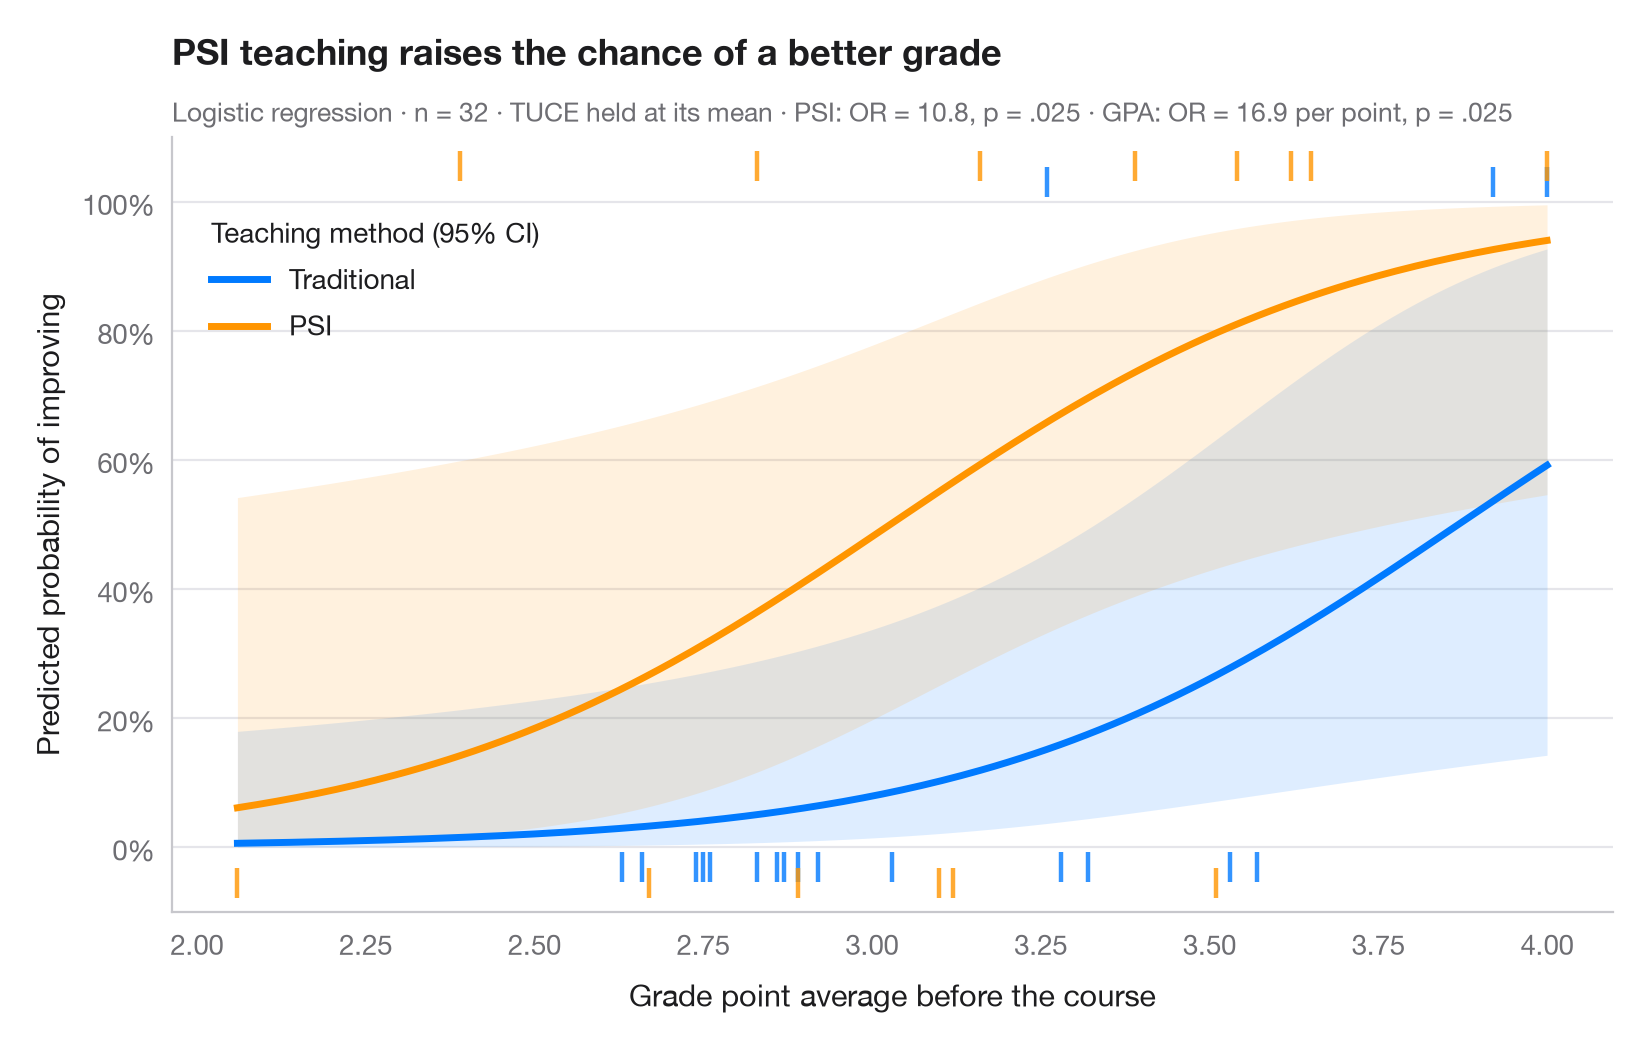
Les rapports de cotes sont difficiles à appréhender ; les probabilités, non. Ce graphique ramène un modèle logistique à l'échelle de la variable réponse : chaque courbe est la probabilité prédite de succès sur l'étendue d'un prédicteur continu, pour un niveau d'un facteur, les autres covariables étant fixées à leur moyenne. Les rubans sont des intervalles de confiance à 95 % calculés sur l'échelle logit puis retransformés, de sorte qu'ils restent dans [0, 1]. Les tirets marginaux montrent les étudiants observés — en haut s'ils ont progressé, en bas sinon.
Les données sont l'expérience de Spector & Mazzeo (1980) fournie avec statsmodels (sm.datasets.spector) : une nouvelle méthode d'enseignement (PSI) a-t-elle amélioré les notes, compte tenu de la moyenne cumulative (GPA) antérieure et d'un score de prétest (TUCE) ? Le modèle est un smf.glm() binomial ; les courbes proviennent de get_prediction().summary_frame().
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf

# Data: 32 students; GRADE = 1 if the grade improved after the course
df = sm.datasets.spector.load_pandas().data
model = smf.glm("GRADE ~ GPA + TUCE + C(PSI)", data=df, family=sm.families.Binomial()).fit()

# Prediction grid: GPA across its range, TUCE at its mean, both teaching methods
gpa = np.linspace(df.GPA.min(), df.GPA.max(), 200)
groups = {0: ("Traditional", "#007AFF"), 1: ("PSI", "#FF9500")}

fig, ax = plt.subplots(figsize=(8, 5))
for level, (name, c) in groups.items():
    grid = pd.DataFrame({"GPA": gpa, "TUCE": df.TUCE.mean(), "PSI": level})
    pred = model.get_prediction(grid).summary_frame(alpha=0.05)
    ax.fill_between(gpa, pred.mean_ci_lower, pred.mean_ci_upper, color=c, alpha=0.13, lw=0)
    ax.plot(gpa, pred["mean"], color=c, lw=2.5, label=name)
    # Rug of observations: improved (top) or not (bottom), slightly offset per group
    obs = df[df.PSI == level]
    y_rug = np.where(obs.GRADE == 1, 1.03 + 0.025 * level, -0.03 - 0.025 * level)
    ax.scatter(obs.GPA, y_rug, marker="|", s=110, lw=1.6, color=c, alpha=0.8, clip_on=False)

ax.legend(loc="upper left", title="Teaching method (95% CI)", alignment="left",
          bbox_to_anchor=(0.01, 0.93))
ax.set_ylim(-0.1, 1.1)
ax.set_yticks(np.linspace(0, 1, 6), [f"{v:.0%}" for v in np.linspace(0, 1, 6)])
ax.set_xlabel("Grade point average before the course")
ax.set_ylabel("Predicted probability of improving")
ax.set_title("PSI teaching raises the chance of a better grade", pad=26)
psi = "C(PSI)[T.1.0]"
fmt_p = lambda p: f"{p:.3f}".lstrip("0")
ax.text(0, 1.02, f"Logistic regression · n = {int(model.nobs)} · TUCE held at its mean · "
        f"PSI: OR = {np.exp(model.params[psi]):.1f}, p = {fmt_p(model.pvalues[psi])} · "
        f"GPA: OR = {np.exp(model.params['GPA']):.1f} per point, p = {fmt_p(model.pvalues['GPA'])}",
        transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- Spector and Mazzeo's teaching-method experiment (32 students). Spector, L. C., & Mazzeo, M. (1980). Probit analysis and economic education. Journal of Economic Education, 11(2), 37–44. https://www.statsmodels.org/stable/datasets/generated/spector.html
Obtained from W. Greene's Econometric Analysis web site with the original author's permission; distributed with statsmodels (sm.datasets.spector).
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Predicted probabilities. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/regression-models/predicted-probabilities/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Modèles de régression

Graphique des coefficients
Estimations de régression avec intervalles de confiance à 95 %, une ligne par terme.
ggstats::ggcoef_model()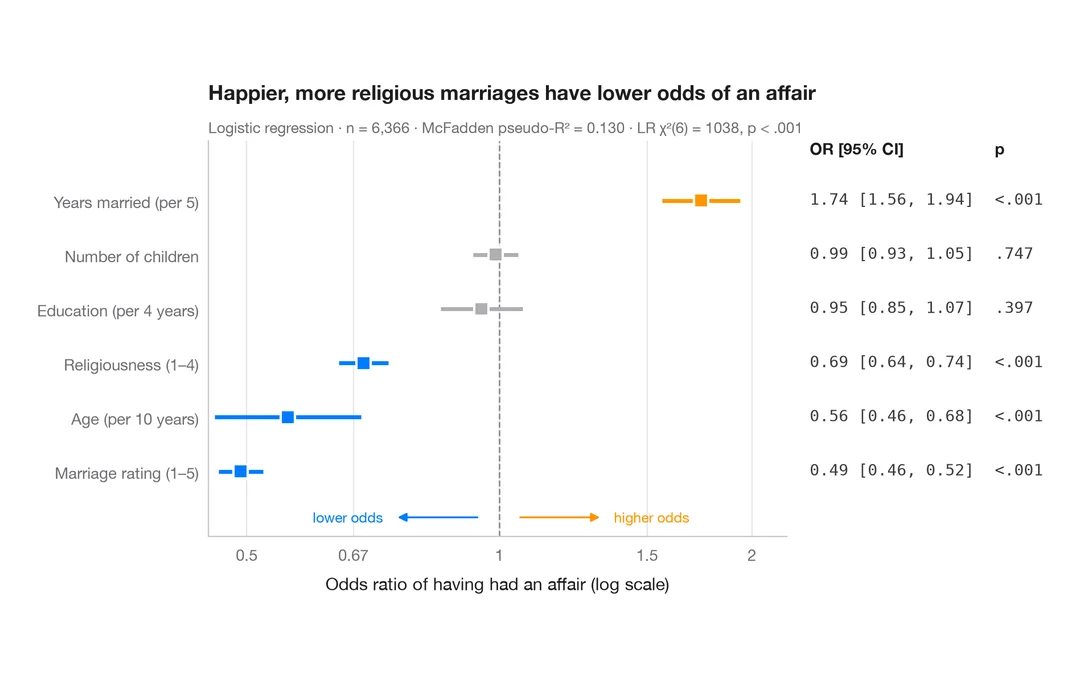
Graphique en forêt des rapports de cotes
Rapports de cotes d'une régression logistique sur échelle logarithmique, accompagnés d'un tableau RC [IC à 95 %].
ggstats::ggcoef_model(exponentiate = TRUE)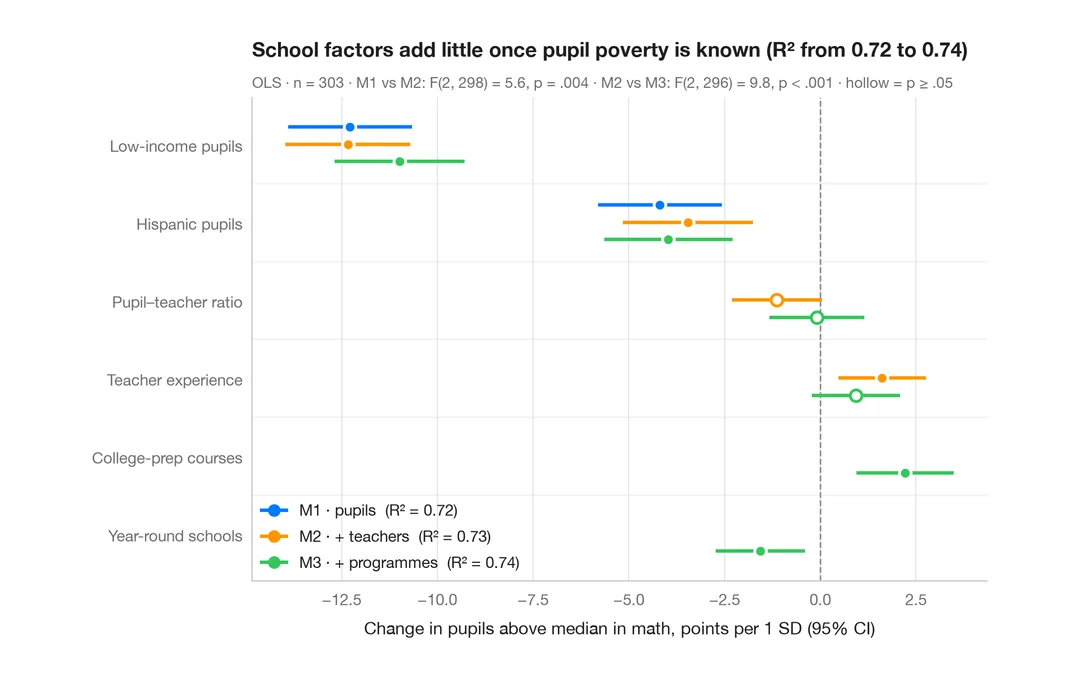
Comparaison de modèles emboîtés
Coefficients de trois régressions emboîtées des résultats en mathématiques des districts, côte à côte, pour voir comment les estimations bougent à mesure que des blocs sont ajoutés.
ggstats::ggcoef_compare()