Graphique d'influence
Résidus studentisés en fonction de l'effet de levier, avec des bulles proportionnelles à la distance de Cook.
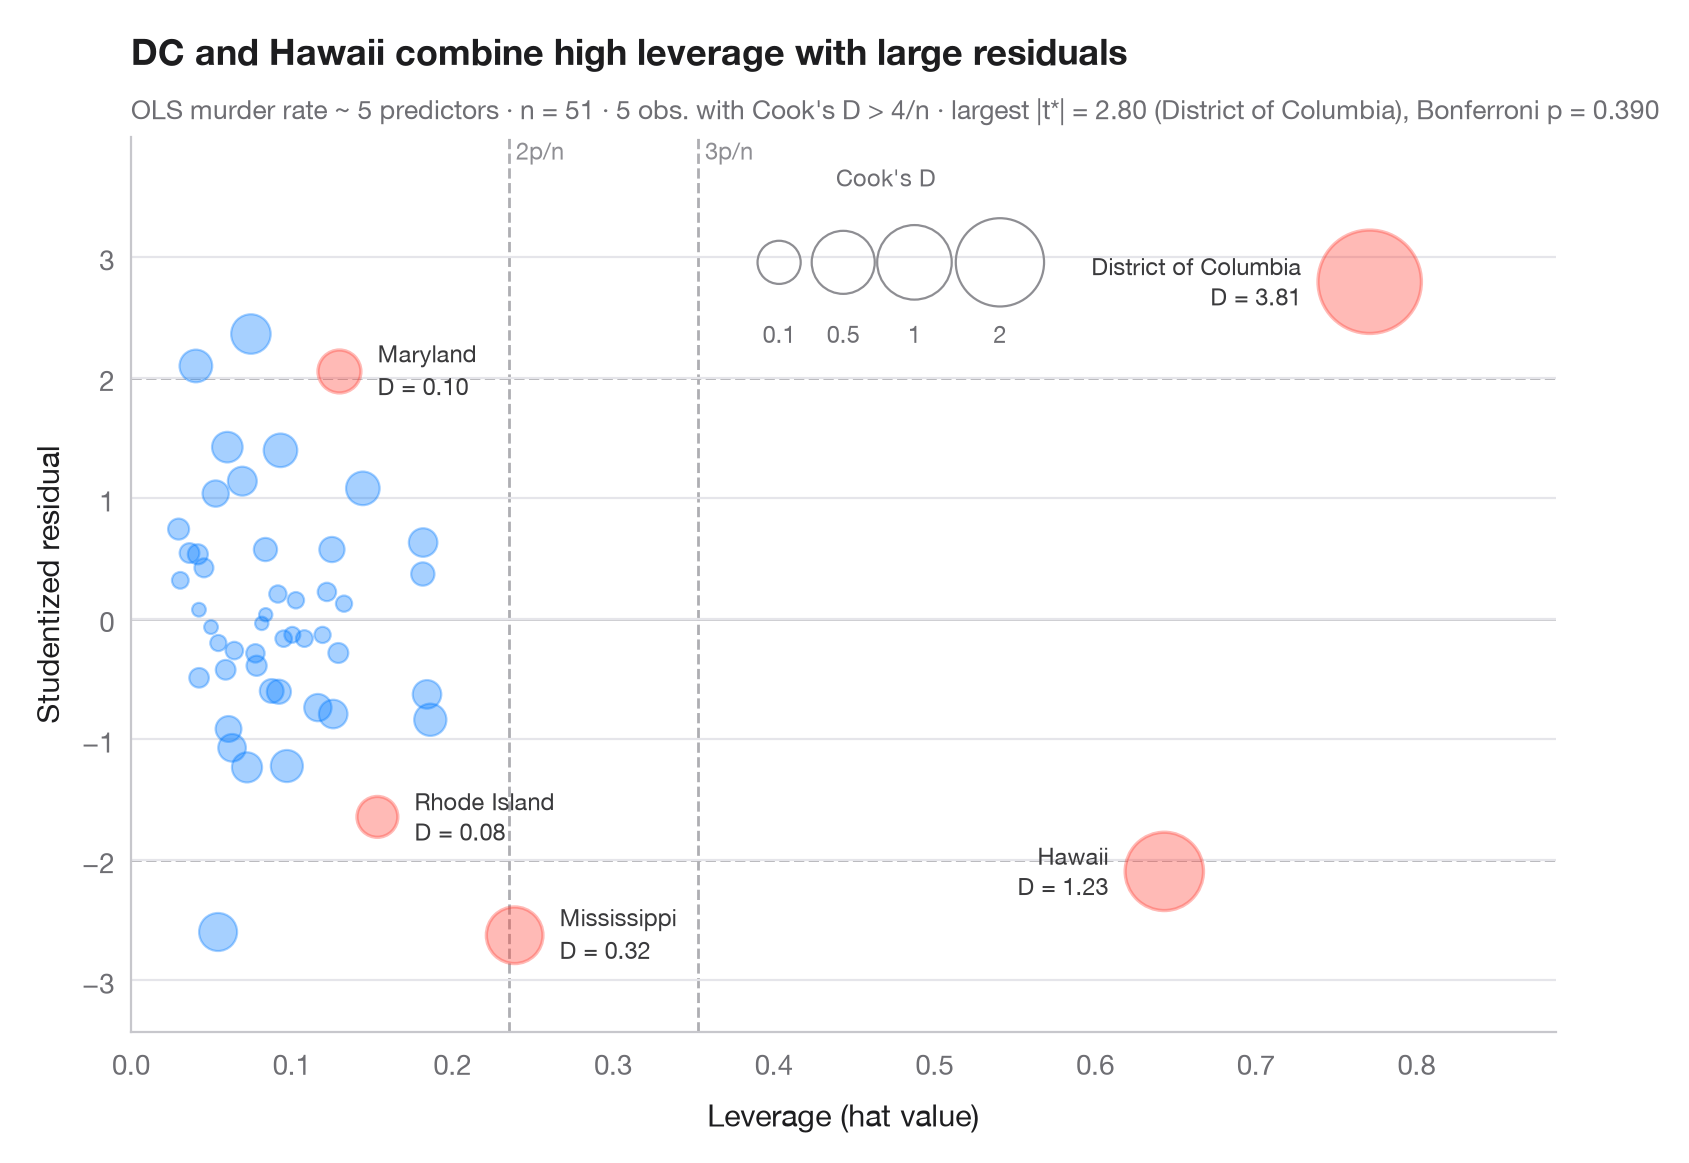
Une observation est influente lorsqu'elle est à la fois inhabituelle dans ses prédicteurs (fort effet de levier, axe des x) et mal ajustée (grand résidu studentisé, axe des y). L'aire des bulles croît avec la distance de Cook (∝ √D, pour que les valeurs extrêmes restent lisibles), qui combine les deux. Les lignes en tirets marquent les règles empiriques usuelles — effet de levier de 2p/n et 3p/n, résidus studentisés de ±2 — et les observations dont le D de Cook dépasse 4/n sont nommées et colorées.
Le modèle explique le taux d'homicides des 50 États américains + DC (sm.datasets.statecrime) par les MCO de statsmodels. Les résidus studentisés (par suppression), les valeurs du levier et les distances de Cook proviennent tous de model.get_influence() ; le sous-titre vérifie le plus grand résidu à l'aide d'un test de valeur aberrante de Bonferroni, comme le fait car::outlierTest().
Le code et le texte à l'intérieur des figures sont en anglais.
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf
from scipy import stats

df = sm.datasets.statecrime.load_pandas().data
model = smf.ols("murder ~ poverty + single + urban + hs_grad + white", data=df).fit()
infl = model.get_influence()
rstud, lev, cook = infl.resid_studentized_external, infl.hat_matrix_diag, infl.cooks_distance[0]
n, p = int(model.nobs), int(model.df_model + 1)
flag = cook > 4 / n

fig, ax = plt.subplots(figsize=(8.5, 5.6))

# Rule-of-thumb thresholds
for h in (2 * p / n, 3 * p / n):
    ax.axvline(h, color="#AEAEB2", lw=1, ls="--", zorder=0)
    ax.text(h, 1.0, f" {round(h * n / p)}p/n", transform=ax.get_xaxis_transform(),
            fontsize=8.5, color="#8E8E93", va="top")
for r in (-2, 0, 2):
    ax.axhline(r, color="#AEAEB2" if r else "#C7C7CC", lw=1, ls="--" if r else "-", zorder=0)

# Bubbles: area proportional to √Cook's D (keeps extreme points readable)
area = lambda d: 20 + 700 * np.sqrt(d)
size = area(cook)
ax.scatter(lev[~flag], rstud[~flag], s=size[~flag], color="#007AFF", alpha=0.35,
           edgecolor="#007AFF", lw=0.8)
ax.scatter(lev[flag], rstud[flag], s=size[flag], color="#FF3B30", alpha=0.35,
           edgecolor="#FF3B30", lw=1.2)
for i in np.flatnonzero(flag):
    right = lev[i] > 0.5                          # far-right points: label on the left
    ax.annotate(f"{df.index[i]}\nD = {cook[i]:.2f}", (lev[i], rstud[i]),
                xytext=((-1 if right else 1) * (np.sqrt(size[i]) / 2 + 6), 0),
                textcoords="offset points", ha="right" if right else "left", va="center",
                fontsize=8.5, color="#3A3A3C", linespacing=1.1)

# Bubble-size key
for d, x in zip((0.1, 0.5, 1, 2), (0.455, 0.50, 0.55, 0.61)):
    ax.scatter(x, 0.86, s=area(d), transform=ax.transAxes, color="none",
               edgecolor="#8E8E93", lw=0.8)
    ax.text(x, 0.77, f"{d:g}", transform=ax.transAxes, ha="center", fontsize=8.5, color="#6E6E73")
ax.text(0.53, 0.97, "Cook's D", transform=ax.transAxes, ha="center", va="top",
        fontsize=8.5, color="#6E6E73")

ax.set_ylim(rstud.min() - 0.8, rstud.max() + 1.2)
ax.set_xlim(0, lev.max() * 1.15)
ax.set_xlabel("Leverage (hat value)")
ax.set_ylabel("Studentized residual")
ax.set_title("DC and Hawaii combine high leverage with large residuals", pad=26)

# Bonferroni outlier test on the largest |studentized residual|
k = np.argmax(np.abs(rstud))
p_bonf = min(1, n * 2 * stats.t.sf(abs(rstud[k]), model.df_resid - 1))
ax.text(0, 1.02, f"OLS murder rate ~ 5 predictors · n = {n} · {flag.sum()} obs. with Cook's D > 4/n · "
        f"largest |t*| = {abs(rstud[k]):.2f} ({df.index[k]}), Bonferroni p = {p_bonf:.3f}",
        transform=ax.transAxes, fontsize=9.5, color="#6E6E73")
plt.show()
Les figures utilisent le style PyStatlas (facultatif) : ajoutez plt.style.use("pystatlas.mplstyle") pour obtenir exactement le même rendu.
Source des données
- US state crime and social indicators, 2009. U.S. Census Bureau. Statistical Abstract of the United States, state tables for 2009 (crime rates from the FBI Uniform Crime Reporting program). https://www.statsmodels.org/stable/datasets/generated/statecrime.html
Compiled for statsmodels (sm.datasets.statecrime); public domain. See the statsmodels page for each variable's table and footnotes.
Les exemples illustrent des méthodes statistiques. Leurs titres décrivent ce que chaque figure montre dans ces données précises — souvent un échantillon restreint, daté ou partiel —, et non la position de l'auteur sur la question de fond. Pour l'interprétation, le contexte et la qualité des données, reportez-vous aux sources originales citées ici.
Comment citer
PyStatlas est créé et maintenu par Thierry Warin. S'il vous a été utile dans vos travaux, merci de le citer.
Warin, T. (2026). Influence plot. In PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/model-diagnostics/influence-plot/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}Plus dans Diagnostics de modèles
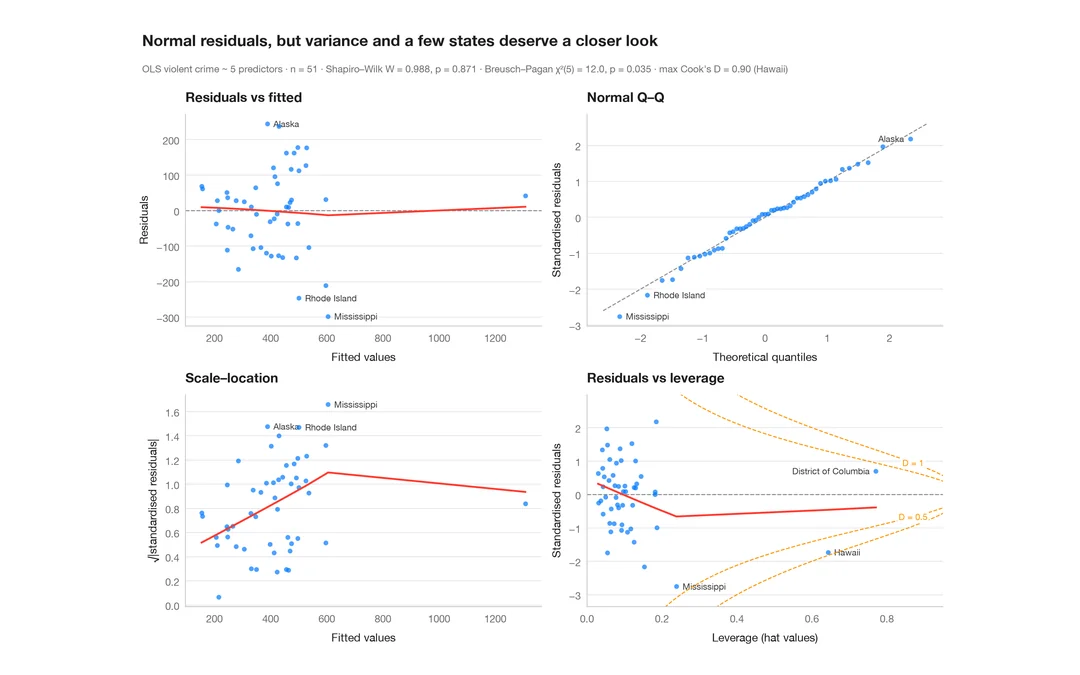
Diagnostics des résidus
Le panneau classique 2 × 2 d'un modèle linéaire — linéarité, normalité, variance, effet de levier.
plot(lm) / performance::check_model()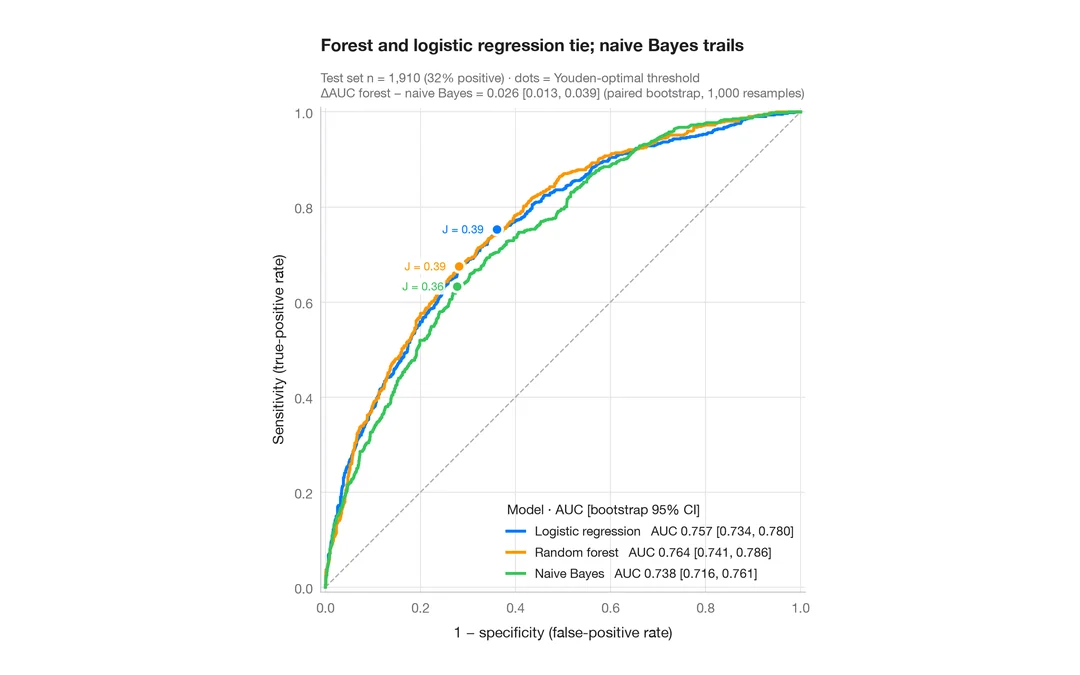
Courbes ROC
Trois classificateurs comparés par courbe ROC, AUC avec IC à 95 % par bootstrap et point de Youden.
pROC::ggroc() / pROC::ci.auc()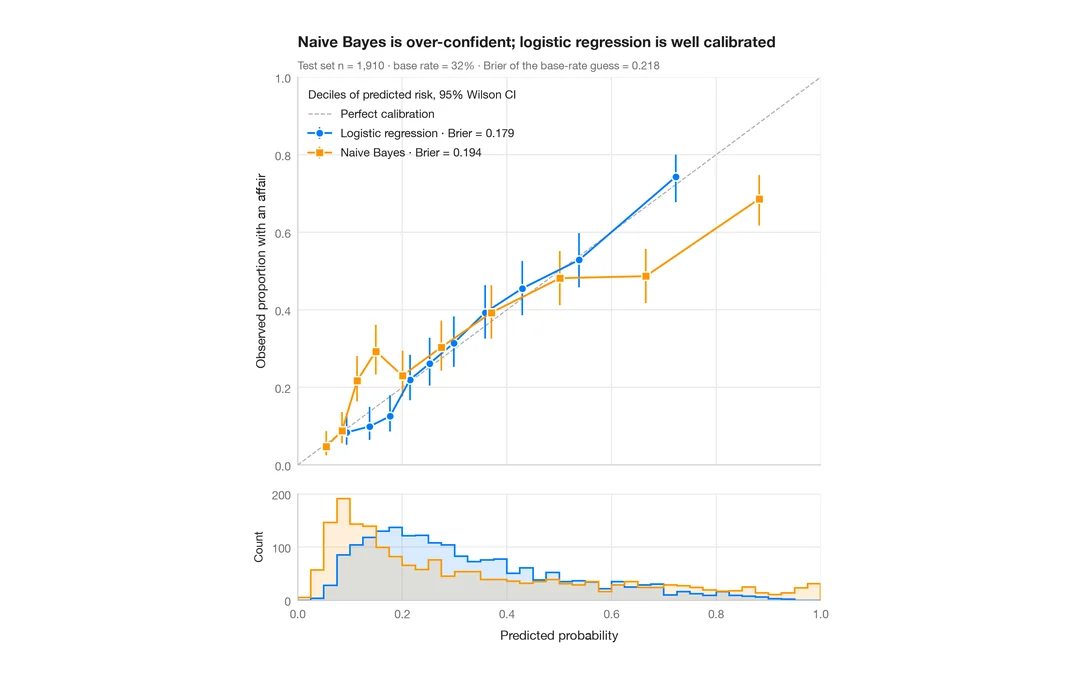
Graphique de calibration
Risque prédit et risque observé par décile, avec IC de Wilson, histogrammes des prédictions et score de Brier.
rms::calibrate() / probably::cal_plot_breaks()