
機械学習
指標付き混同行列
1996 年にドールに投票した人をロジスティック回帰がどれだけ当てられるか。件数と行ごとの割合を示す交差検証の混同行列に、主要指標のブートストラップ区間を添えます。
yardstick::conf_mat() + autoplot()
機械学習
適合率–再現率曲線
既婚女性のうち誰が婚外関係を申告するかを予測する 2 つの分類器の、交差検証による適合率–再現率曲線と、平均適合率、無技能のベースライン。
yardstick::pr_curve() + autoplot()
機械学習
学習曲線
既婚女性のうち誰が婚外関係を申告するかを予測する 2 つのモデルについて、訓練データを増やしたときの訓練正解率と交差検証正解率を示します。
caret::learning_curve_dat() + ggplot()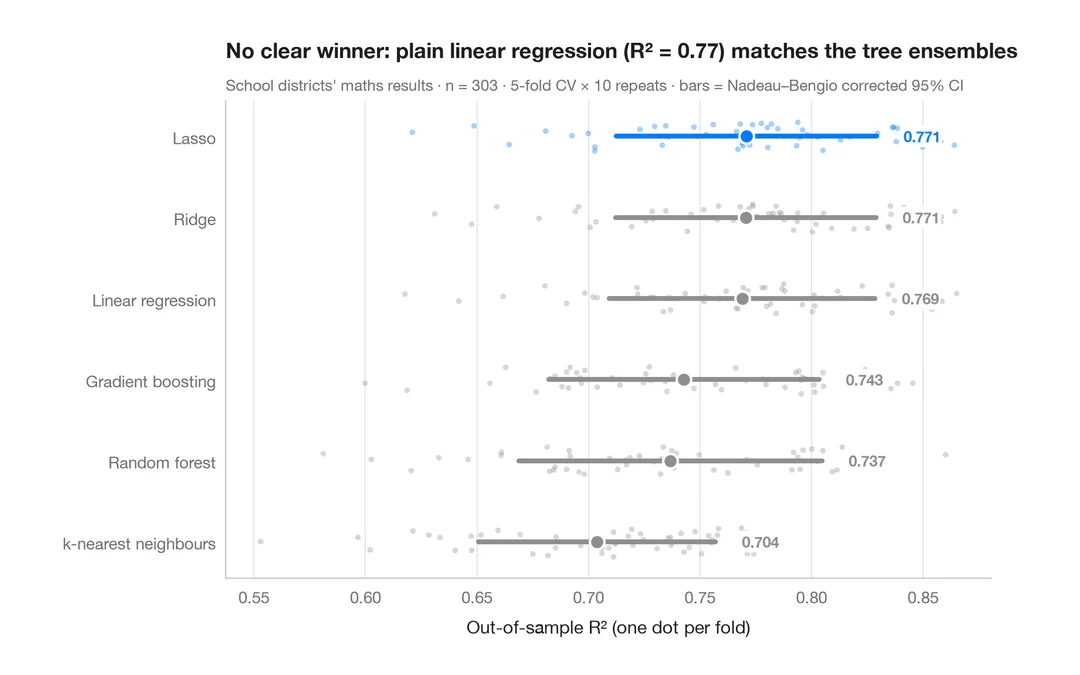
機械学習
交差検証によるモデル比較
カリフォルニア州の学区の数学の成績を予測する 6 つのモデルの分割ごとの R² を、平均値と補正済み 95% 区間とともに示します。
caret::resamples() + bwplot() / tune::autoplot()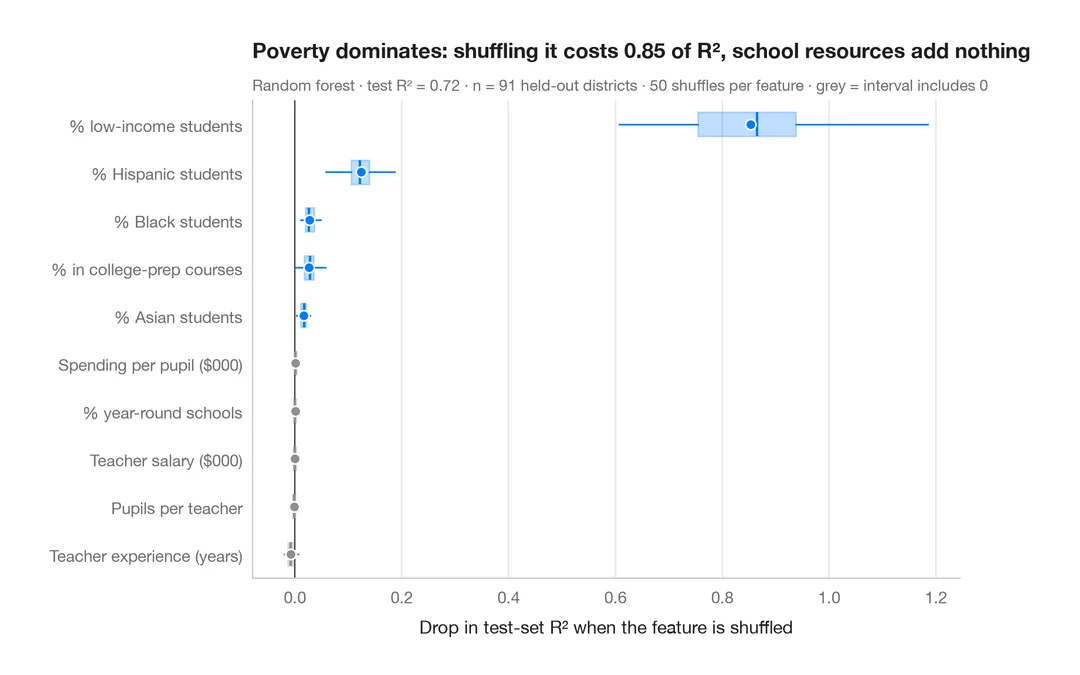
機械学習
置換重要度
ランダムフォレストが数学の成績を予測する際に頼る学区の特性。各特性をシャッフルしたときのテスト R² の低下で示します。
vip::vip(method = "permute")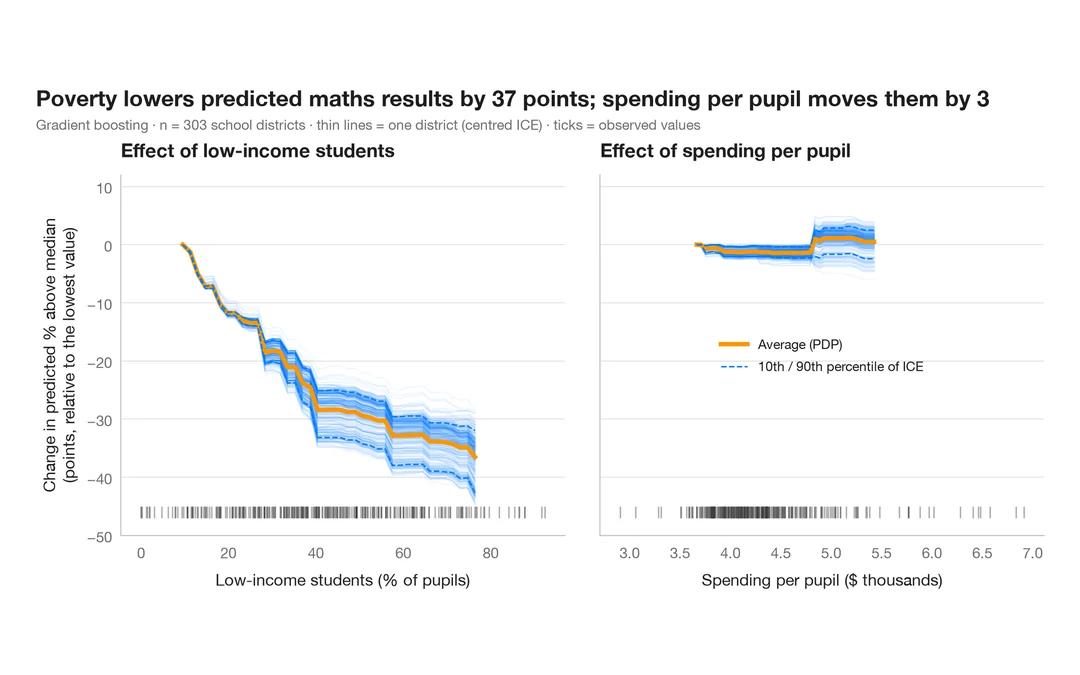
機械学習
ICE 曲線付き部分依存プロット
予測される数学の成績が貧困と生徒 1 人あたり支出によってどう変わるか。平均(PDP)を学区ごとの曲線(ICE)に重ねて示します。
pdp::partial(ice = TRUE) + autoplot() / iml::FeatureEffect応用:SHAP による説明
シャープレイ値は、各予測を特徴量ごとの加法的な寄与に分解します。全体として、特徴量ごとに、そして個々のケースについて。
機械学習 · 応用:SHAP による説明
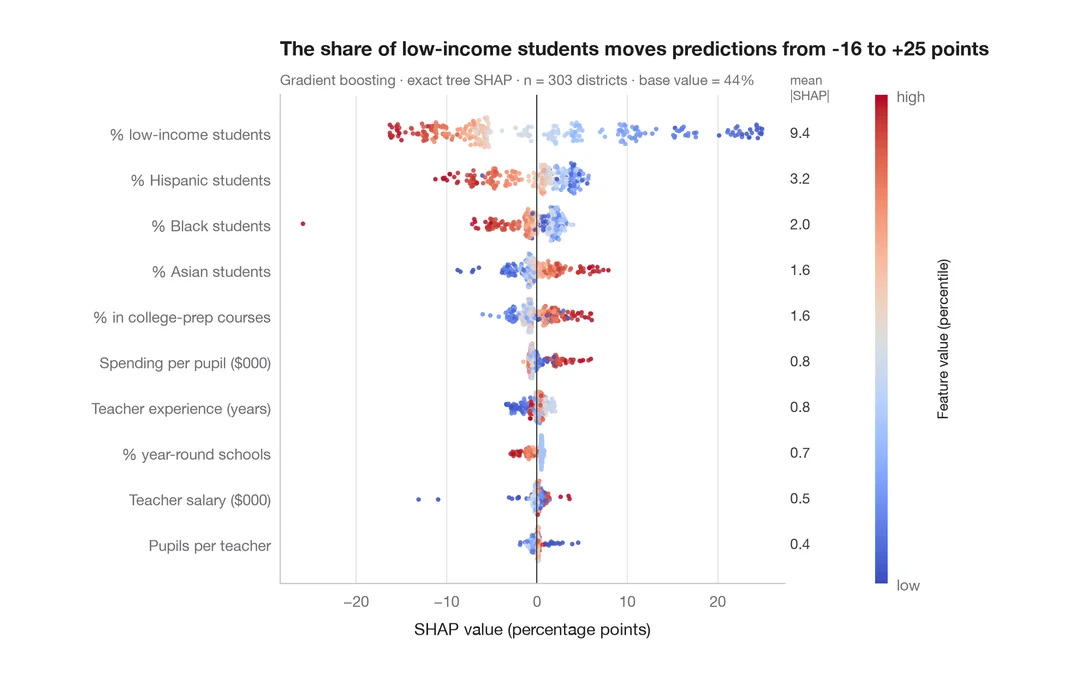
SHAP サマリー(ビースウォーム)
全学区・全特性の SHAP 値を特性の値で色分けし、平均 |SHAP| による重要度を添えます。
shapviz::sv_importance(kind = "beeswarm")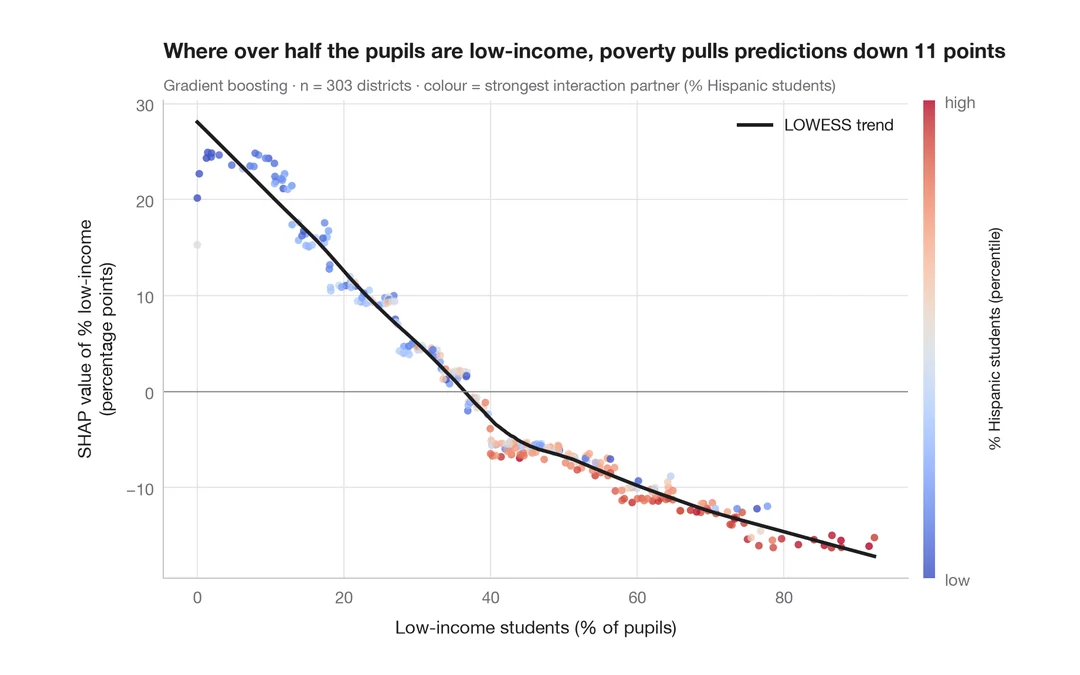
機械学習 · 応用:SHAP による説明
SHAP 依存プロット
低所得世帯の生徒の割合が各学区の予測される数学の成績にどう効くかを、最も強い交互作用の相手で色分けし、平滑化した傾向線を添えて示します。
shapviz::sv_dependence()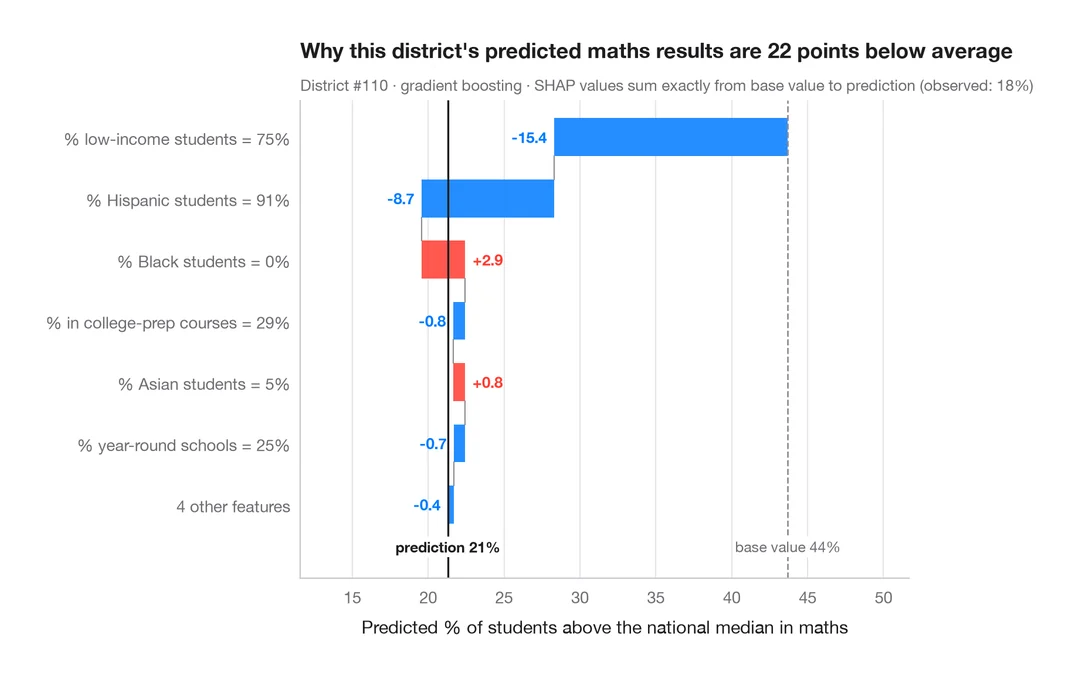
機械学習 · 応用:SHAP による説明
1 件の予測に対する SHAP ウォーターフォール
苦戦している 1 つの学区について、各特性が予測される数学の成績を平均からモデルの出力までどう動かすかを示します。
shapviz::sv_waterfall()