61 张统计图表 · 12 个类别 · 100% Python
社会数据科学,
尽在 Python。
基于真实社会科学数据、按所回答的问题组织的 Python 统计图表。机器学习(模型预测得多好、为什么这样预测)和空间数据(地图与空间自相关)与分布、组间比较、回归和生存分析并列收录;每张图都给出其背后的统计量——估计值、置信区间、检验和效应量。
大多数 Python 学习资源先教代码,把问题留到以后。本图库反其道而行之。它最初是为社会科学专业的学生编写的,也适合所有熟悉自己领域、手头有问题要回答的人:这些组之间有差异吗?这两个变量是否同步变化?模型为什么作出这样的预测?从问题出发,找到能回答它的图表,读懂图上给出的统计量,只取你需要的代码。
没有与搜索匹配的图表。试试“回归”“调查”“置信区间”或某个 R 函数名。
机器学习
模型对新数据的预测效果如何?原因何在?样本外评估、学习曲线与模型无关的解释——每一项都附带其不确定性。

带指标的混淆矩阵
逻辑回归能多好地预测谁在 1996 年投票给多尔——样本外混淆矩阵,显示计数与行内占比,并为主要指标给出自助法区间。
yardstick::conf_mat() + autoplot()
精确率–召回率曲线
两个分类器预测哪些已婚女性报告有婚外情的样本外精确率–召回率曲线,附平均精确率与无技能基线。
yardstick::pr_curve() + autoplot()
学习曲线
随训练集增大的训练准确率与交叉验证准确率,比较两个预测哪些已婚女性报告有婚外情的模型。
caret::learning_curve_dat() + ggplot()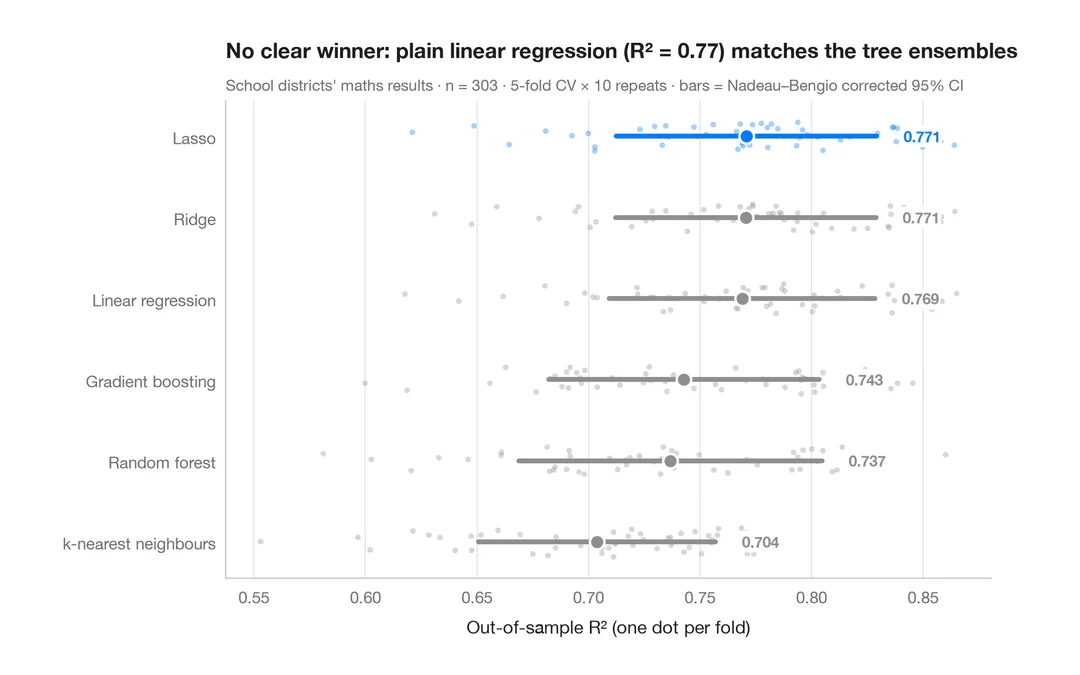
交叉验证模型比较
六个模型预测加利福尼亚州学区数学成绩的逐折 R²,附均值与校正后的 95% 区间。
caret::resamples() + bwplot() / tune::autoplot()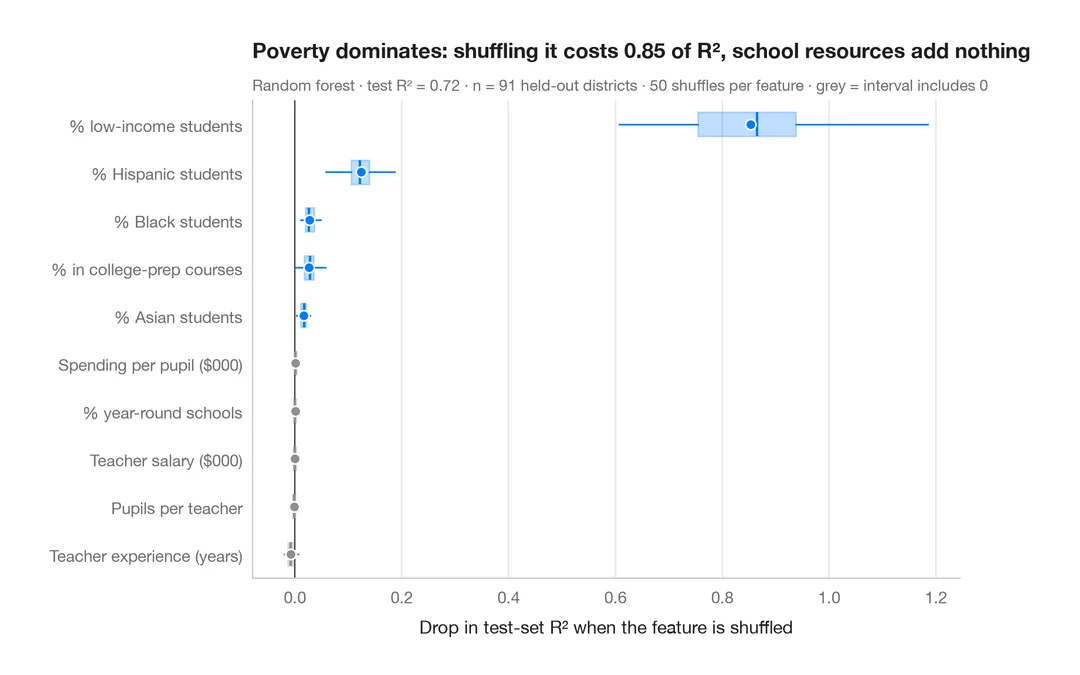
置换重要性
随机森林预测数学成绩时依赖哪些学区特征——逐个打乱每项特征时测试集 R² 的下降。
vip::vip(method = "permute")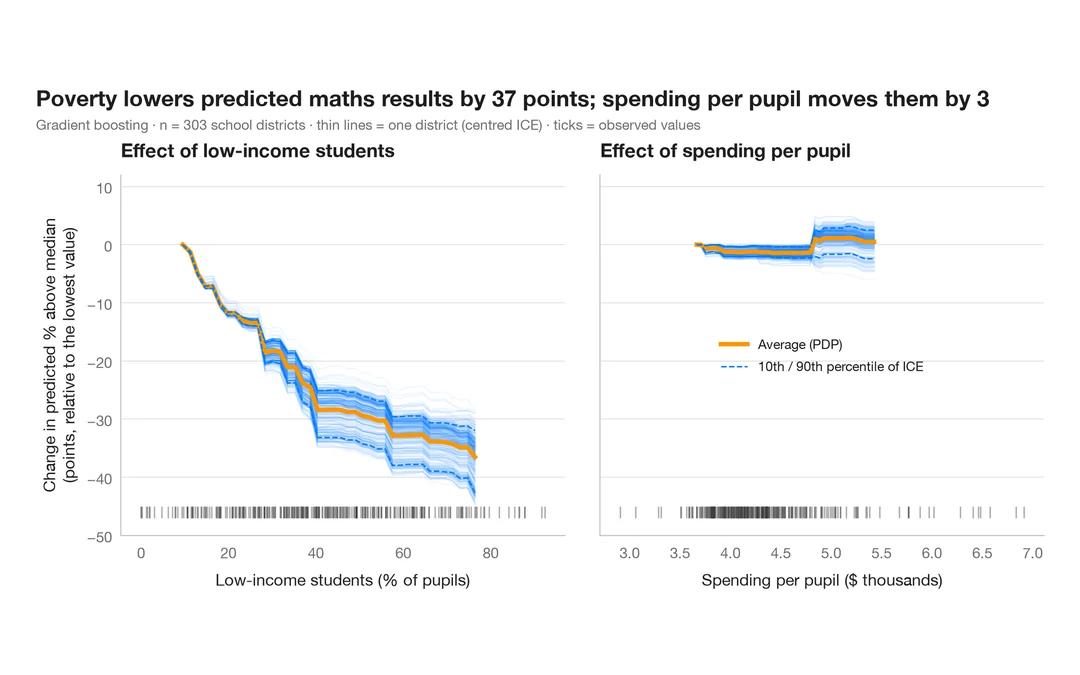
带 ICE 曲线的部分依赖图
预测的数学成绩如何随贫困程度和生均支出变化——平均值(PDP)叠加在每个学区一条的个体曲线(ICE)之上。
pdp::partial(ice = TRUE) + autoplot() / iml::FeatureEffect进阶:SHAP 解释
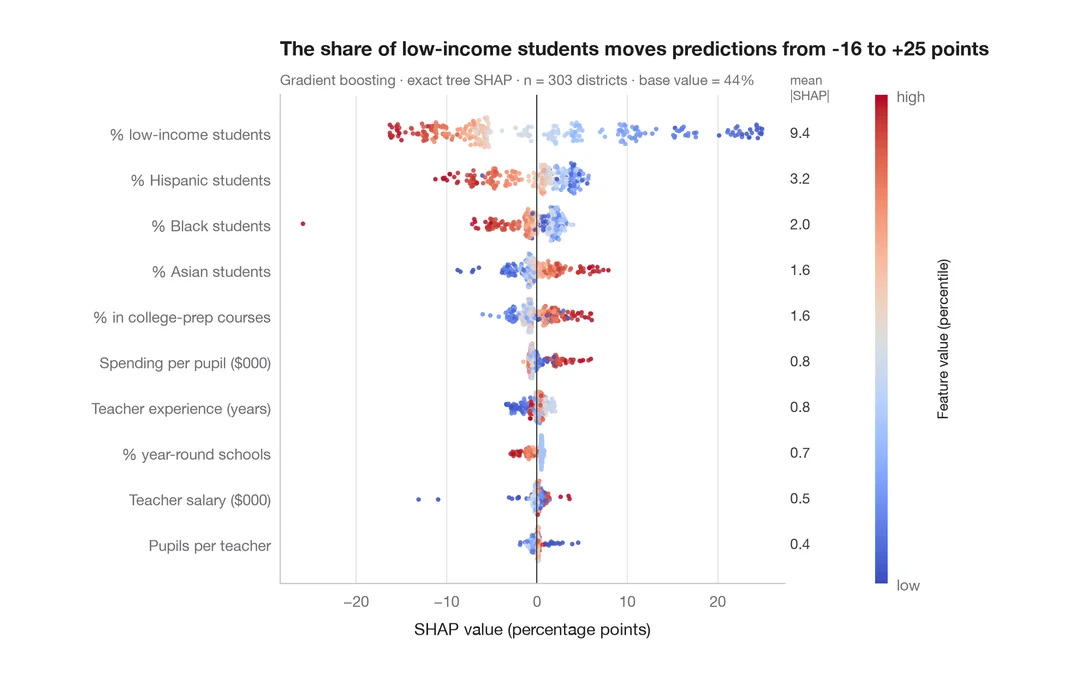
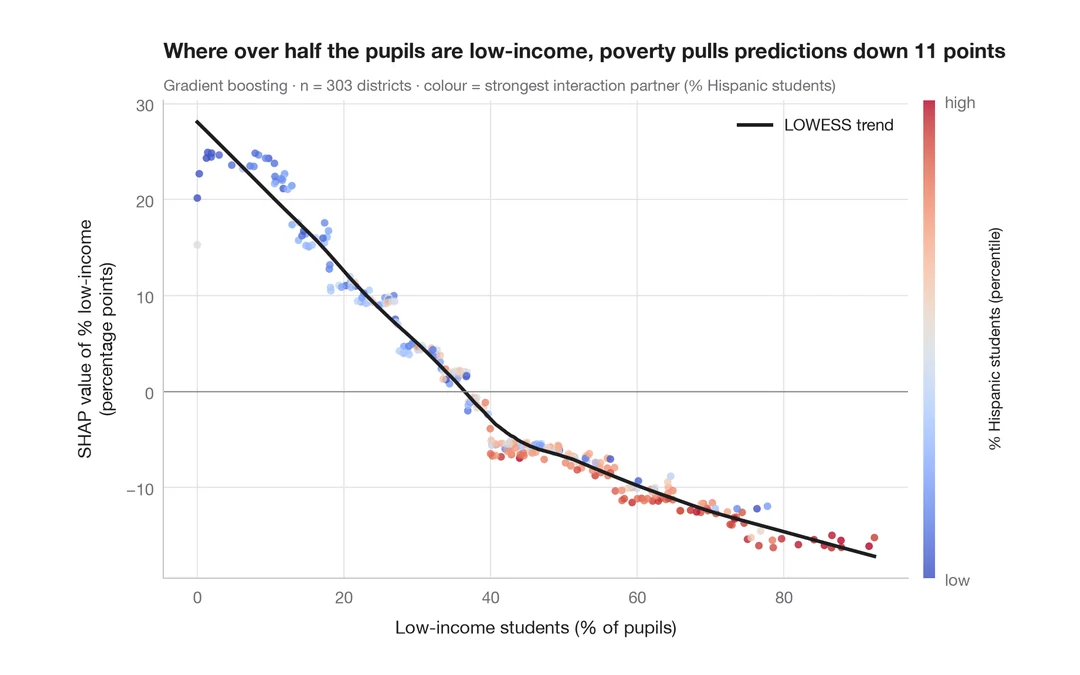
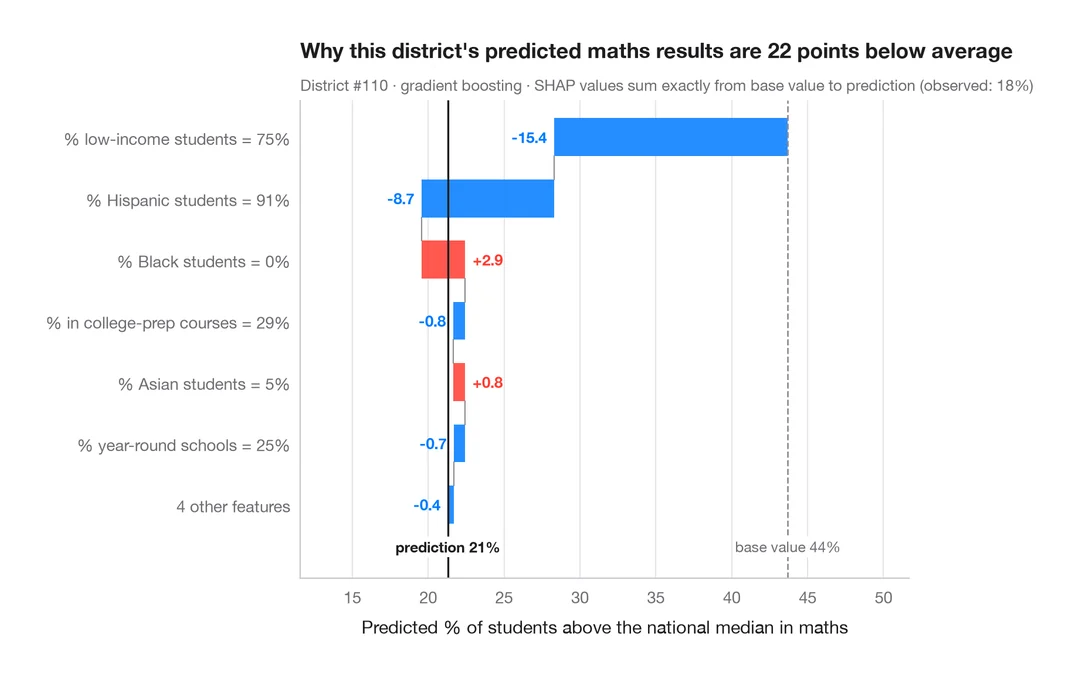
Shapley 值将每个预测分解为各特征的可加贡献——从全局、逐个特征,到单个个案。
空间数据
邻近地区数值高的地方,本地数值是否也更高?空间权重、全局与局部空间自相关,以及集聚的影响范围——以 1830 年代盖里的法国数据为例。
带空间权重的分级统计地图
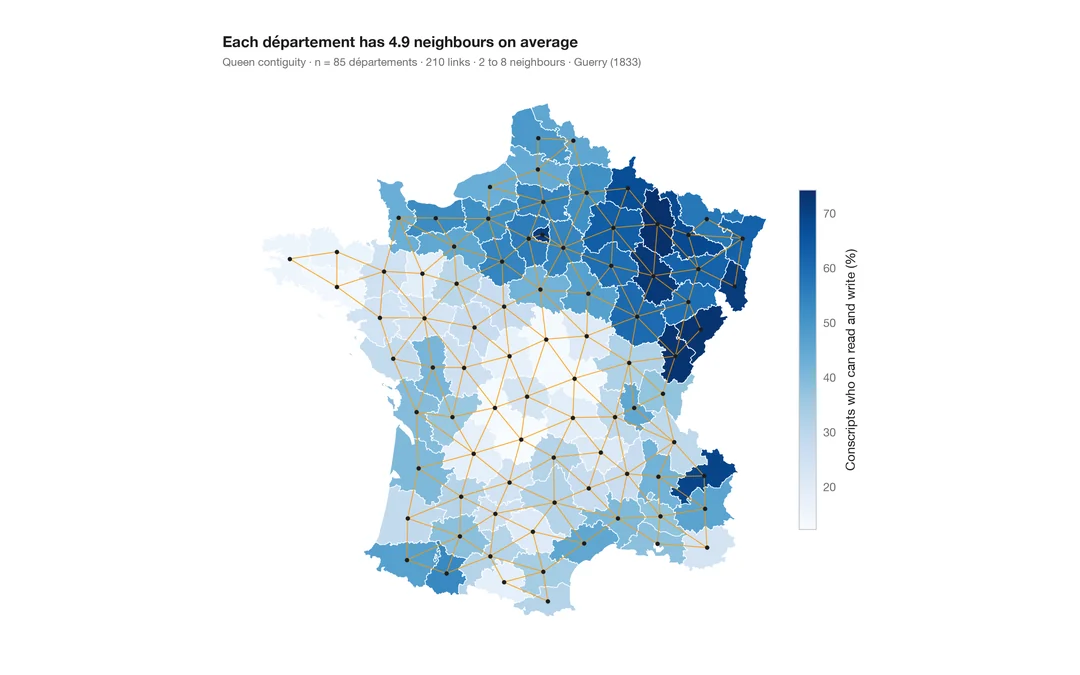
一个变量的地图,上面叠加邻接网络——这是所有空间统计赖以成立的结构。
spdep::poly2nb() + plot(nb, coords)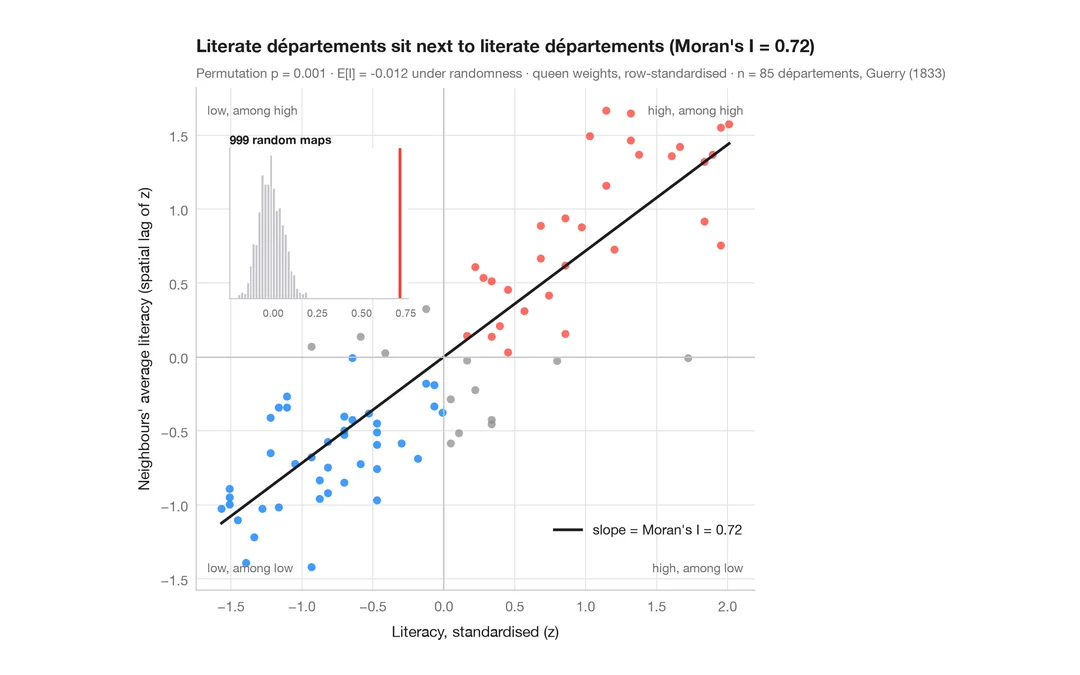
莫兰散点图(全局自相关)
每个地区与其邻居平均值的对比,附莫兰 I、置换检验及参照分布。
spdep::moran.plot() + spdep::moran.mc()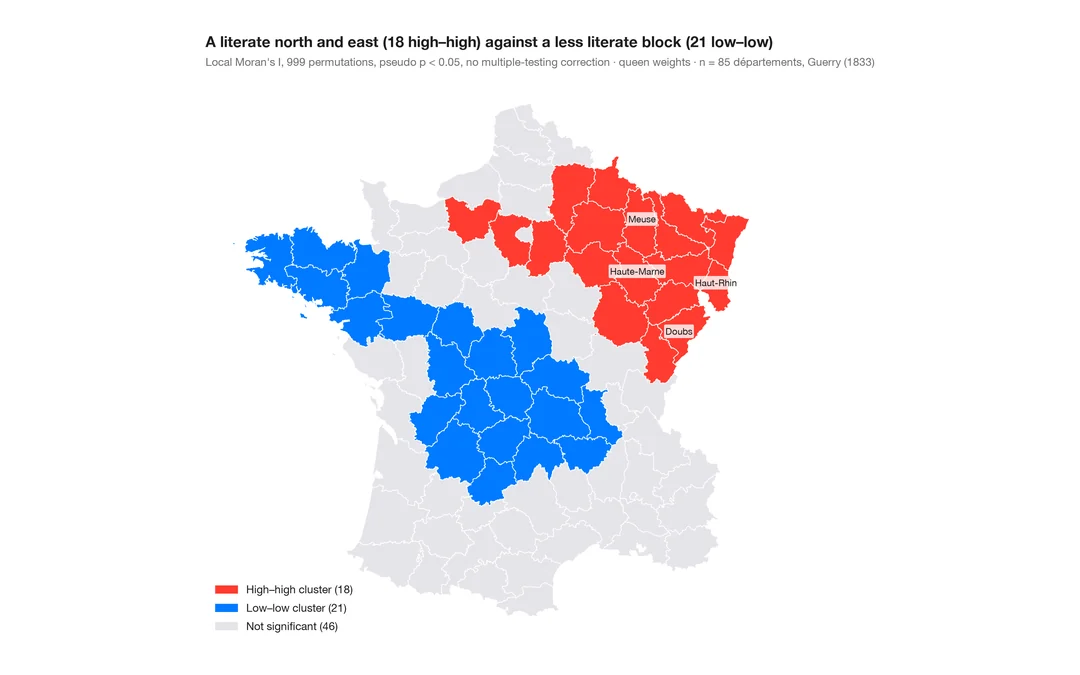
LISA 聚类地图(局部自相关)
聚类和空间异常值在哪里——每个地区的局部莫兰 I,并标出其置换显著性。
spdep::localmoran_perm() / rgeoda::local_moran()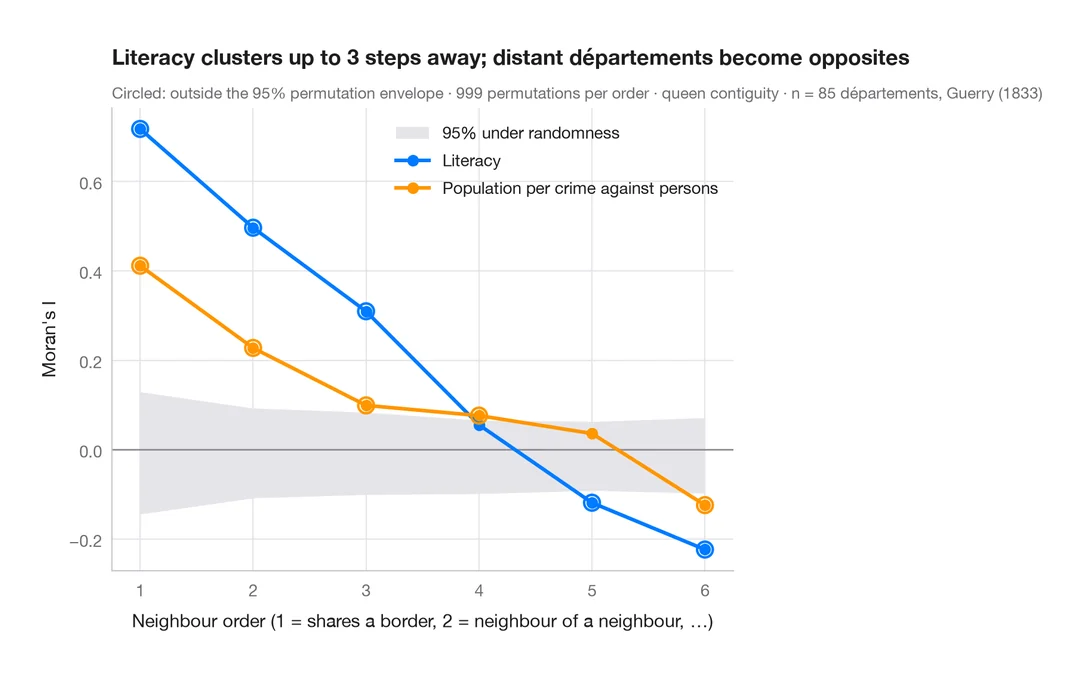
空间相关图
随邻接阶数增加的莫兰 I,附置换包络——空间聚集能延伸多远。
spdep::sp.correlogram(method = "I")分布
看清数据的形态:直方图、密度图、山脊图、ECDF 与 Q–Q 图。
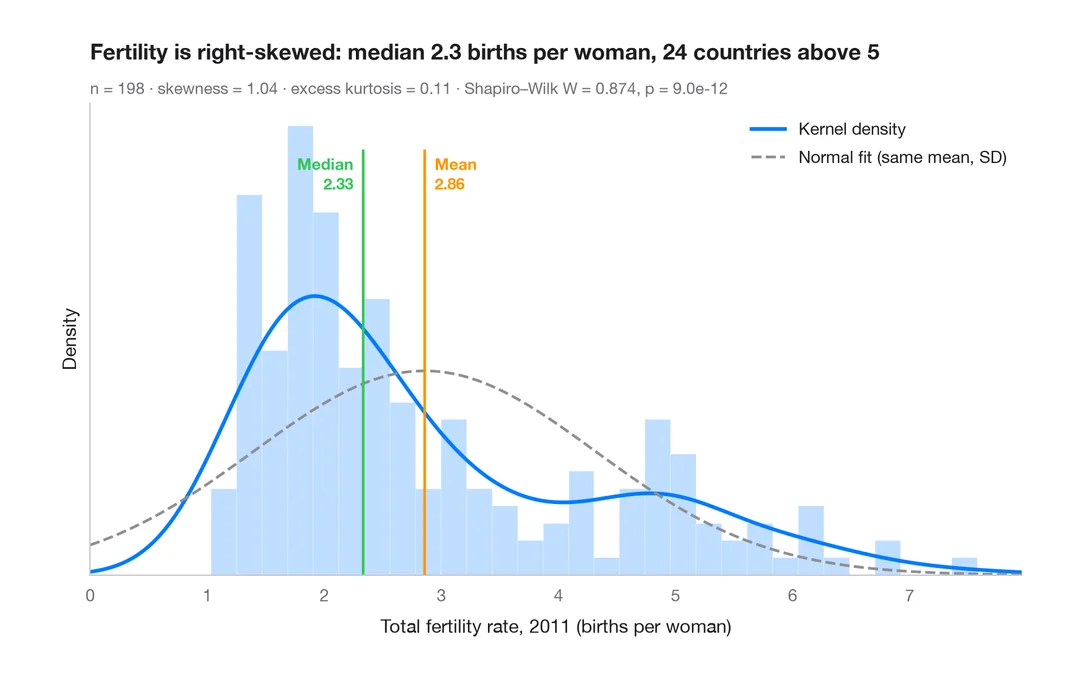
带密度曲线的直方图
直方图、核密度和拟合的正态曲线,并附形态统计量。
ggplot2::geom_histogram() + geom_density()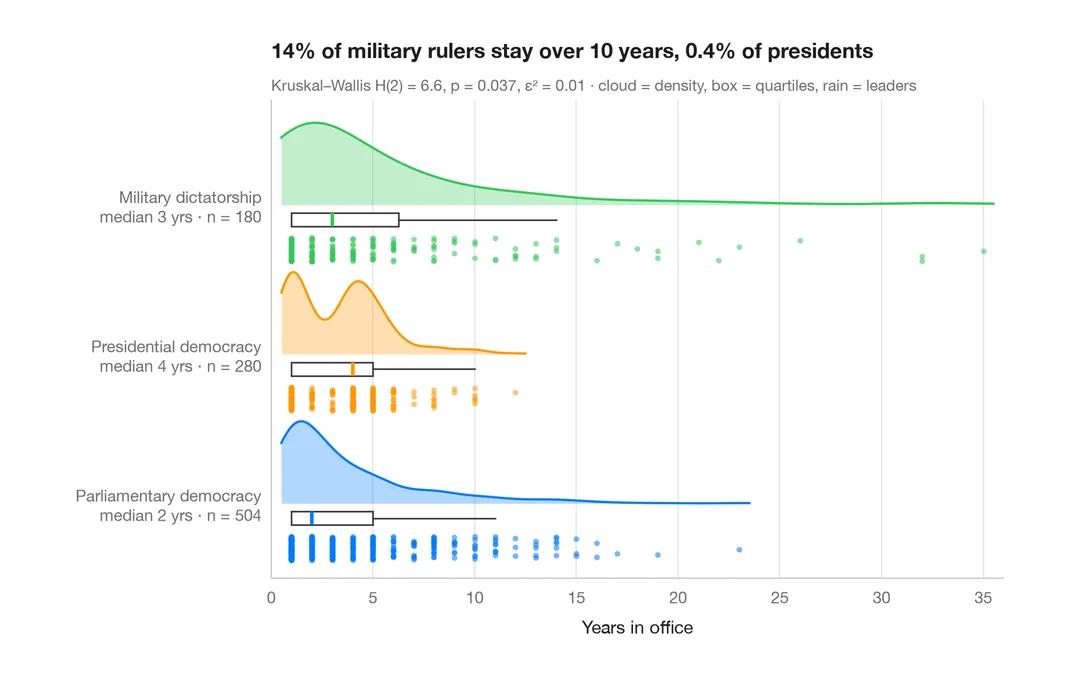
雨云图
按组横向绘制半边小提琴图、箱线图和原始数据点。
ggdist::stat_halfeye() / ggrain::geom_rain()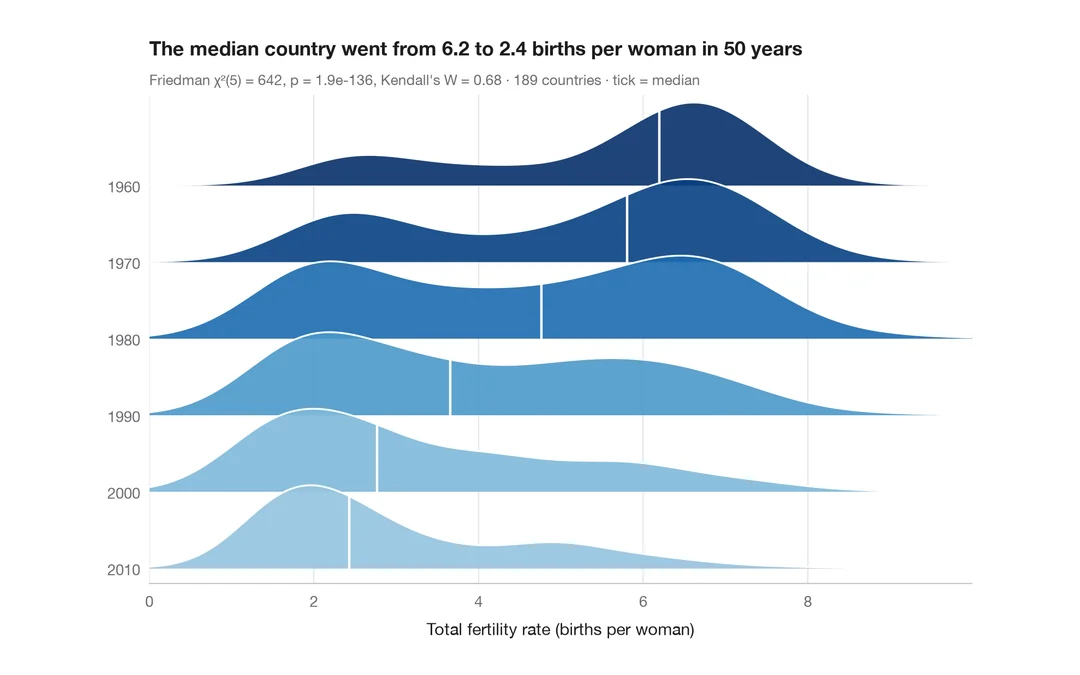
山脊图
以相互重叠的密度曲线比较多个组的同一分布。
ggridges::geom_density_ridges()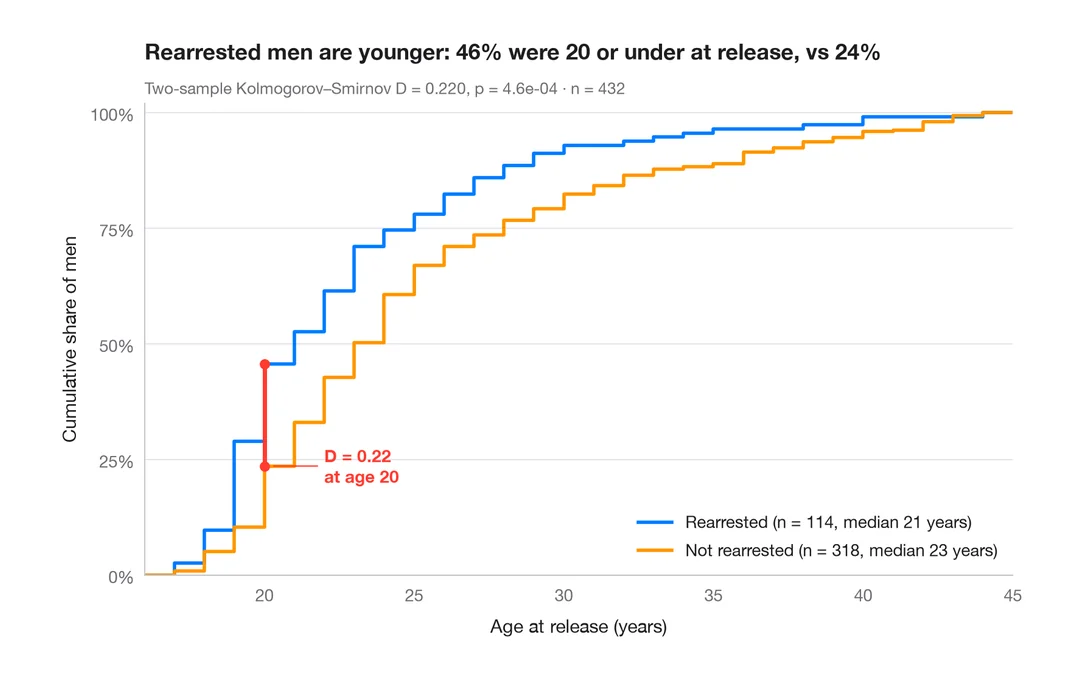
ECDF 比较
两组的经验累积分布,并标出 Kolmogorov–Smirnov 最大差距。
ggplot2::stat_ecdf()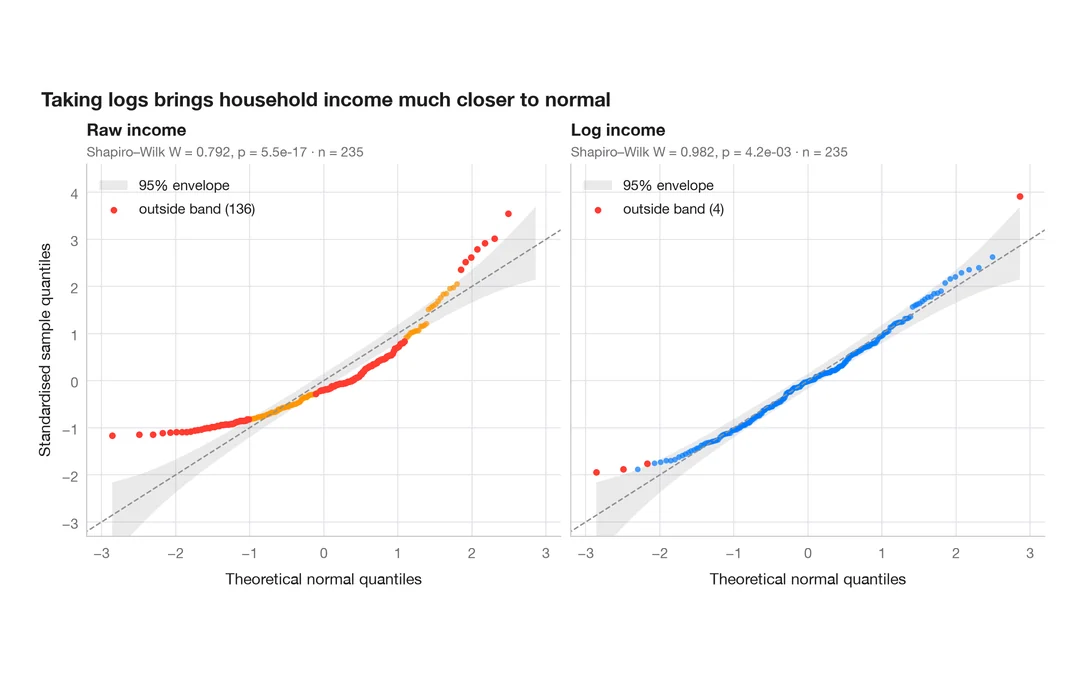
带置信带的 Q–Q 图
带 95% 包络带的正态 Q–Q 图,分别展示原始变量与对数变换后的变量。
qqplotr::stat_qq_band()组间比较
以 ggstatsplot 的方式比较各组,将检验、效应量和 p 值直接标注在图上。
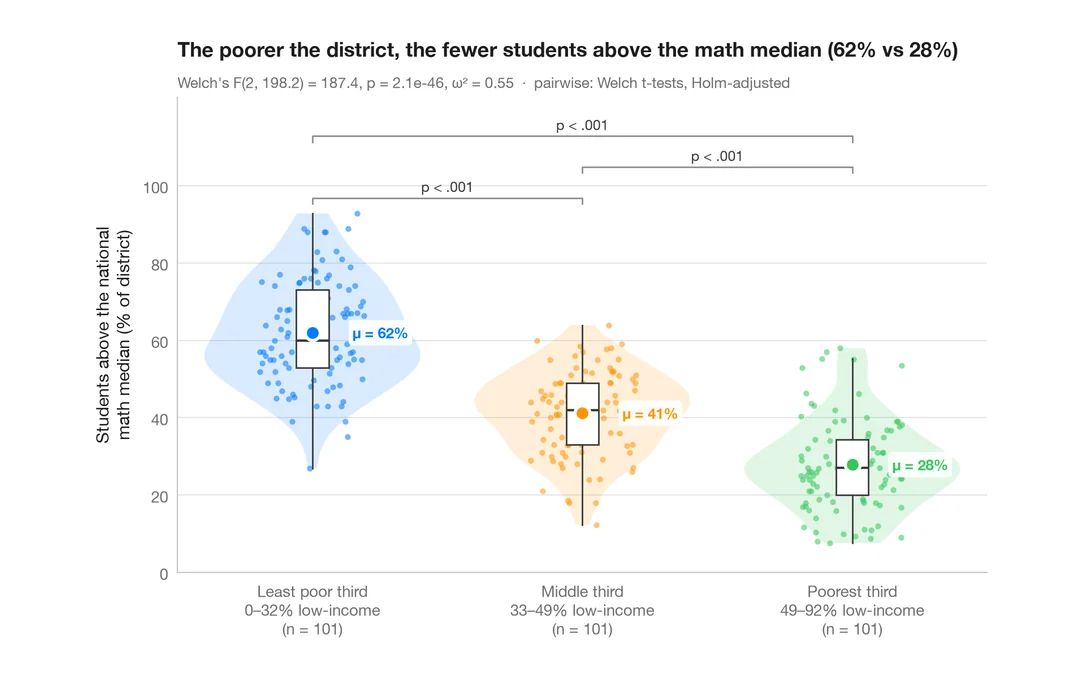
组间比较
小提琴图 + 箱线图 + 散点,附 Welch 方差分析、效应量和两两检验。
ggstatsplot::ggbetweenstats()
被试内比较
重复测量数据,每名被试一条线,附均值、重复测量方差分析和配对检验。
ggstatsplot::ggwithinstats()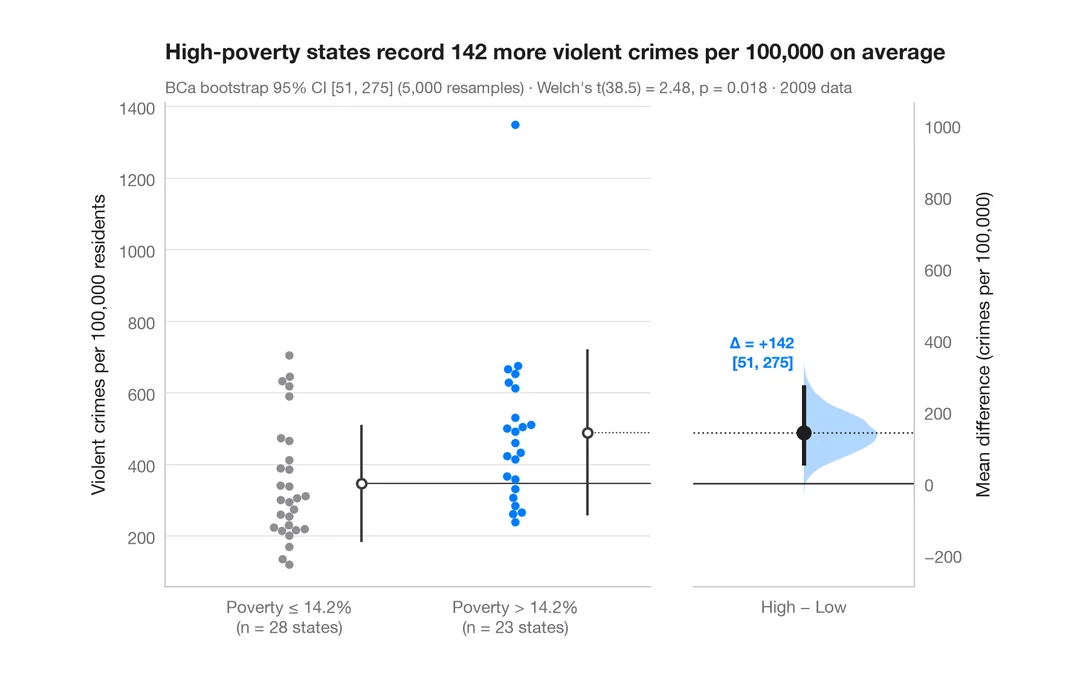
估计图
两组原始数据,加上均值差及其自助法 95% 置信区间。
dabestr::dabest() + plot()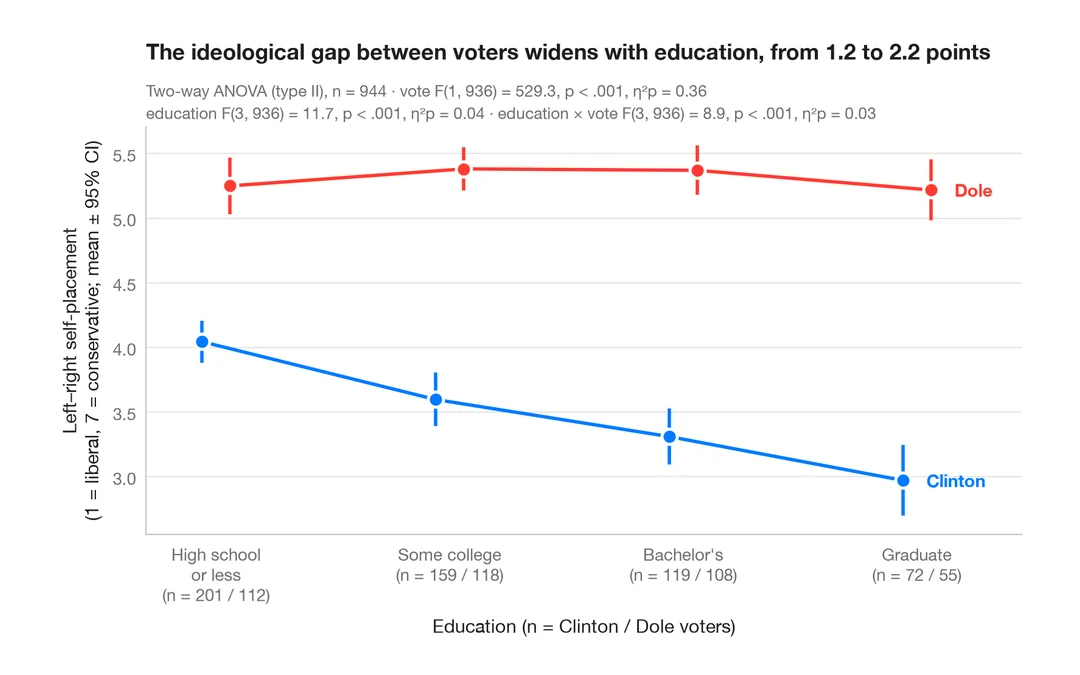
交互作用图
两个因素下各组均值及其 95% 置信区间,附双因素方差分析。
ggpubr::ggline(add = "mean_ci") / ggstats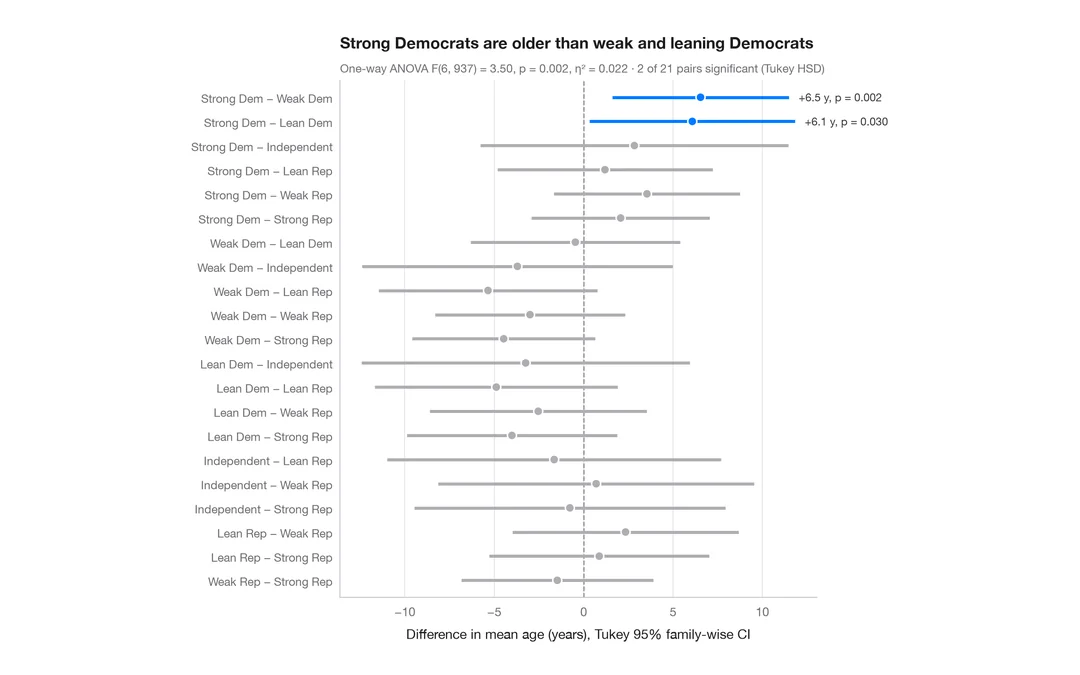
Tukey HSD 区间
所有两两均值差的 95% 联合置信区间。
TukeyHSD() + plot()比例与问卷调查
比例、交叉表与 Likert 量表,延续 ggstats::gglikert 与 stat_prop 的风格。
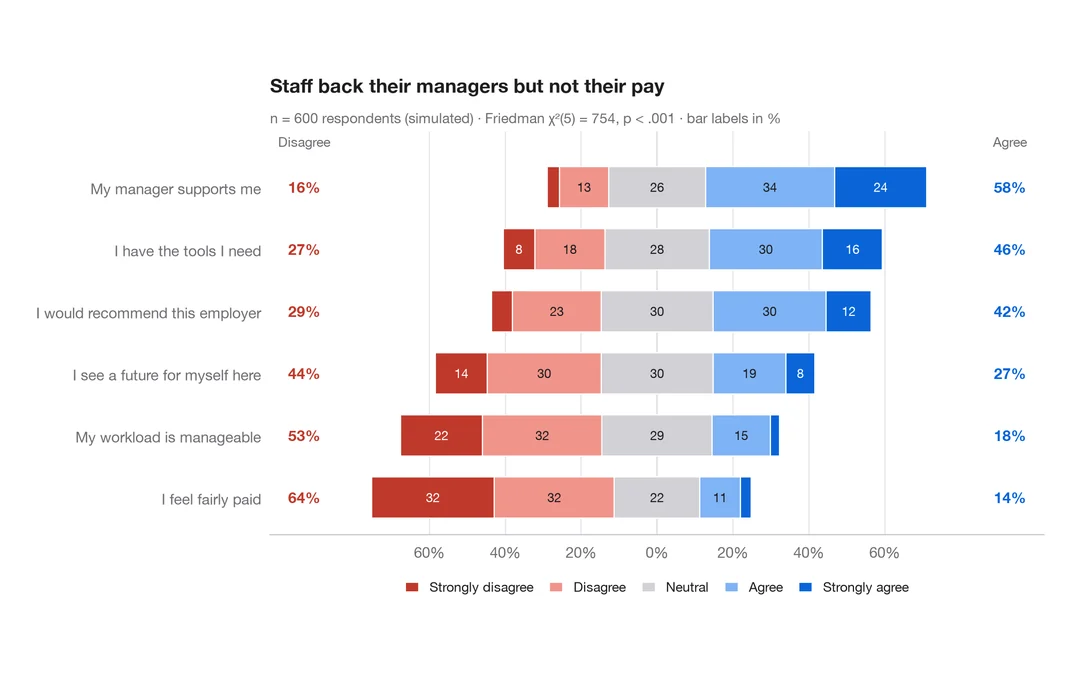
发散式 Likert 图
以中性回答为中心的发散堆叠条形图,展示五点 Likert 题项。
ggstats::gglikert()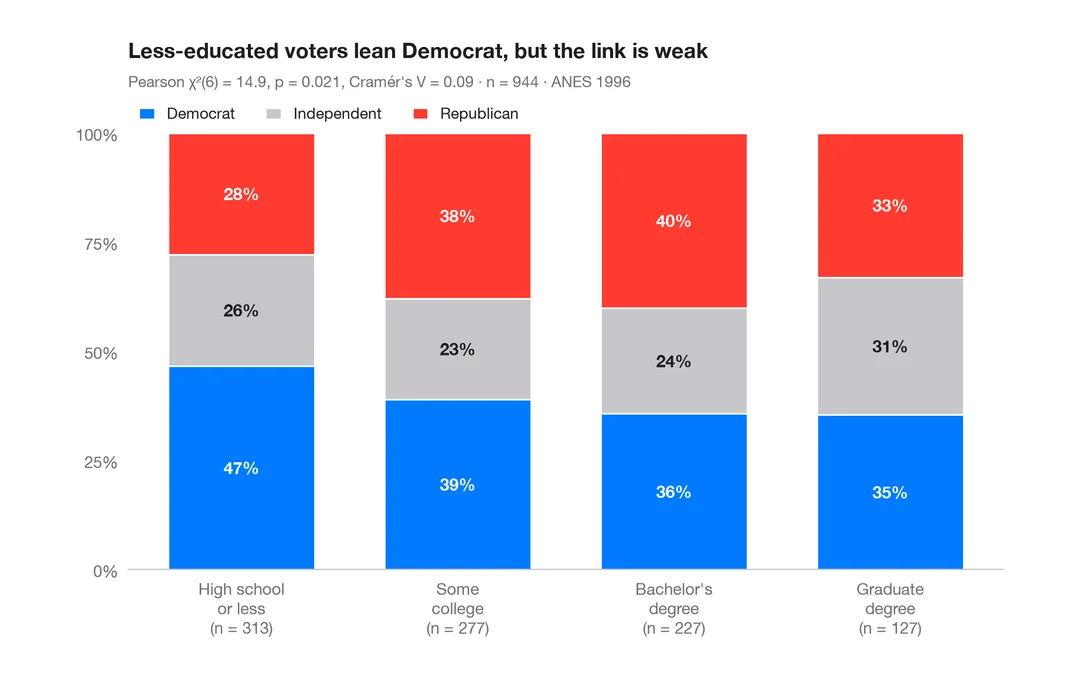
按组堆叠的比例图
带百分比标签和每组 n 的 100% 堆叠条形图,附卡方检验和 Cramér's V。
ggstatsplot::ggbarstats()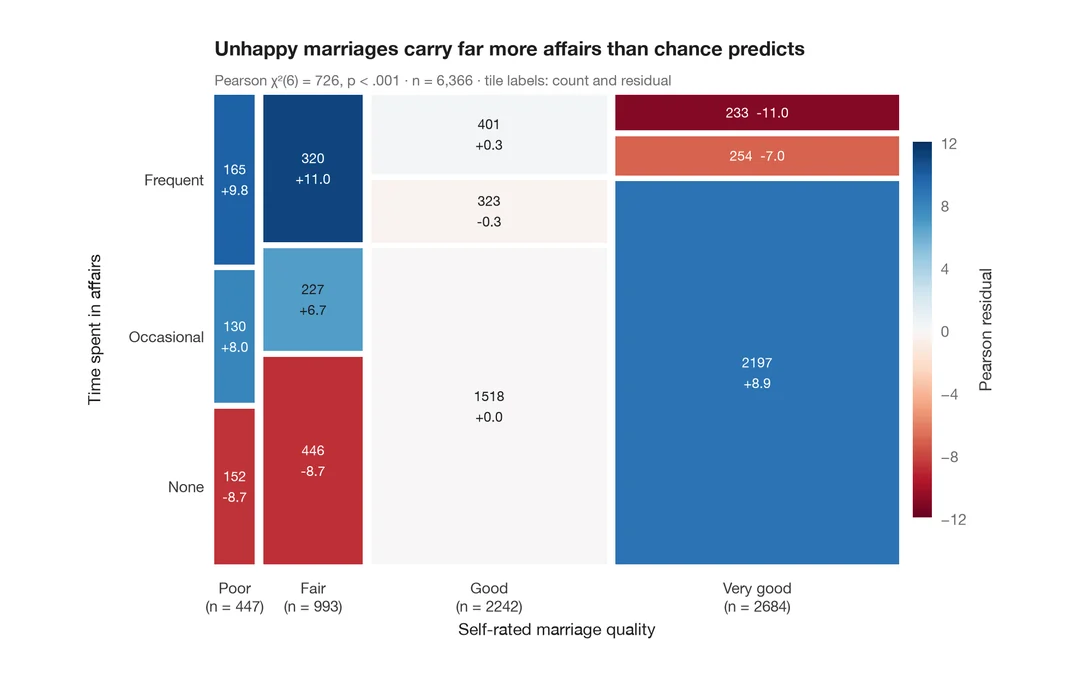
带 Pearson 残差的马赛克图
色块面积与单元格频数成正比,并按相对于独立性的 Pearson 残差着色。
vcd::mosaic(shade = TRUE)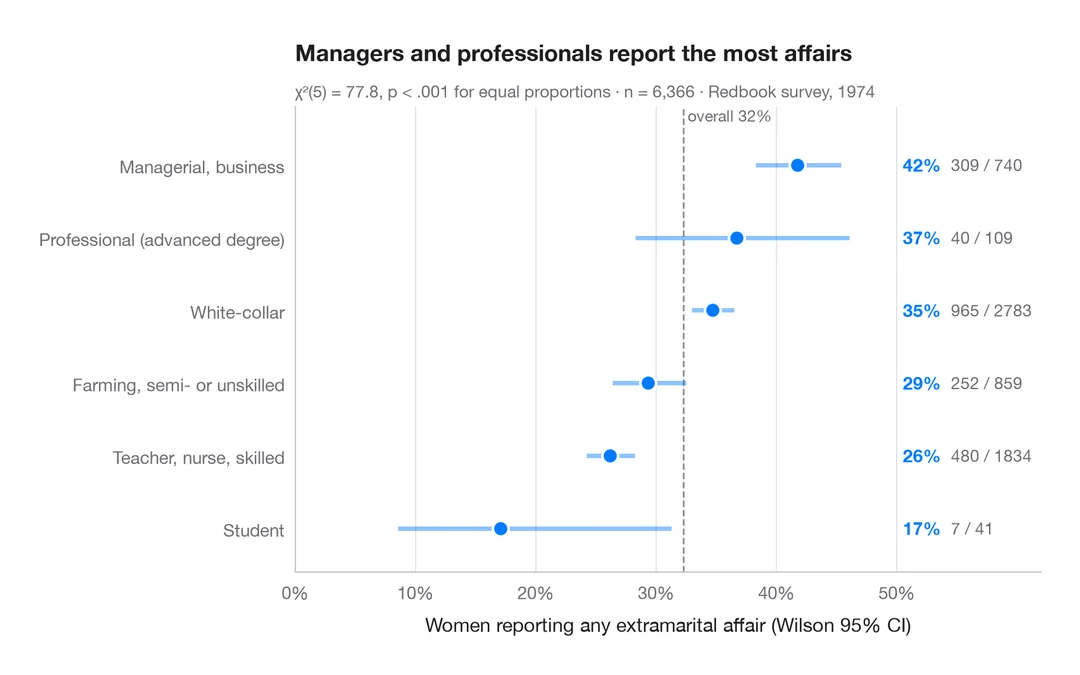
带置信区间的比例
按大小排序的各组比例点图,附 Wilson 95% 置信区间。
ggstats::stat_prop() + geom_errorbar()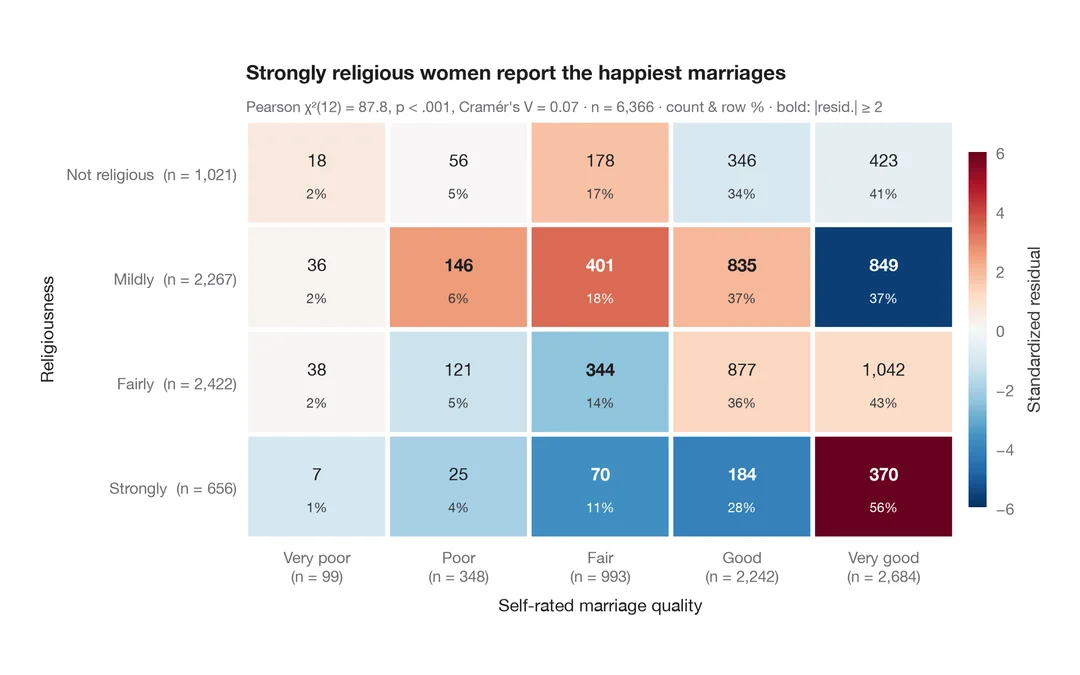
带标准化残差的交叉表
以热图呈现的列联表,按相对于独立性的标准化残差着色。
ggstats::ggtable() / stat_cross()相关与关联
相关矩阵、附带统计量的散点图以及变量两两之间的关系。
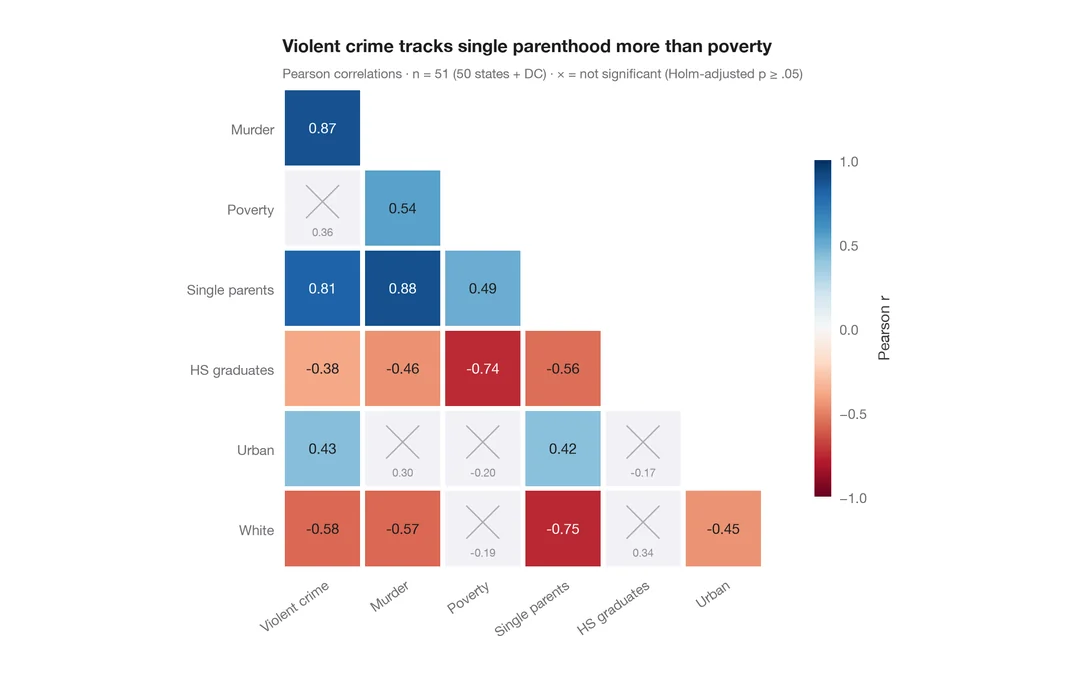
相关矩阵
下三角 Pearson 相关热图;不显著的单元格(Holm 校正)以叉号划去。
ggstatsplot::ggcorrmat()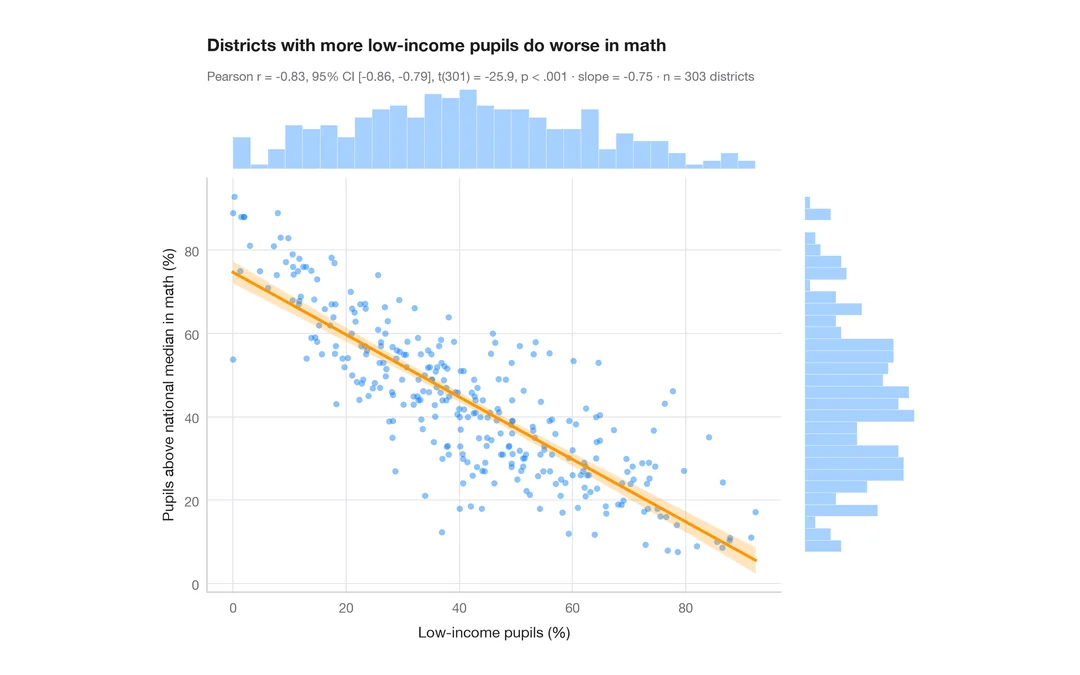
附统计量的散点图
加州 303 个学区的低收入学生比例与数学成绩——散点图、附 95% 置信带的 OLS 回归线、边际直方图和 Pearson r。
ggstatsplot::ggscatterstats()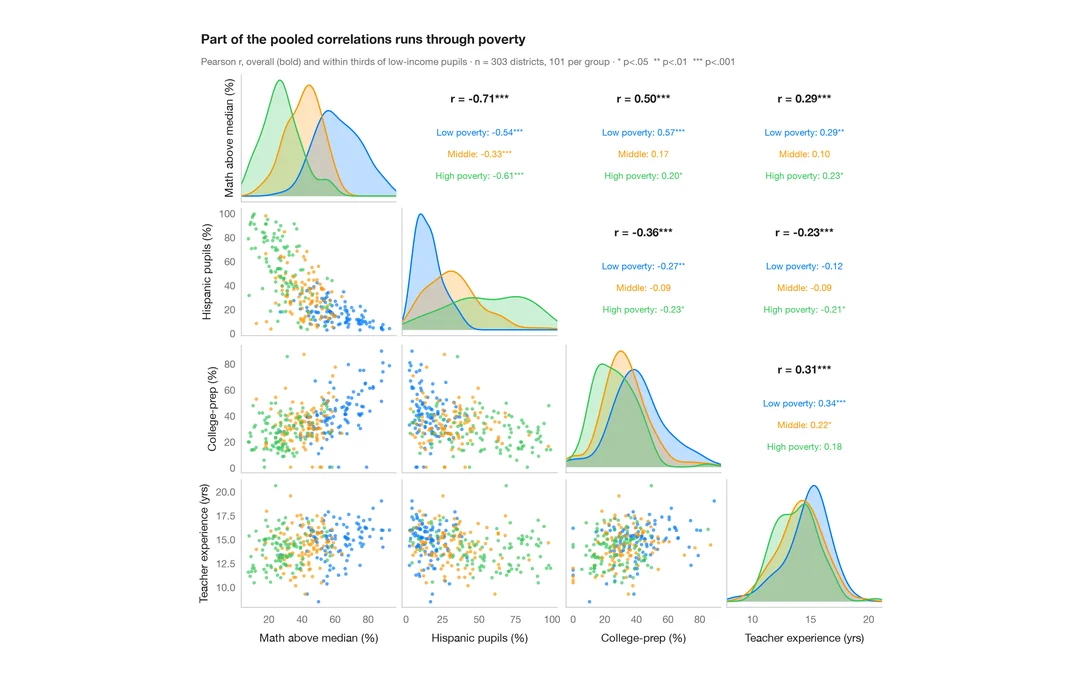
附相关系数的配对图
四个学区变量的散点图矩阵,对角线为分组密度,上方为合并相关与组内相关。
GGally::ggpairs()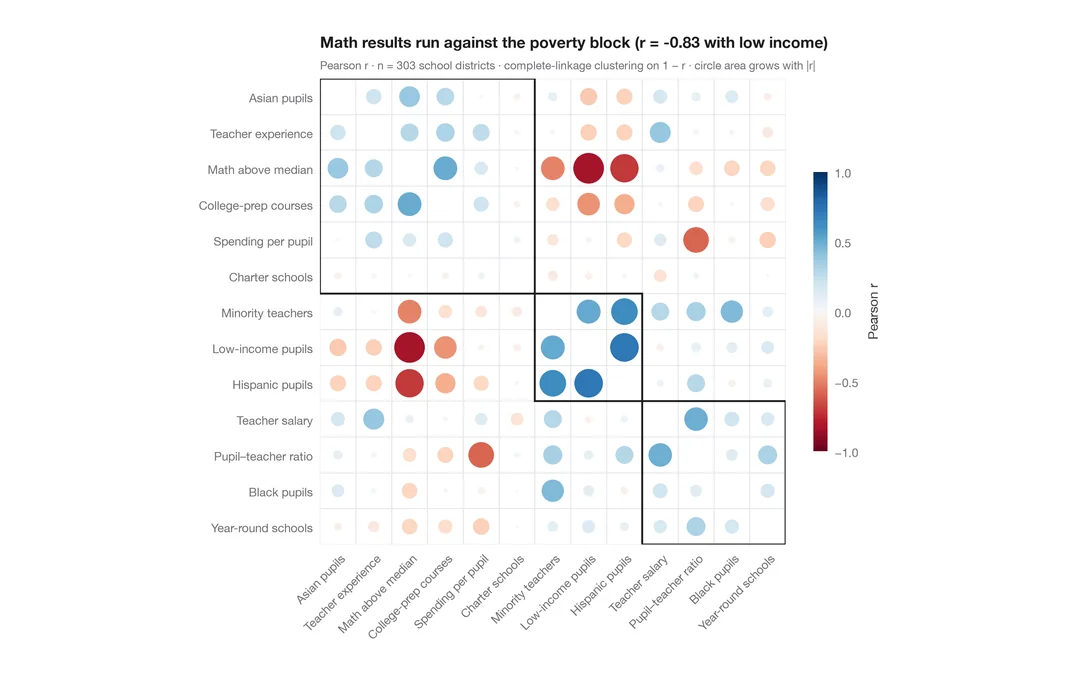
带聚类的相关图
13 个学区指标的 corrplot 风格圆圈图,圆圈大小和颜色由 r 决定,并按层次聚类排序。
corrplot::corrplot(order = "hclust", addrect = 3)回归模型
系数图、优势比、模型比较与边际效应——Python 版的 ggcoef_model。

系数图
回归估计值及其 95% 置信区间,每项一行。
ggstats::ggcoef_model()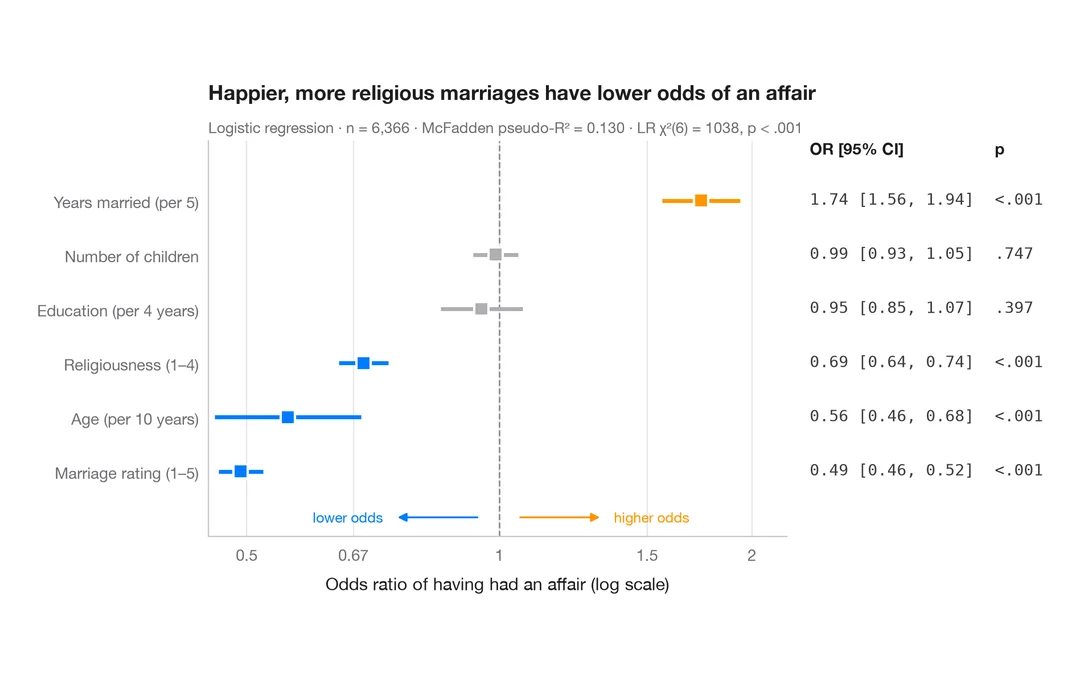
优势比森林图
对数刻度上的 logistic 回归优势比,并列附 OR [95% CI] 表格。
ggstats::ggcoef_model(exponentiate = TRUE)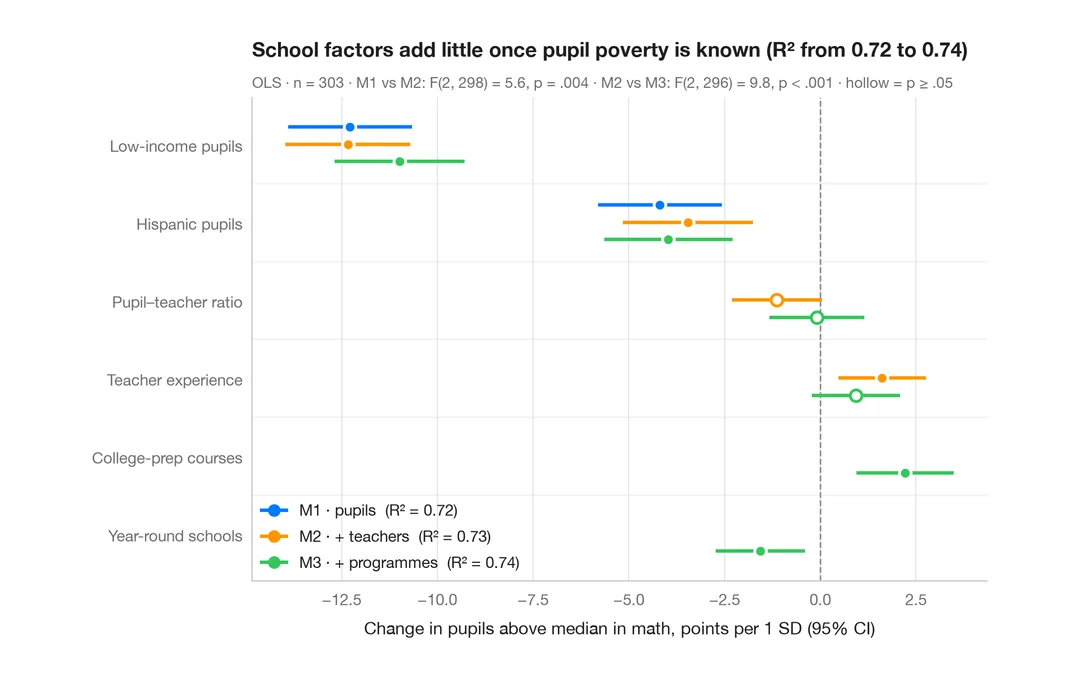
嵌套模型比较
并排展示学区数学成绩的三个嵌套回归的系数,观察逐块加入变量时估计值如何变化。
ggstats::ggcoef_compare()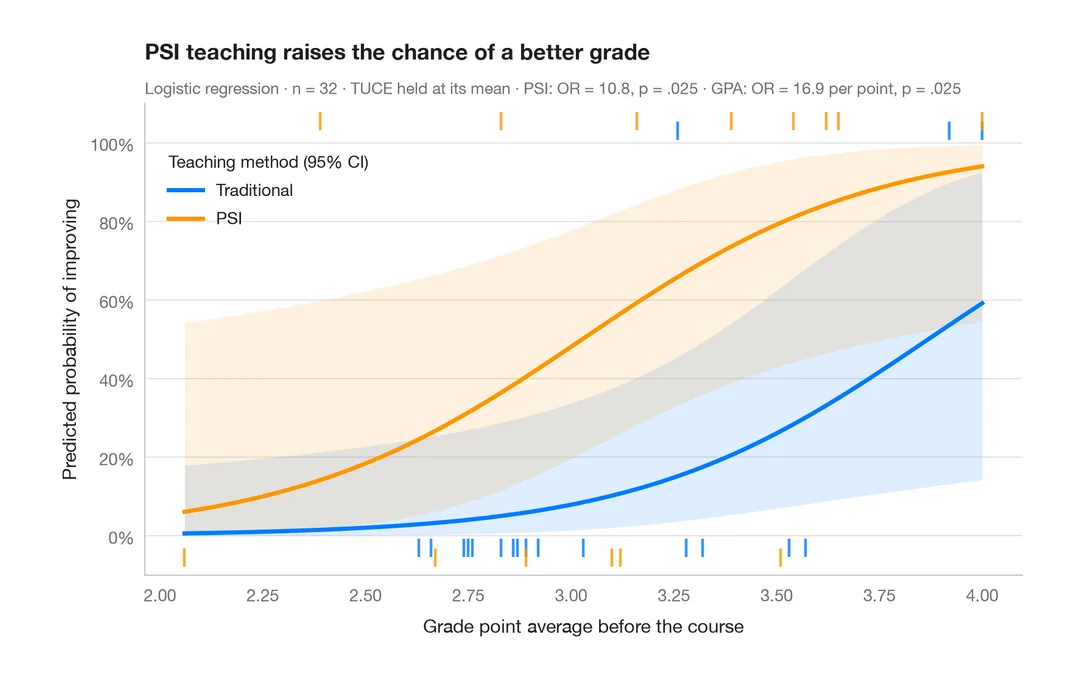
预测概率
按组绘制随某一预测变量变化的模型预测概率曲线,附 95% 置信带。
ggeffects::ggpredict() / marginaleffects::plot_predictions()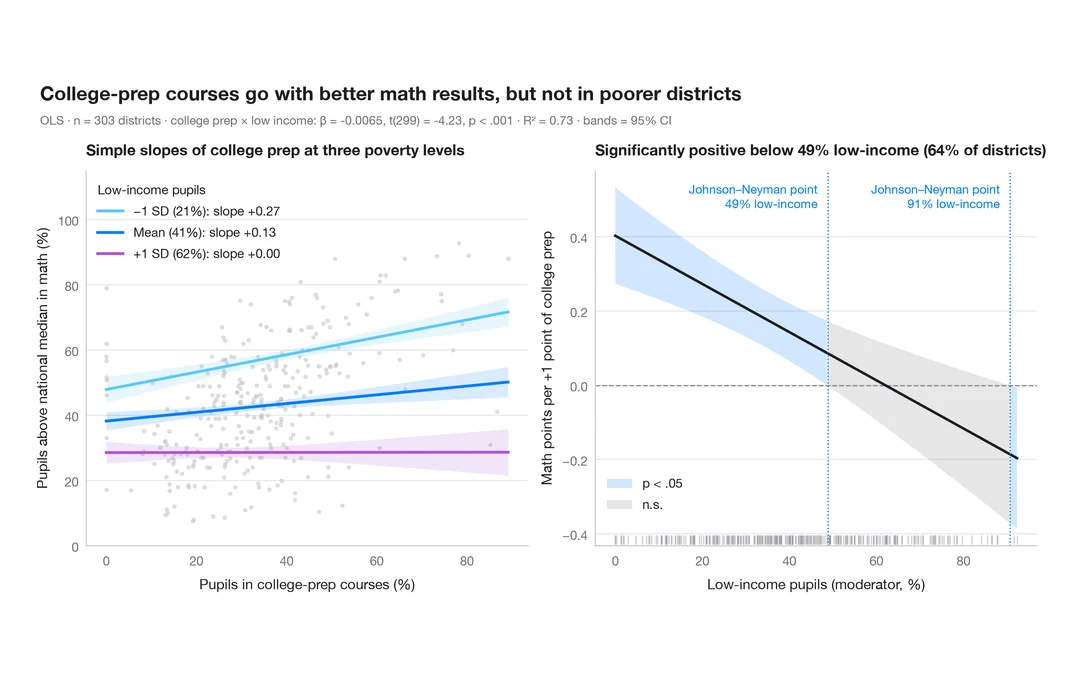
交互效应
均值 ± 1 SD 处的简单斜率与 Johnson–Neyman 图:大学预备课程与数学成绩的关系,受学生贫困程度调节。
interactions::interact_plot() / interactions::johnson_neyman()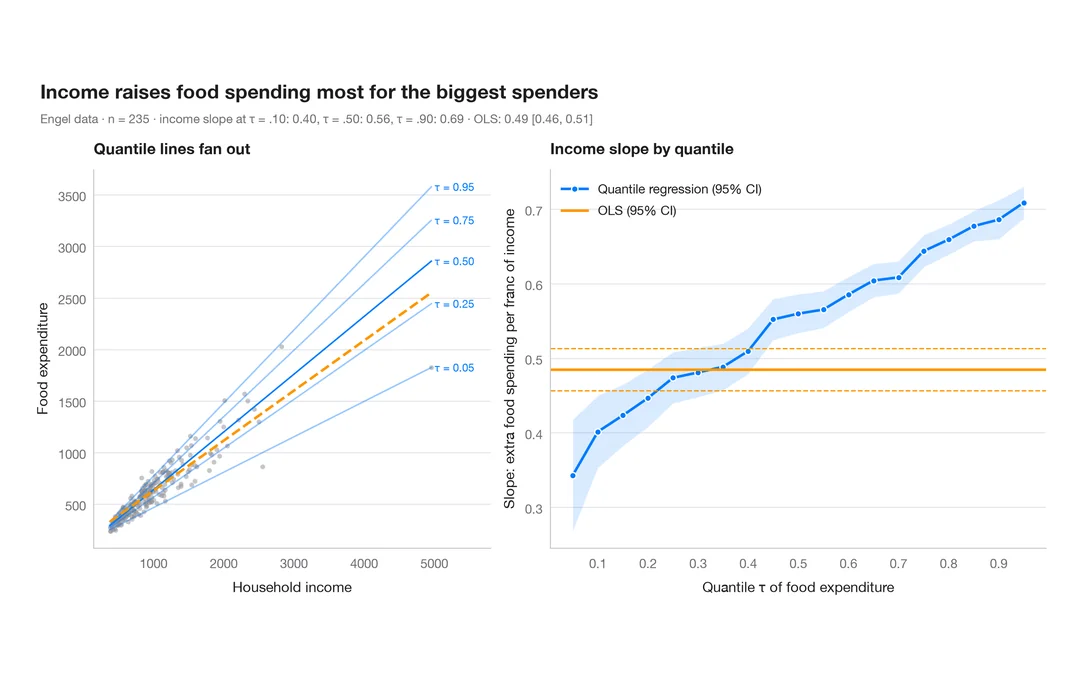
分位数回归过程
斜率如何随条件分布变化,并与单一的 OLS 估计相对照。
quantreg::plot(summary(rq(tau = 1:19 / 20)))模型诊断
残差、杠杆值、校准与 ROC 曲线:先检验,再信任模型。
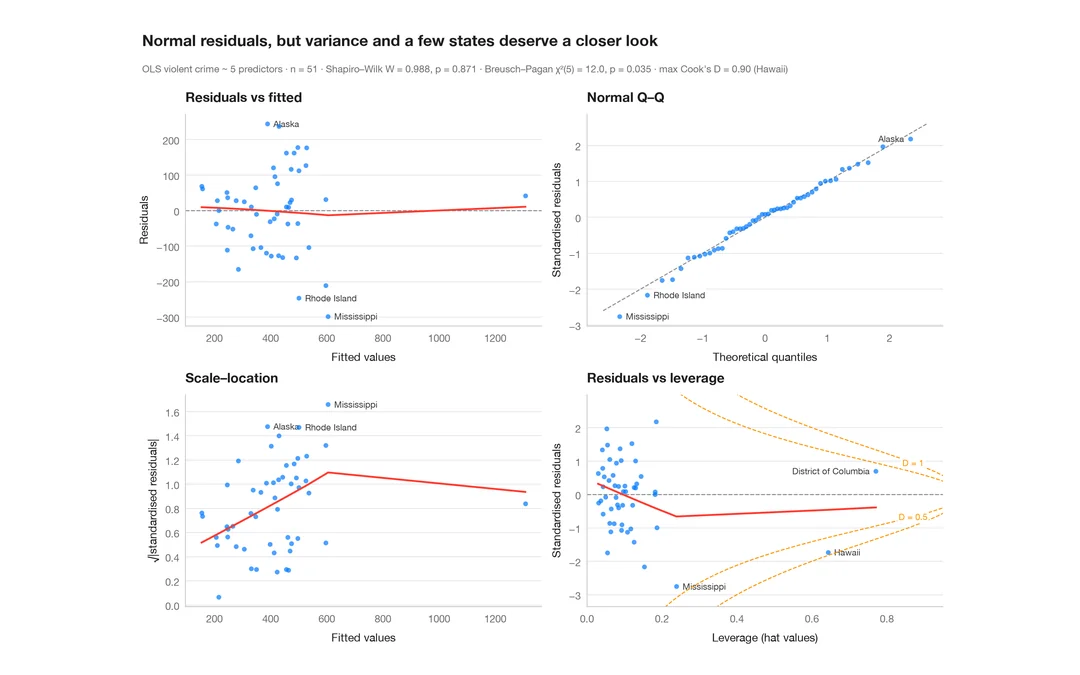
残差诊断
线性模型经典的 2 × 2 诊断图——线性、正态性、方差与杠杆值。
plot(lm) / performance::check_model()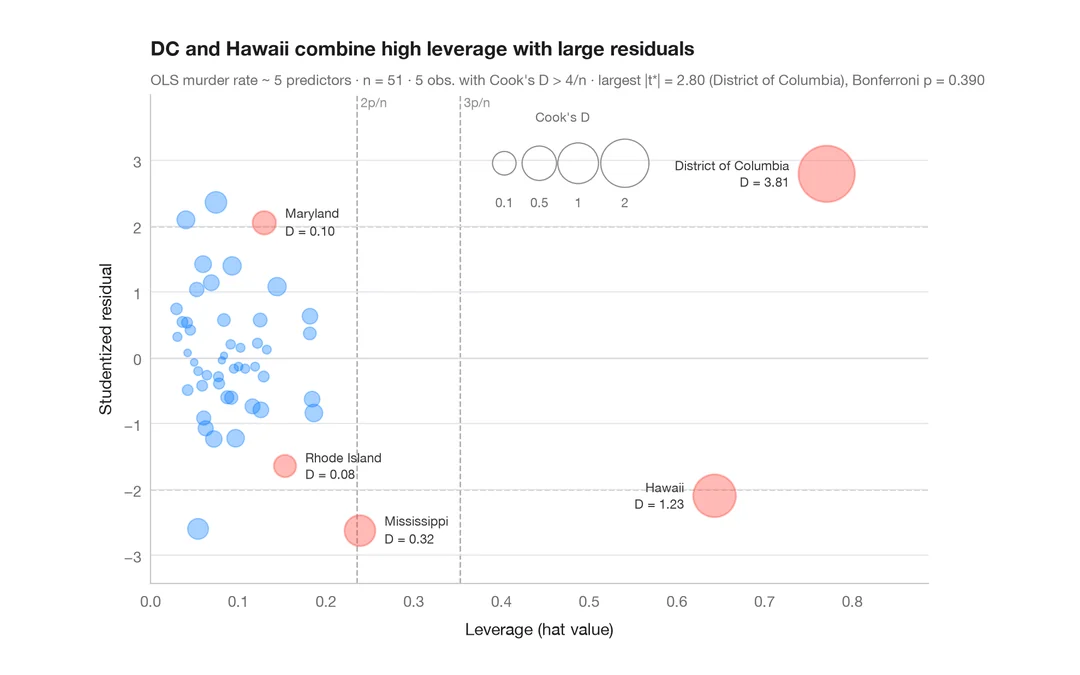
影响图
学生化残差对杠杆值,气泡大小由 Cook 距离决定。
car::influencePlot()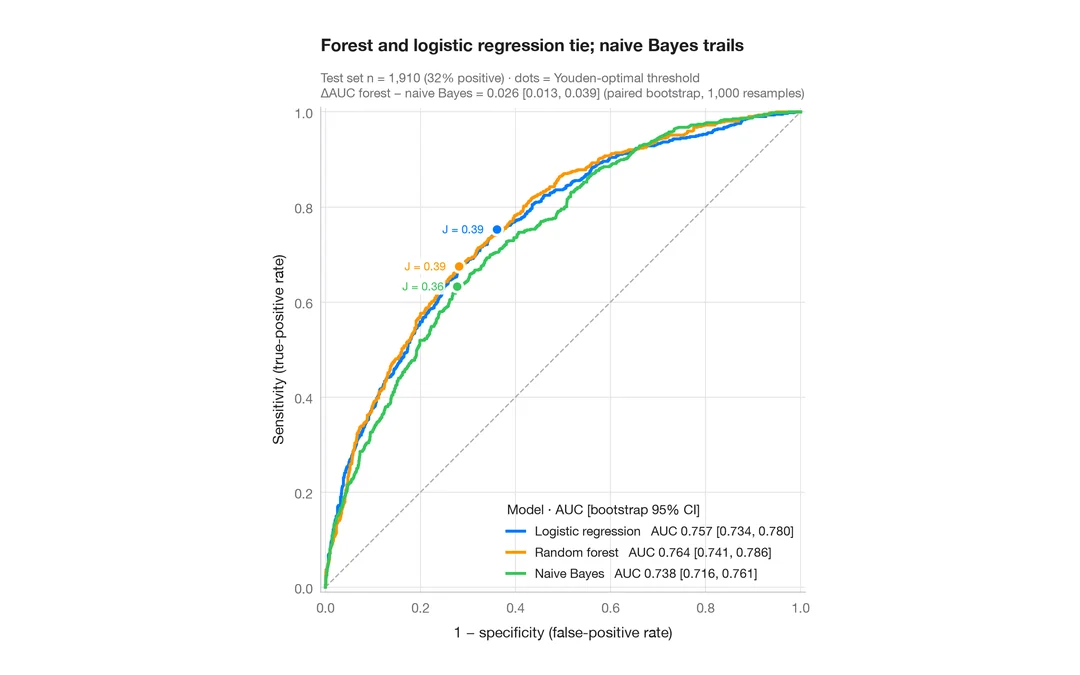
ROC 曲线
以 ROC 曲线、AUC 及其自助法 95% 置信区间和 Youden 点比较三个分类器。
pROC::ggroc() / pROC::ci.auc()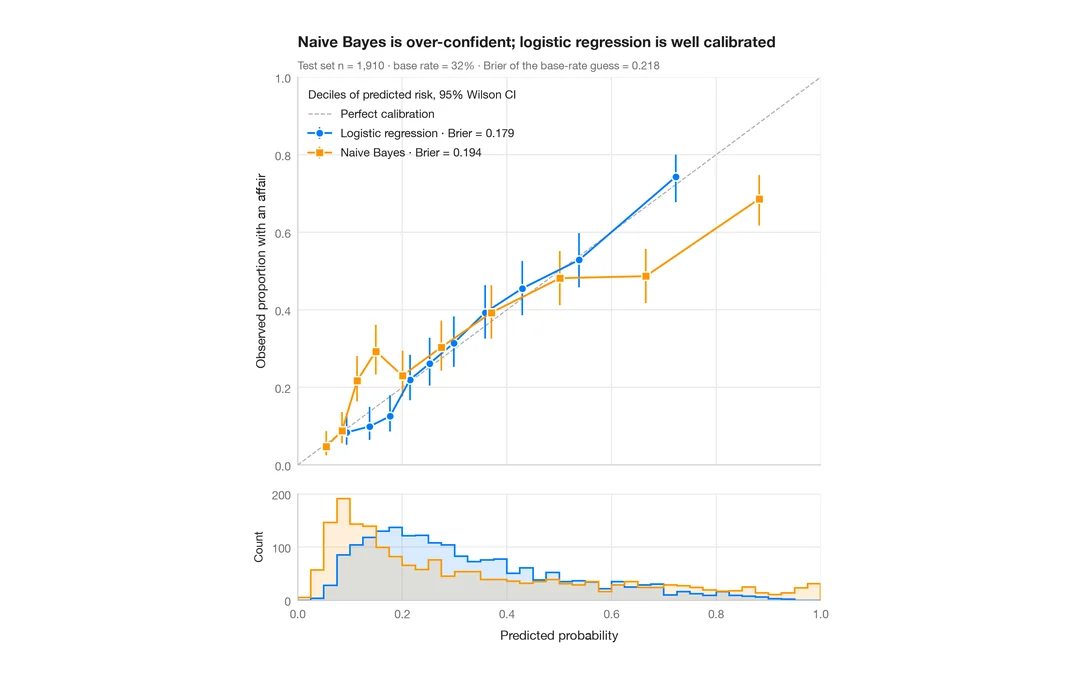
校准图
按十分位分组的预测风险与观测风险,附 Wilson 置信区间、预测值直方图和 Brier 分数。
rms::calibrate() / probably::cal_plot_breaks()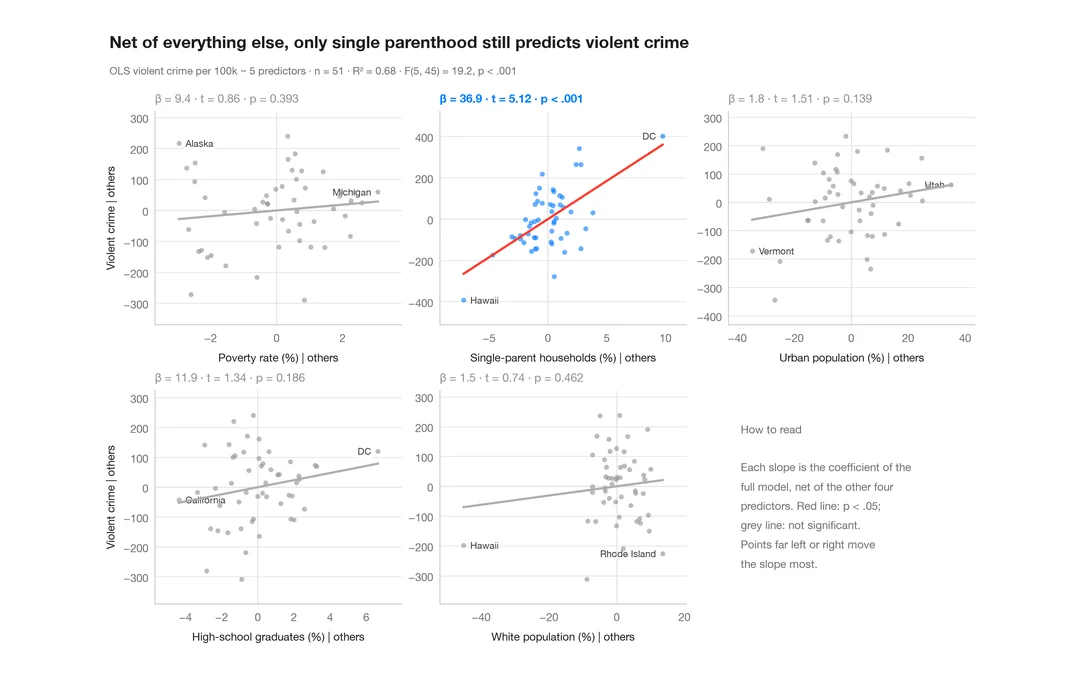
添加变量图
每个预测变量一张偏回归图;每条拟合斜率都等于对应的回归系数。
car::avPlots()生存分析
附风险表的 Kaplan–Meier 曲线、累积风险以及 Cox 模型风险比。
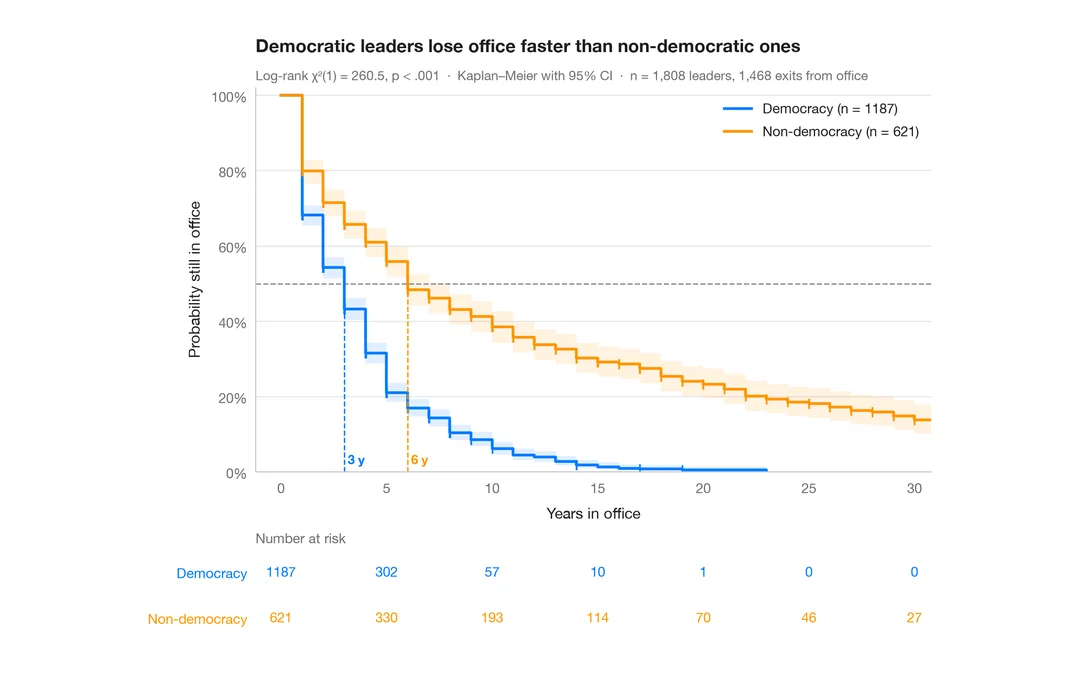
Kaplan–Meier 生存曲线
政治领导人在任多久:民主政体与非民主政体对比——附置信带、删失标记、log-rank 检验和风险人数表的生存曲线。
survminer::ggsurvplot(risk.table = TRUE)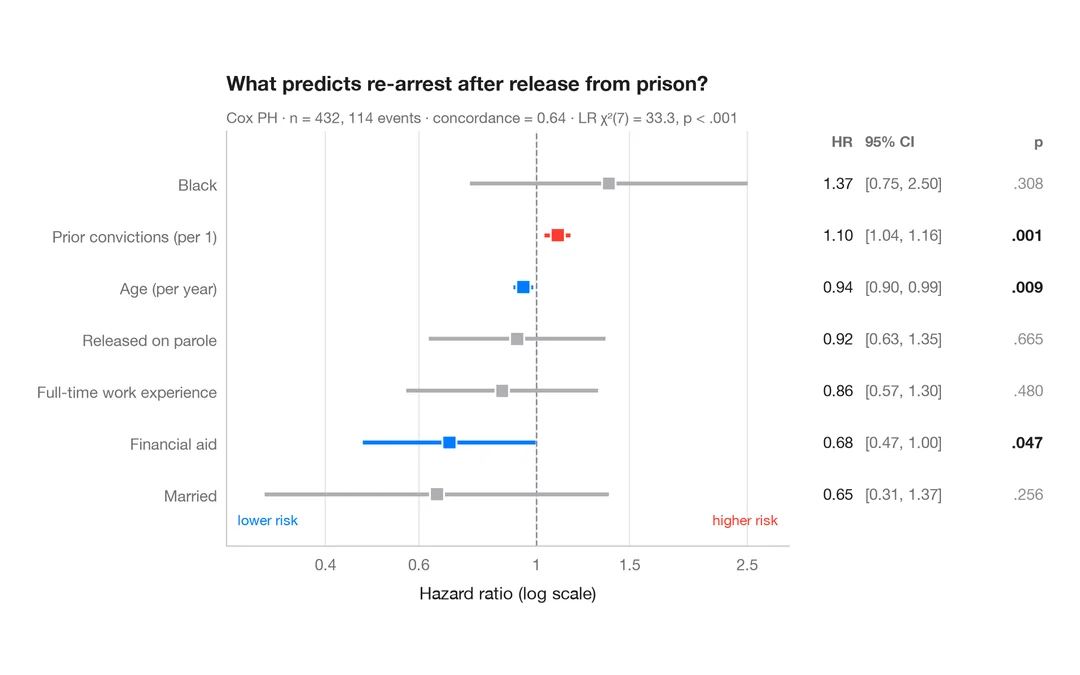
Cox 风险比
Cox 比例风险模型的森林图,附 HR、95% 置信区间和 p 值。
survminer::ggforest()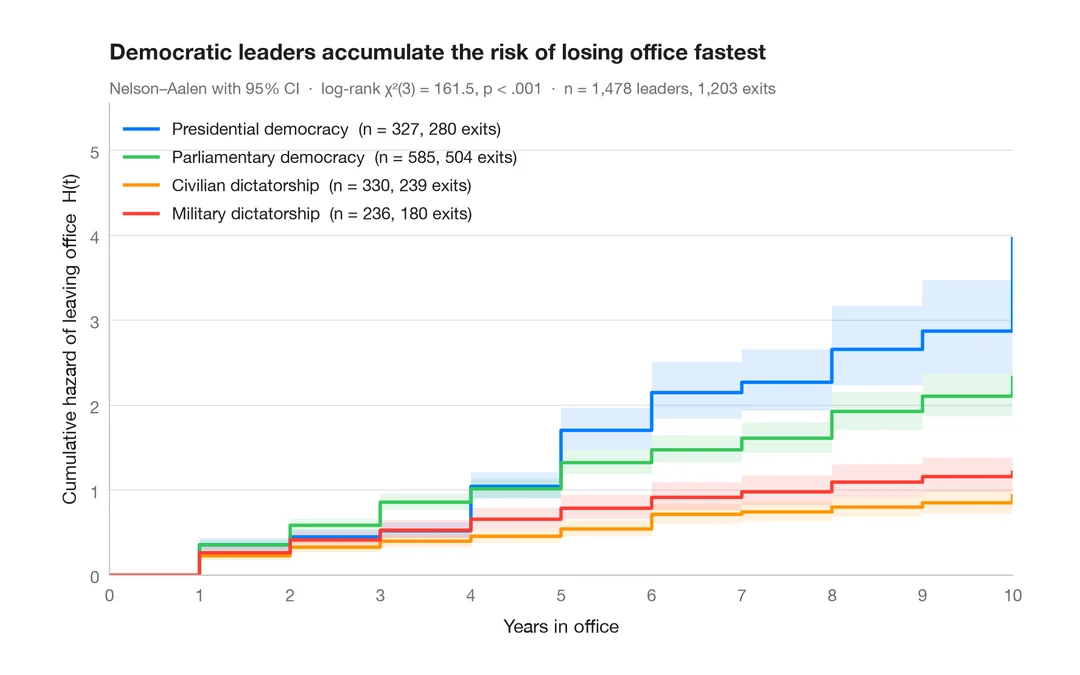
累积风险
四种政治体制下离任的 Nelson–Aalen 累积风险,附 95% 置信带。
survminer::ggsurvplot(fun = "cumhaz")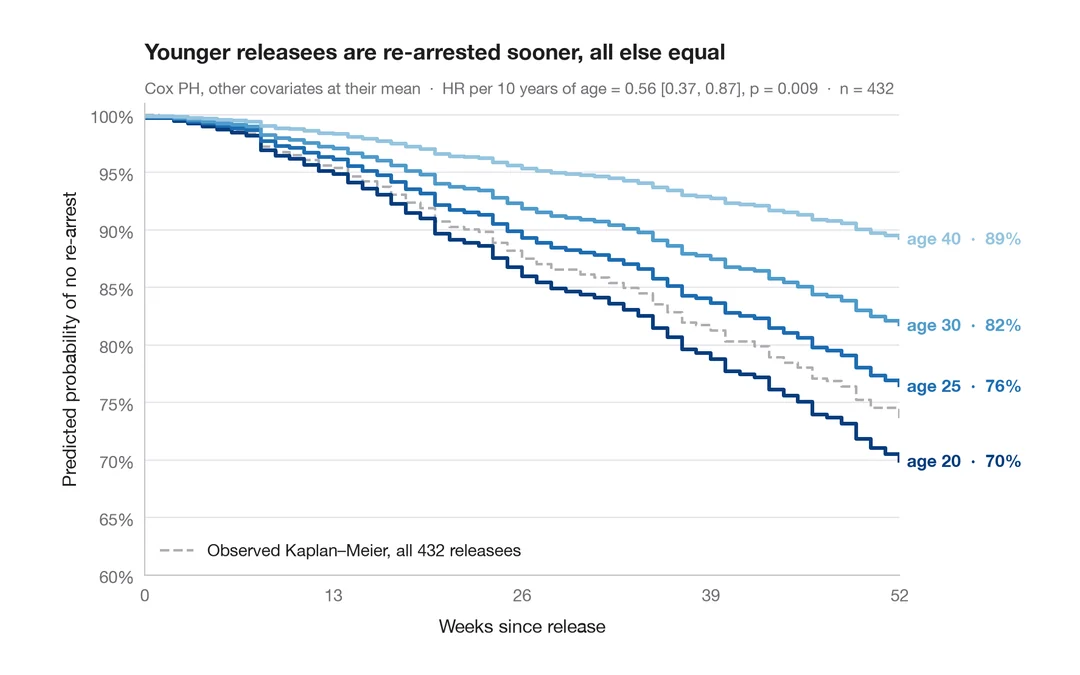
调整后的生存曲线
Cox 模型针对不同年龄预测的生存曲线,其他协变量固定在均值。
survminer::ggadjustedcurves()时间序列
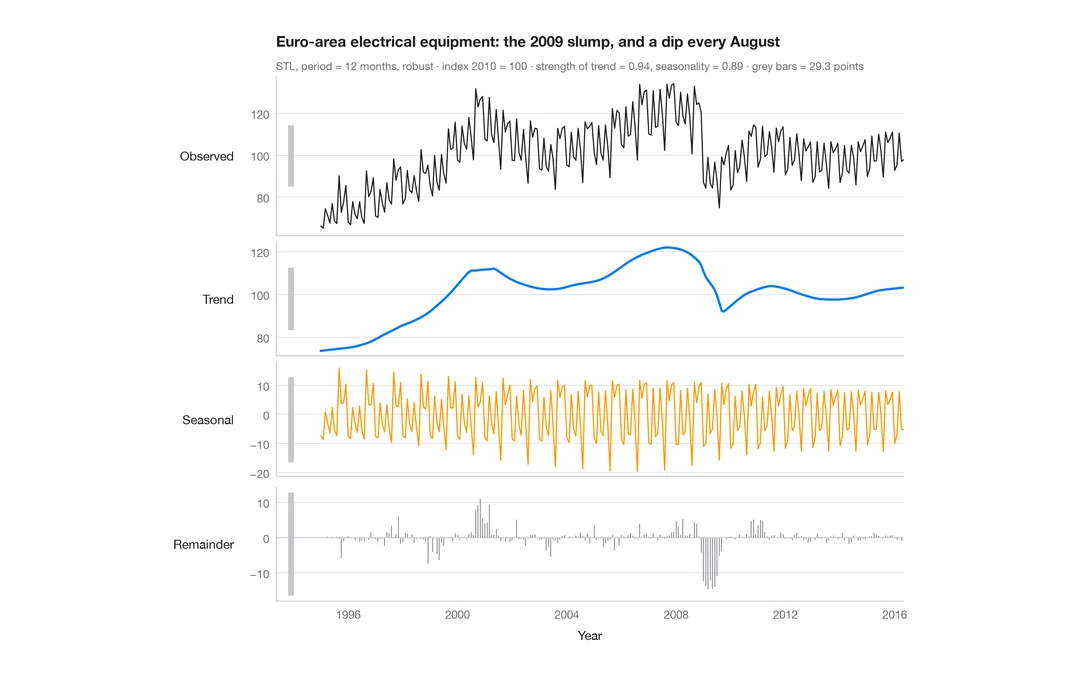
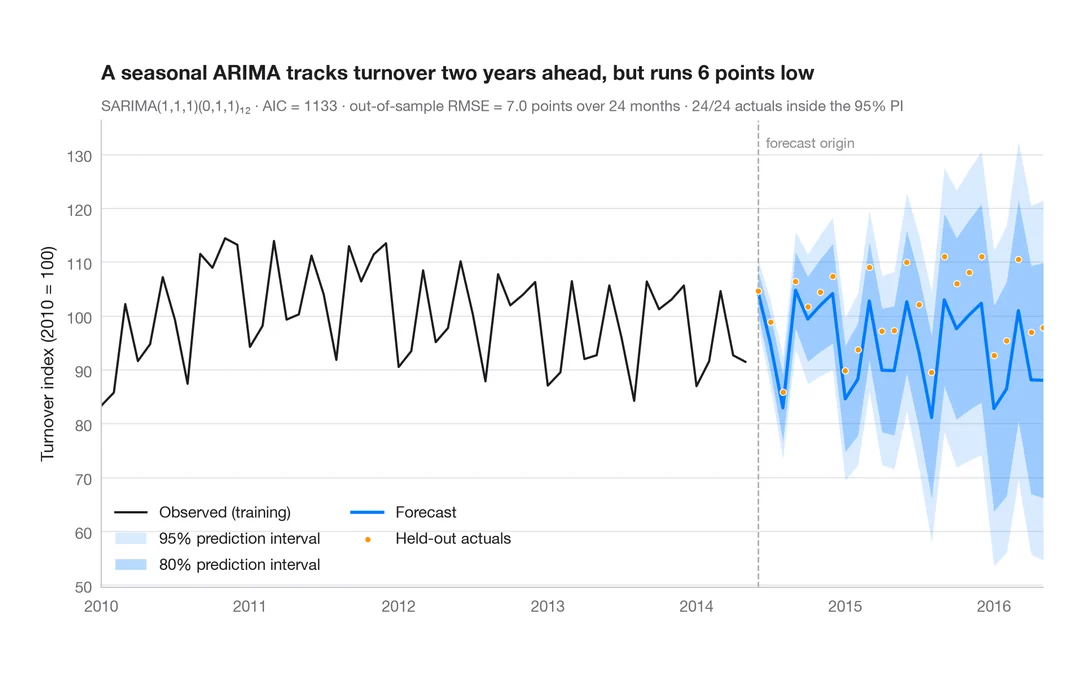
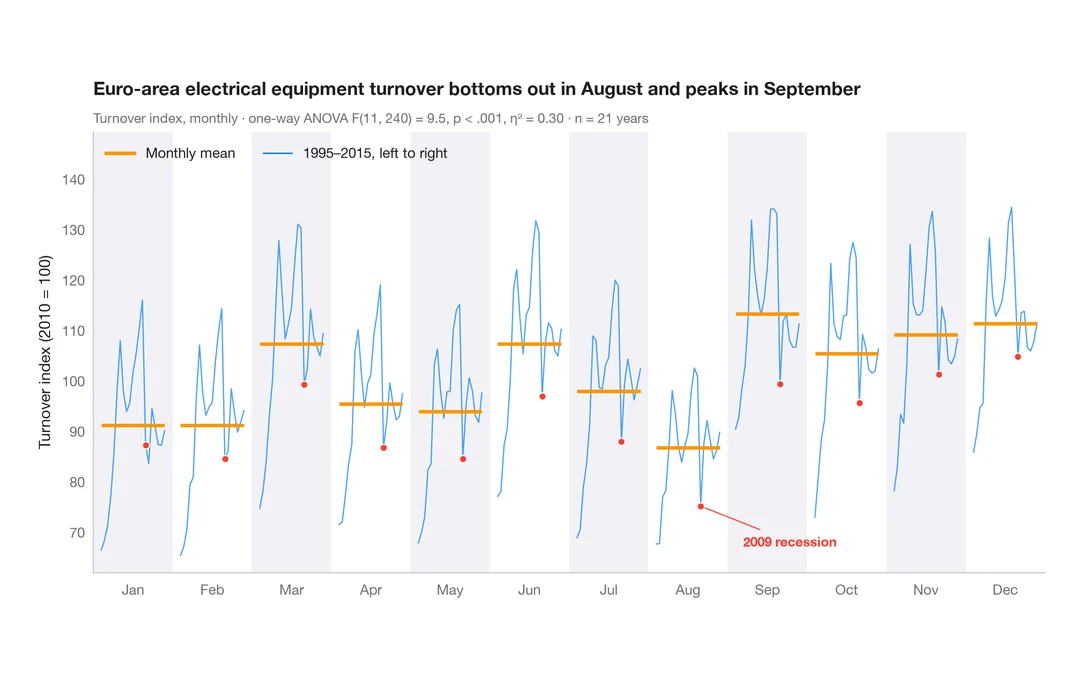
序列分解、自相关、带预测区间的预测以及随时间的变化。
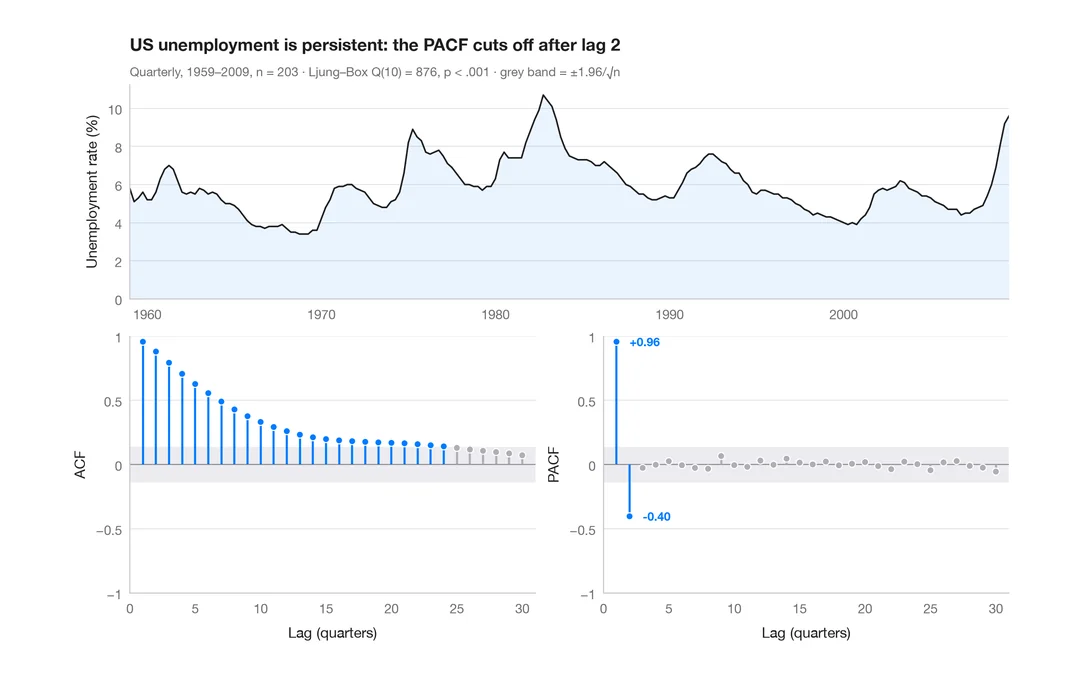
多元分析与聚类
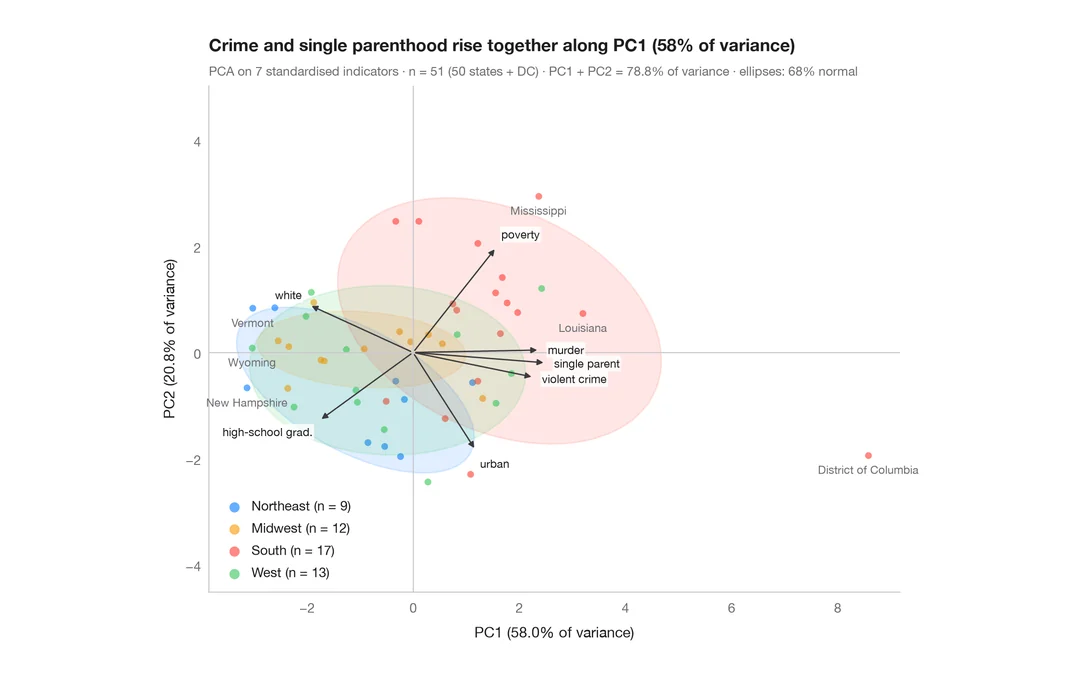
面向高维数据的 PCA 双标图、碎石图、聚类与热图。
PCA 双标图
美国各州及其社会指标在前两个主成分上的位置。
factoextra::fviz_pca_biplot()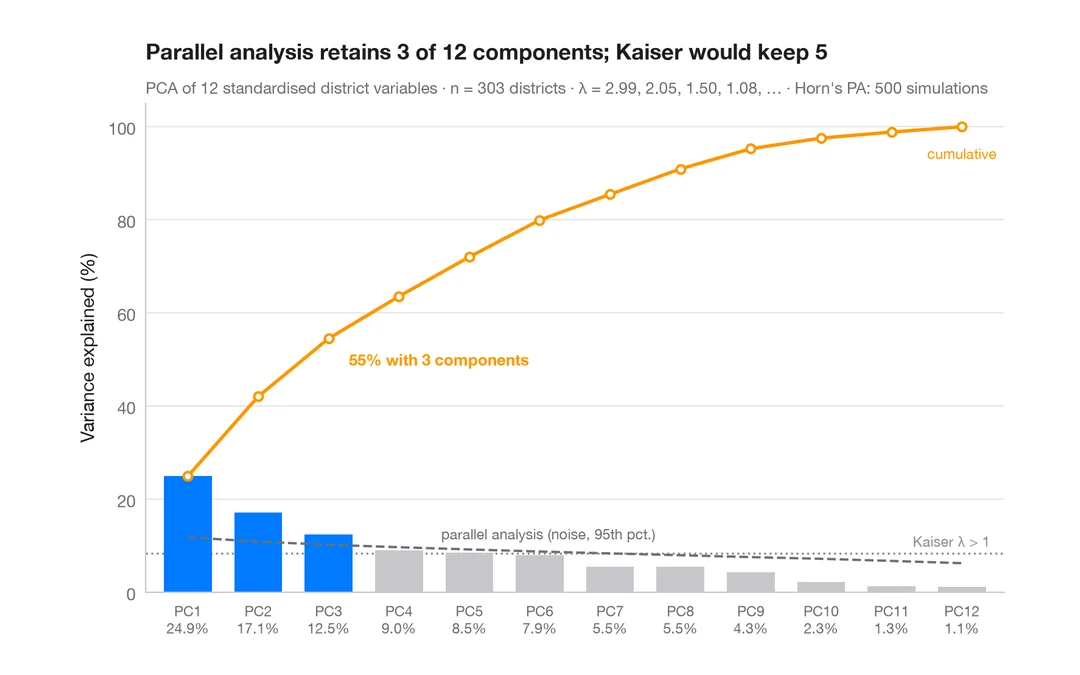
碎石图
描述加州 303 个学区需要几个维度?各主成分的方差及平行分析截断值。
factoextra::fviz_eig()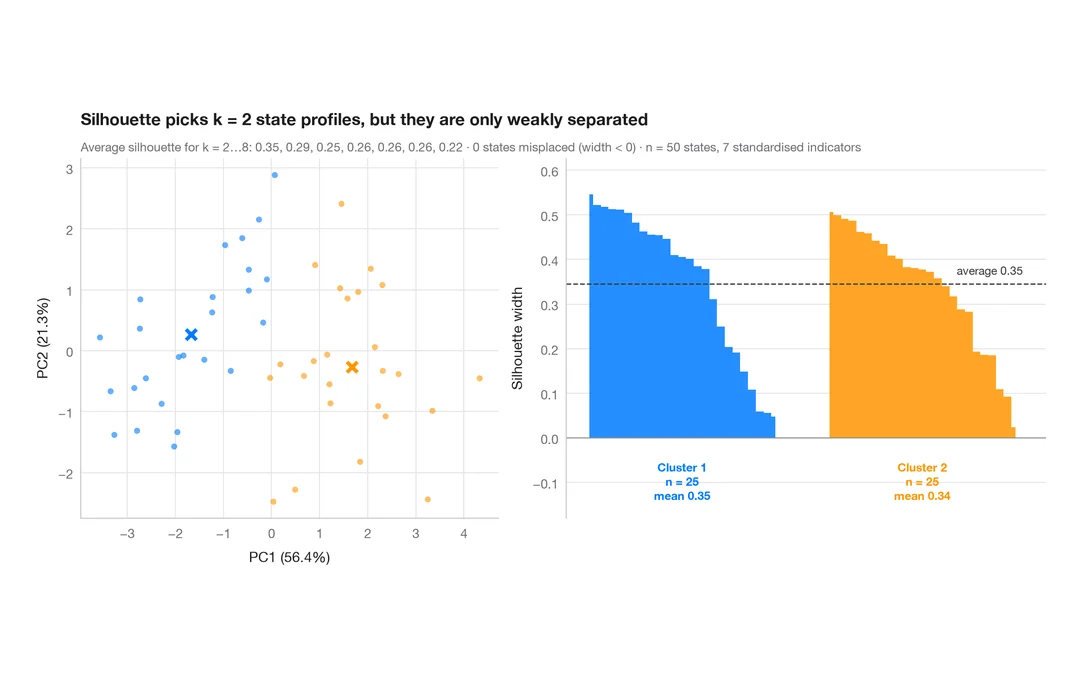
k-means 轮廓图
美国各州是否分成截然不同的社会类型?k-means 聚类及其轮廓宽度。
factoextra::fviz_silhouette()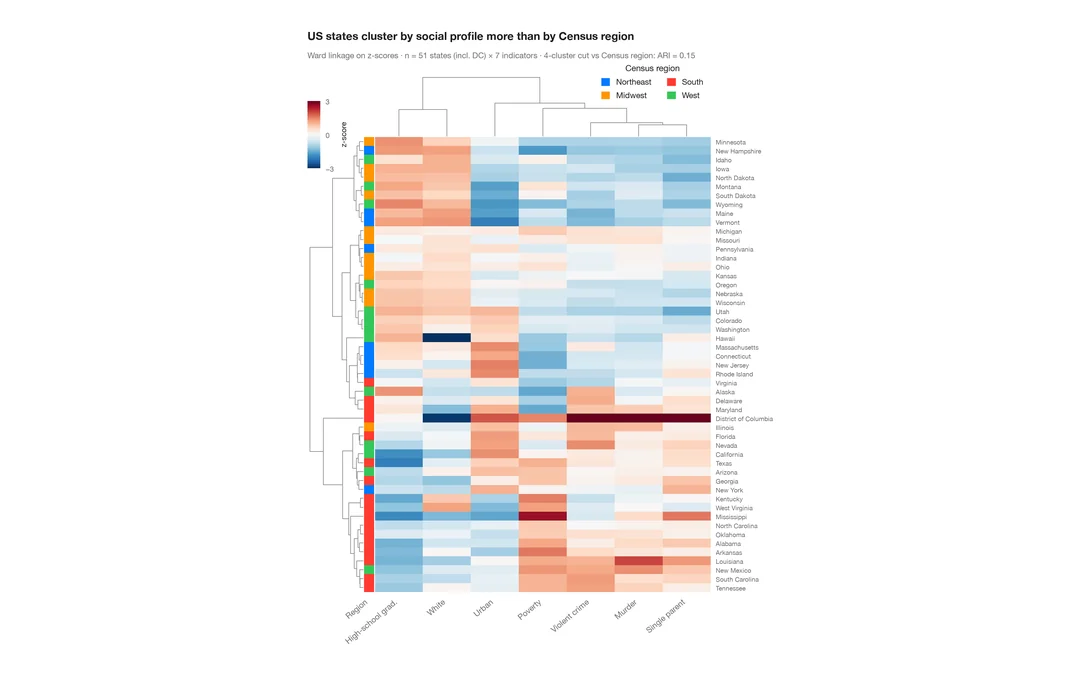
聚类热图
美国各州社会指标的 z 分数热图,带行列树状图和人口普查区域色条。
pheatmap::pheatmap() / ComplexHeatmap::Heatmap()推断与不确定性
自助法(Bootstrap)、置信区间、统计功效、一致性分析与元分析森林图。
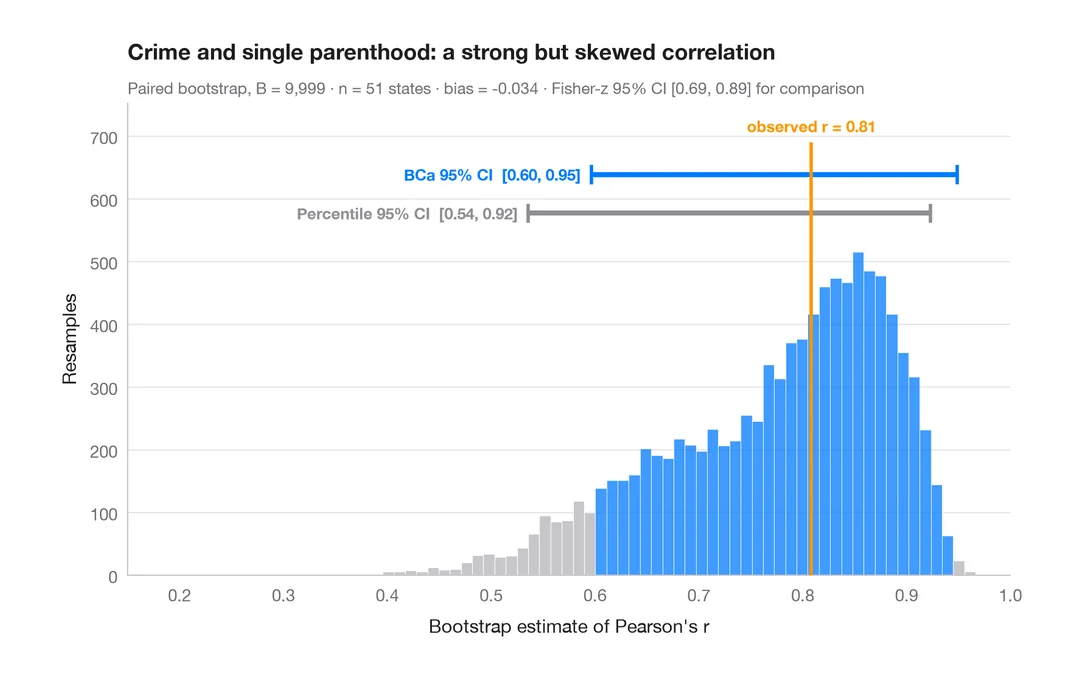
自助法分布
重抽样得到的相关系数,附百分位数法和 BCa 95% 置信区间。
boot::boot() + boot::boot.ci()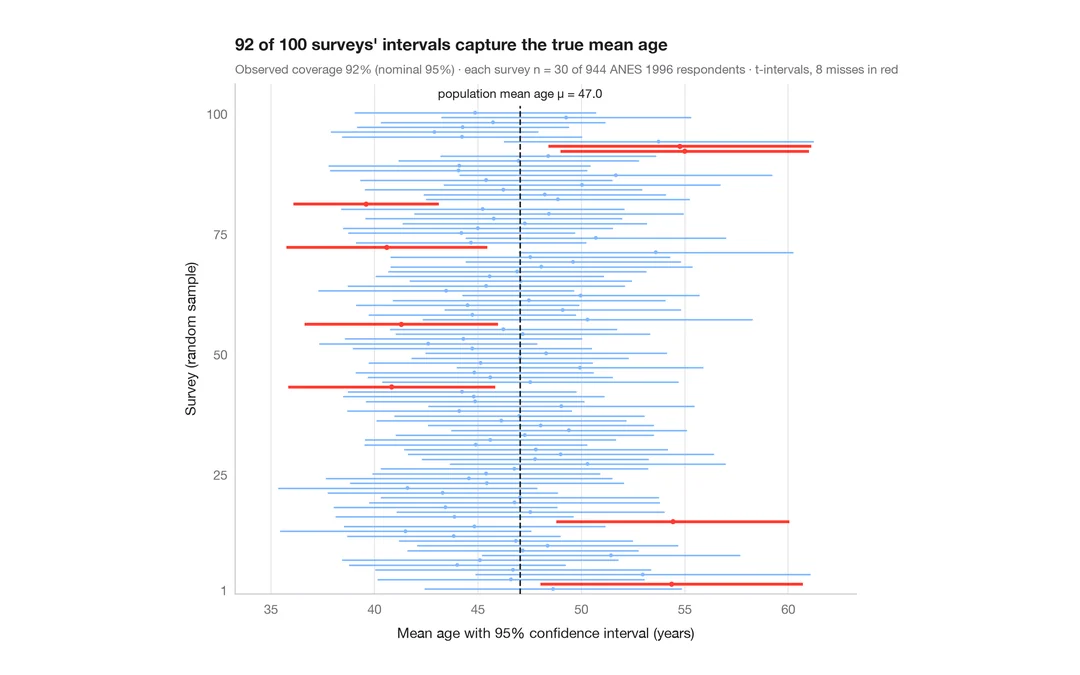
95% 置信区间的含义
从 944 名 ANES 受访者中抽取 30 人,重复调查 100 次;未覆盖真值的平均年龄 95% 置信区间以红色显示。
teaching classic (e.g. TeachingDemos::ci.examp())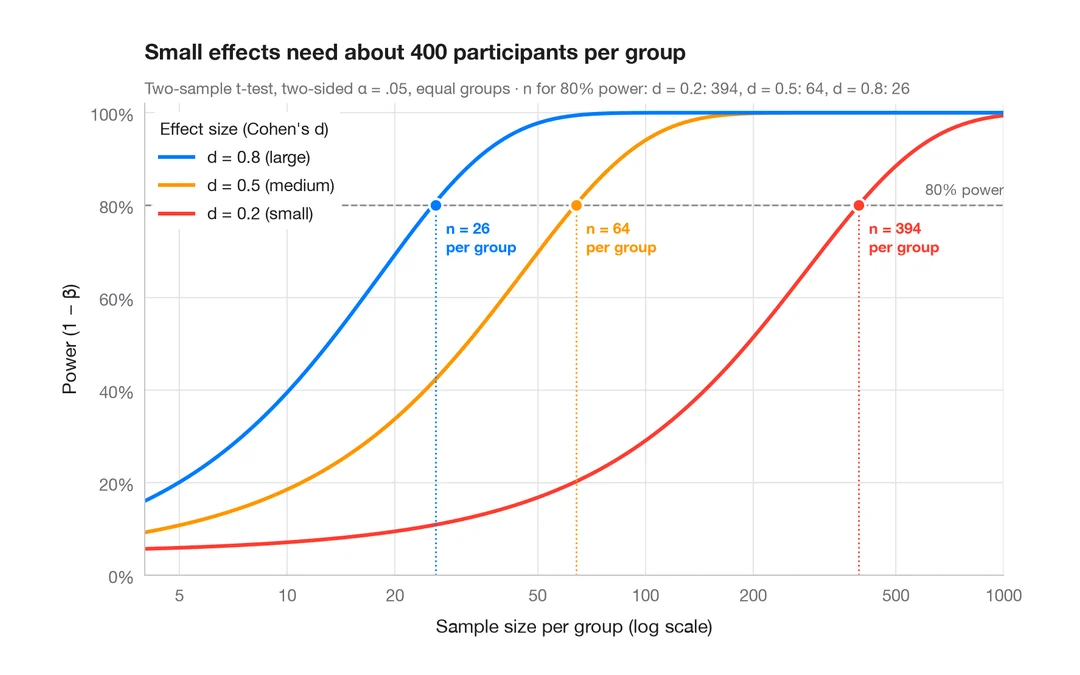
统计功效曲线
小、中、大效应下双样本 t 检验的统计功效随样本量的变化。
pwr::pwr.t.test() + plot()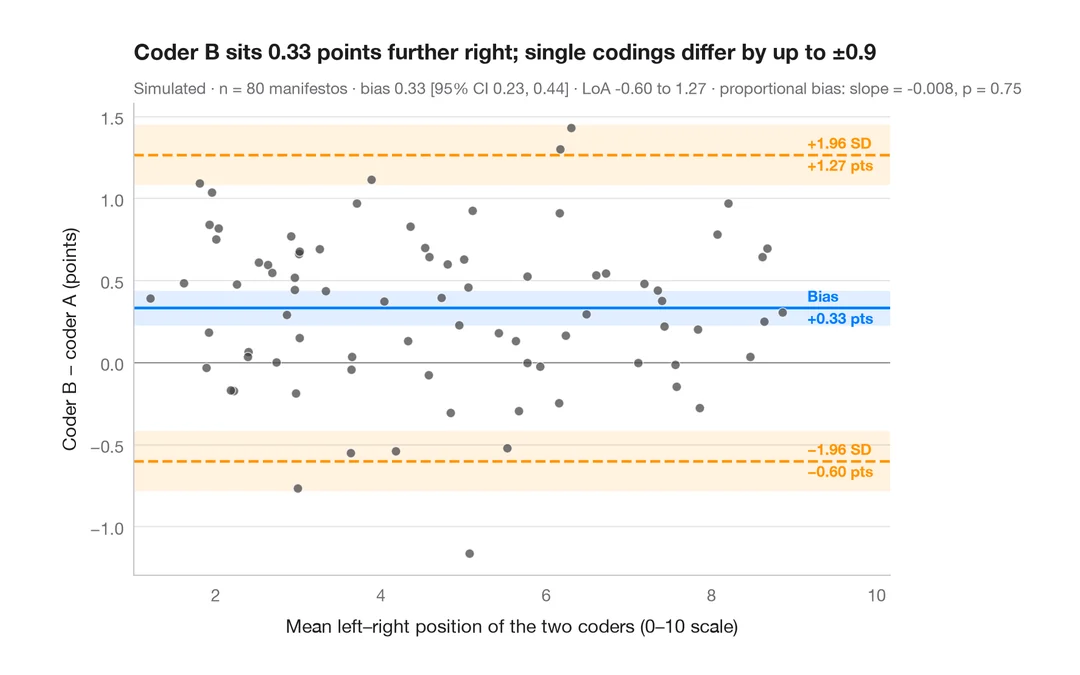
Bland–Altman 图
两位编码员对政党竞选纲领左右立场的定位是否一致?偏差与 95% 一致性界限。
BlandAltmanLeh::bland.altman.plot() / blandr::blandr.draw()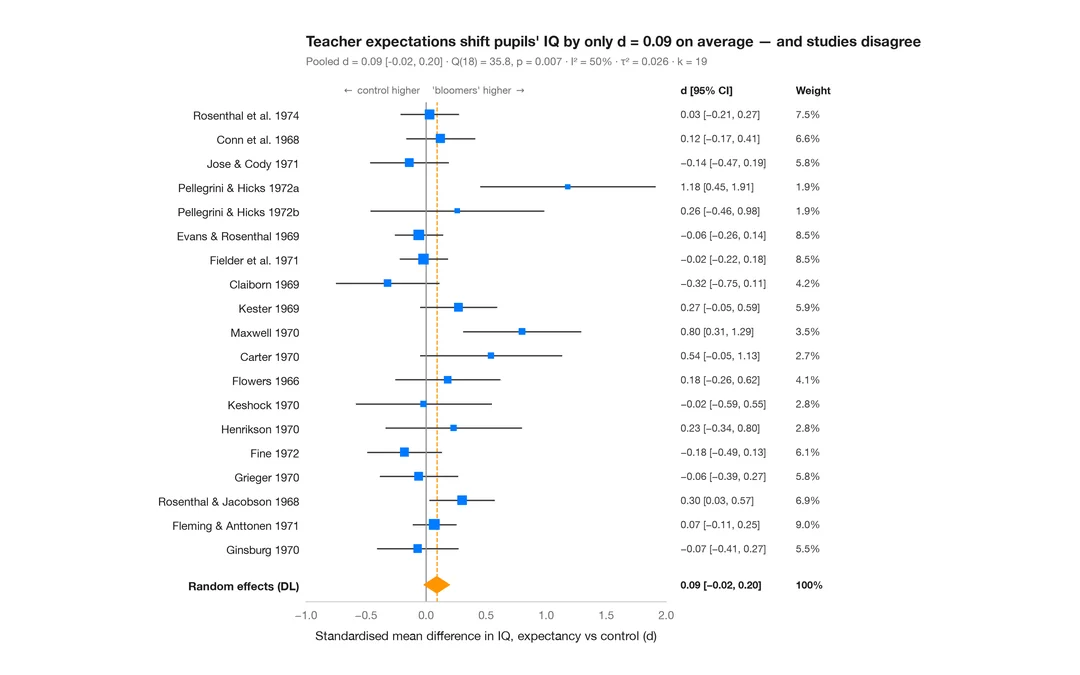
元分析森林图
教师期望能否提高学生的智商?19 项“皮格马利翁”实验、随机效应合并估计菱形与异质性统计量。
meta::forest() / metafor::forest()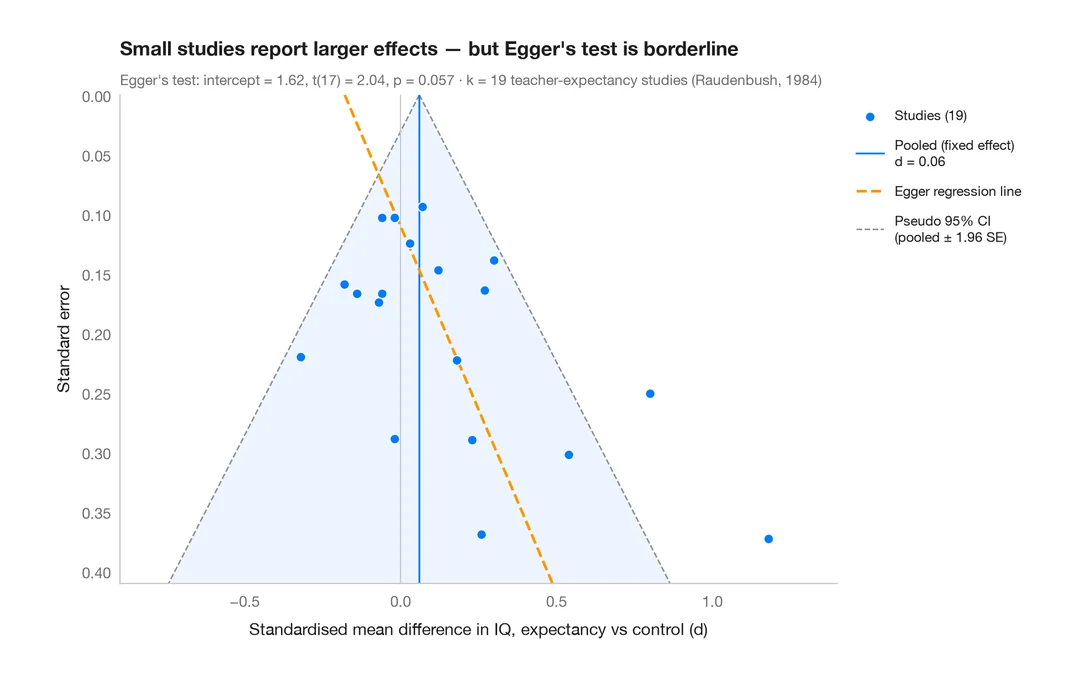
漏斗图
小型“皮格马利翁”研究是否更乐观?19 个教师期望效应对其标准误作图,附伪 95% 漏斗和 Egger 检验。
metafor::funnel() + metafor::regtest()如何引用
PyStatlas 由 Thierry Warin 创建并维护。如果它对你的工作有所帮助,敬请引用。
Warin, T. (2026). PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences. https://warint.github.io/pystatlas/
@misc{warin2026statlas,
  author       = {Warin, Thierry},
  title        = {PyStatlas: A Python Gallery of Statistical Graphics for the Social Sciences},
  year         = {2026},
  howpublished = {\url{https://warint.github.io/pystatlas/}},
  note         = {Source code: https://github.com/warint/pystatlas}
}