机器学习
带指标的混淆矩阵
逻辑回归能多好地预测谁在 1996 年投票给多尔——样本外混淆矩阵,显示计数与行内占比,并为主要指标给出自助法区间。
yardstick::conf_mat() + autoplot()
机器学习
精确率–召回率曲线
两个分类器预测哪些已婚女性报告有婚外情的样本外精确率–召回率曲线,附平均精确率与无技能基线。
yardstick::pr_curve() + autoplot()
机器学习
学习曲线
随训练集增大的训练准确率与交叉验证准确率,比较两个预测哪些已婚女性报告有婚外情的模型。
caret::learning_curve_dat() + ggplot()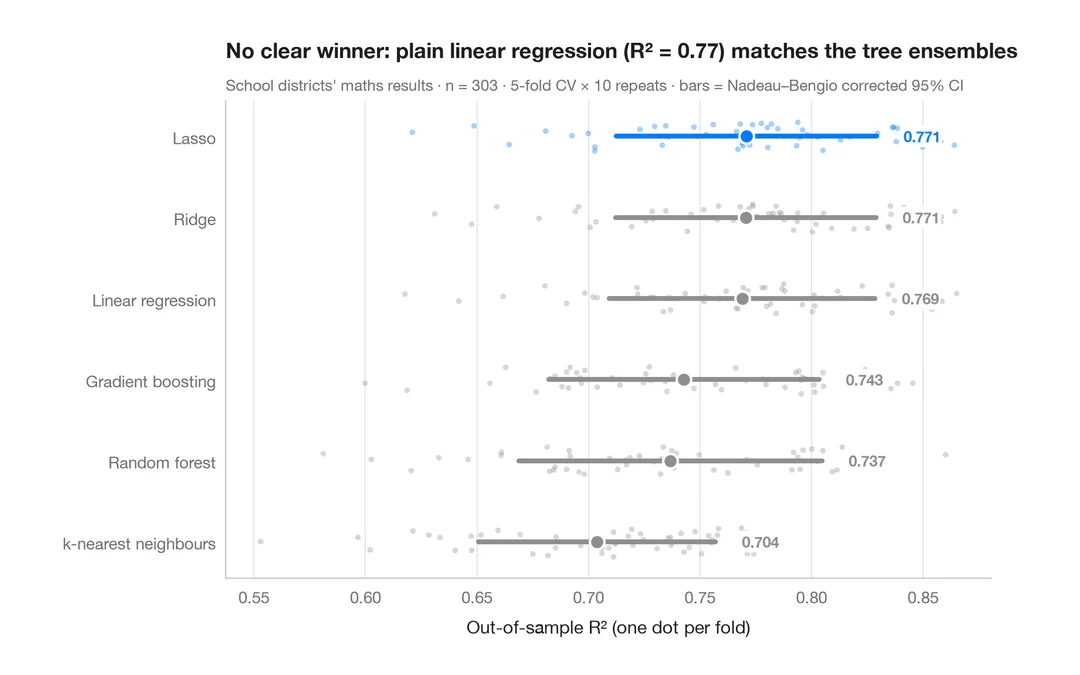
机器学习
交叉验证模型比较
六个模型预测加利福尼亚州学区数学成绩的逐折 R²,附均值与校正后的 95% 区间。
caret::resamples() + bwplot() / tune::autoplot()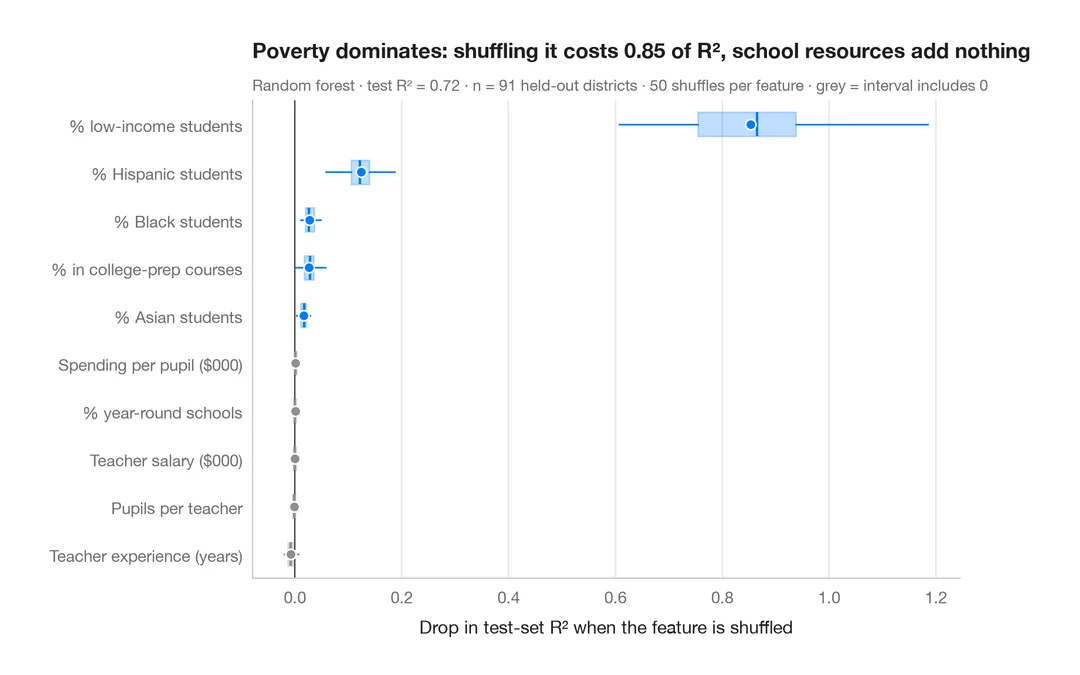
机器学习
置换重要性
随机森林预测数学成绩时依赖哪些学区特征——逐个打乱每项特征时测试集 R² 的下降。
vip::vip(method = "permute")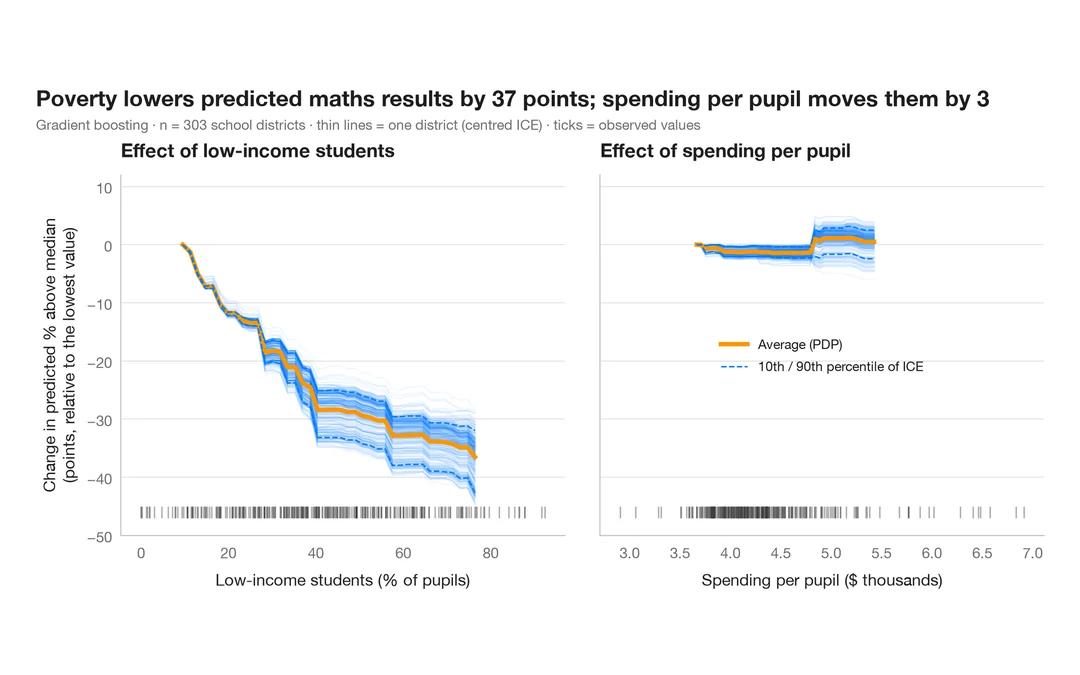
机器学习
带 ICE 曲线的部分依赖图
预测的数学成绩如何随贫困程度和生均支出变化——平均值(PDP)叠加在每个学区一条的个体曲线(ICE)之上。
pdp::partial(ice = TRUE) + autoplot() / iml::FeatureEffect进阶:SHAP 解释
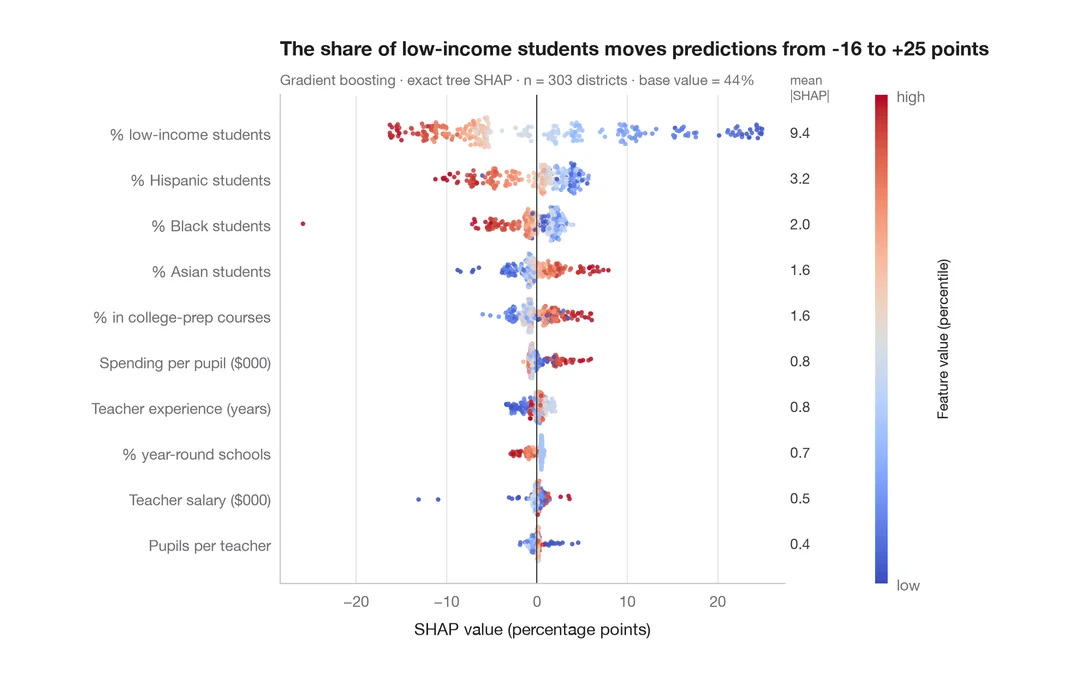
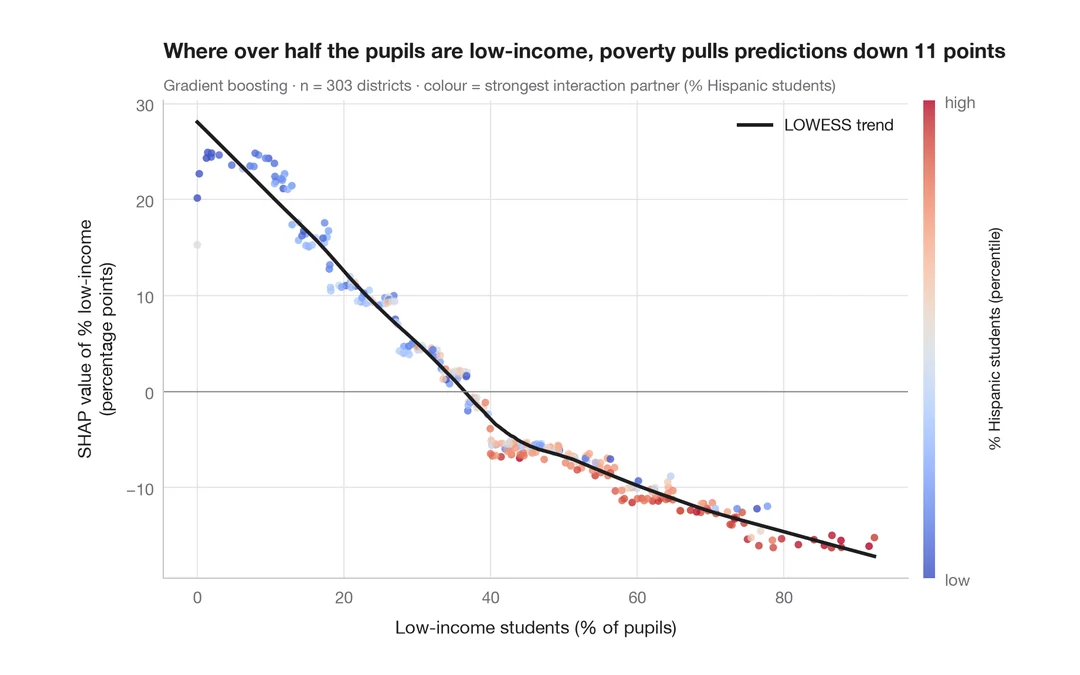
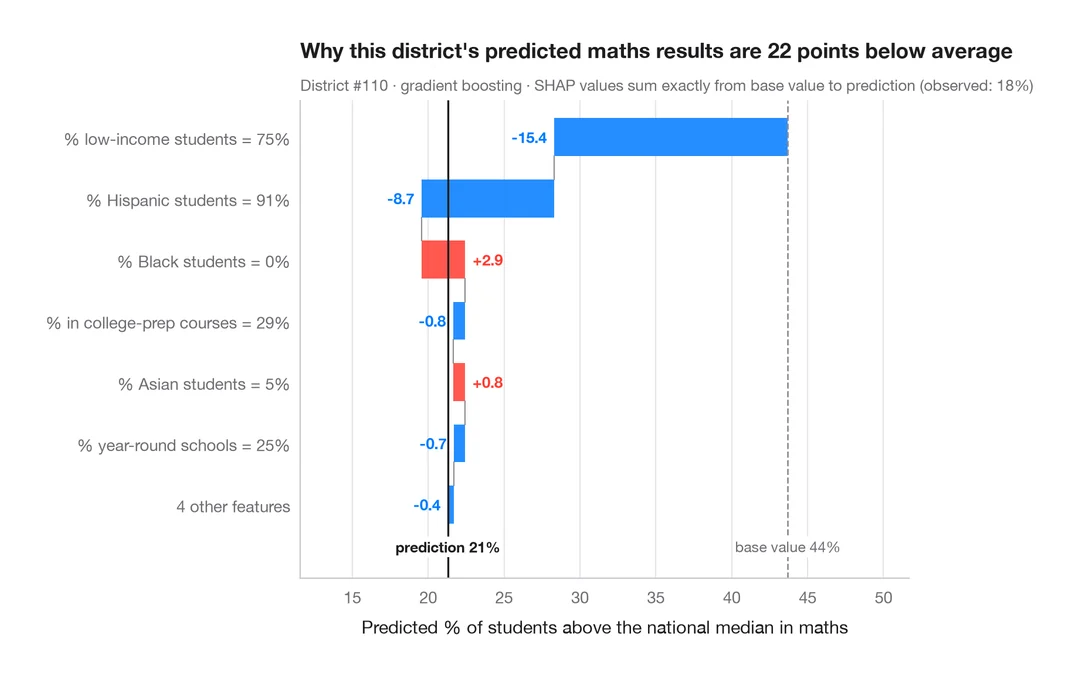
Shapley 值将每个预测分解为各特征的可加贡献——从全局、逐个特征,到单个个案。